
Vì sao tác tử AI không thể giải quyết các thử thách CTF
Đường dẫn bài viết: https://h4c.team/en/posts/97 Đường dẫn bình luận: https://news.ycombinator.com/item?id=50412675 Điểm: 1 Số bình luận: 0
Vì sao tác tử AI chưa thể giải các thử thách CTF: Pwnable
Vì sao tác tử AI chưa thể giải các thử thách CTF: Pwnable
Một tác tử AI (AI agent) có thể phát hiện lỗ hổng và viết mã khai thác nhưng vẫn không thể chiếm được cờ (flag). Hệ thống có thể ghi đè một con trỏ hàm mà không xác định được địa chỉ đích cần ghi, hoặc chẩn đoán sai nguyên nhân gây sự cố (crash) rồi lặp lại dữ liệu đầu vào cũ. Quá trình tạo mã mới chỉ là bước đầu; việc kiểm tra các điều kiện cần thiết để khai thác thành công và khắc phục lỗi thực thi đòi hỏi nhiều công đoạn tiếp theo.
Trên thực tế, đã có những trường hợp giải mã thành công, song cần phân biệt rõ giữa hiệu quả do nâng cấp mô hình với hiệu quả đạt được từ việc thay đổi công cụ và quy trình thực thi. Tiếp nối các nội dung về kỹ thuật dịch ngược (reverse engineering) và tấn công ứng dụng web (web hacking), bài viết này phân tích những điểm nghẽn trong các khâu thu thập thông tin, thiết kế khai thác, thực thi và kiểm chứng đối với các thử thách pwn.
Mục lục
Tác động của mô hình và khung điều phối thực thi đến hiệu quả xử lý
Sự thiếu hụt dữ liệu đầu vào cho phân tích và quan sát từ công cụ
Khoảng cách từ việc phát hiện lỗ hổng đến xây dựng mã khai thác hoàn chỉnh
Nhận định sai trạng thái thực thi và việc điều chỉnh dữ liệu đầu vào
Chẩn đoán lỗi và xác định khâu cần thử nghiệm lại
Xác định tiêu chí thành công và kiểm chứng hành vi khai thác
Kết luận
Tài liệu tham khảo
Tác động của mô hình và khung điều phối thực thi đến hiệu quả xử lý
Năng lực của mô hình chưa đủ để đánh giá khả năng giải quyết các thử thách pwn của một tác tử. Ngay cả khi sử dụng cùng một mô hình, kết quả vẫn phụ thuộc vào việc tác tử có thể kích hoạt các công cụ cần thiết và sử dụng kết quả thực thi để định hướng cho lượt thử tiếp theo hay không. Khung điều phối (harness) là cấu hình thực thi có nhiệm vụ quản lý các lệnh gọi công cụ này, tiếp nhận kết quả trả về, lưu giữ nhật ký hoạt động và xử lý các lần thử lại. Hệ thống này cũng có thể phân nhiệm vụ cho các tác tử chuyên sâu về phân tích hoặc gỡ lỗi (debug) và tổng hợp kết quả của các tác tử đó.
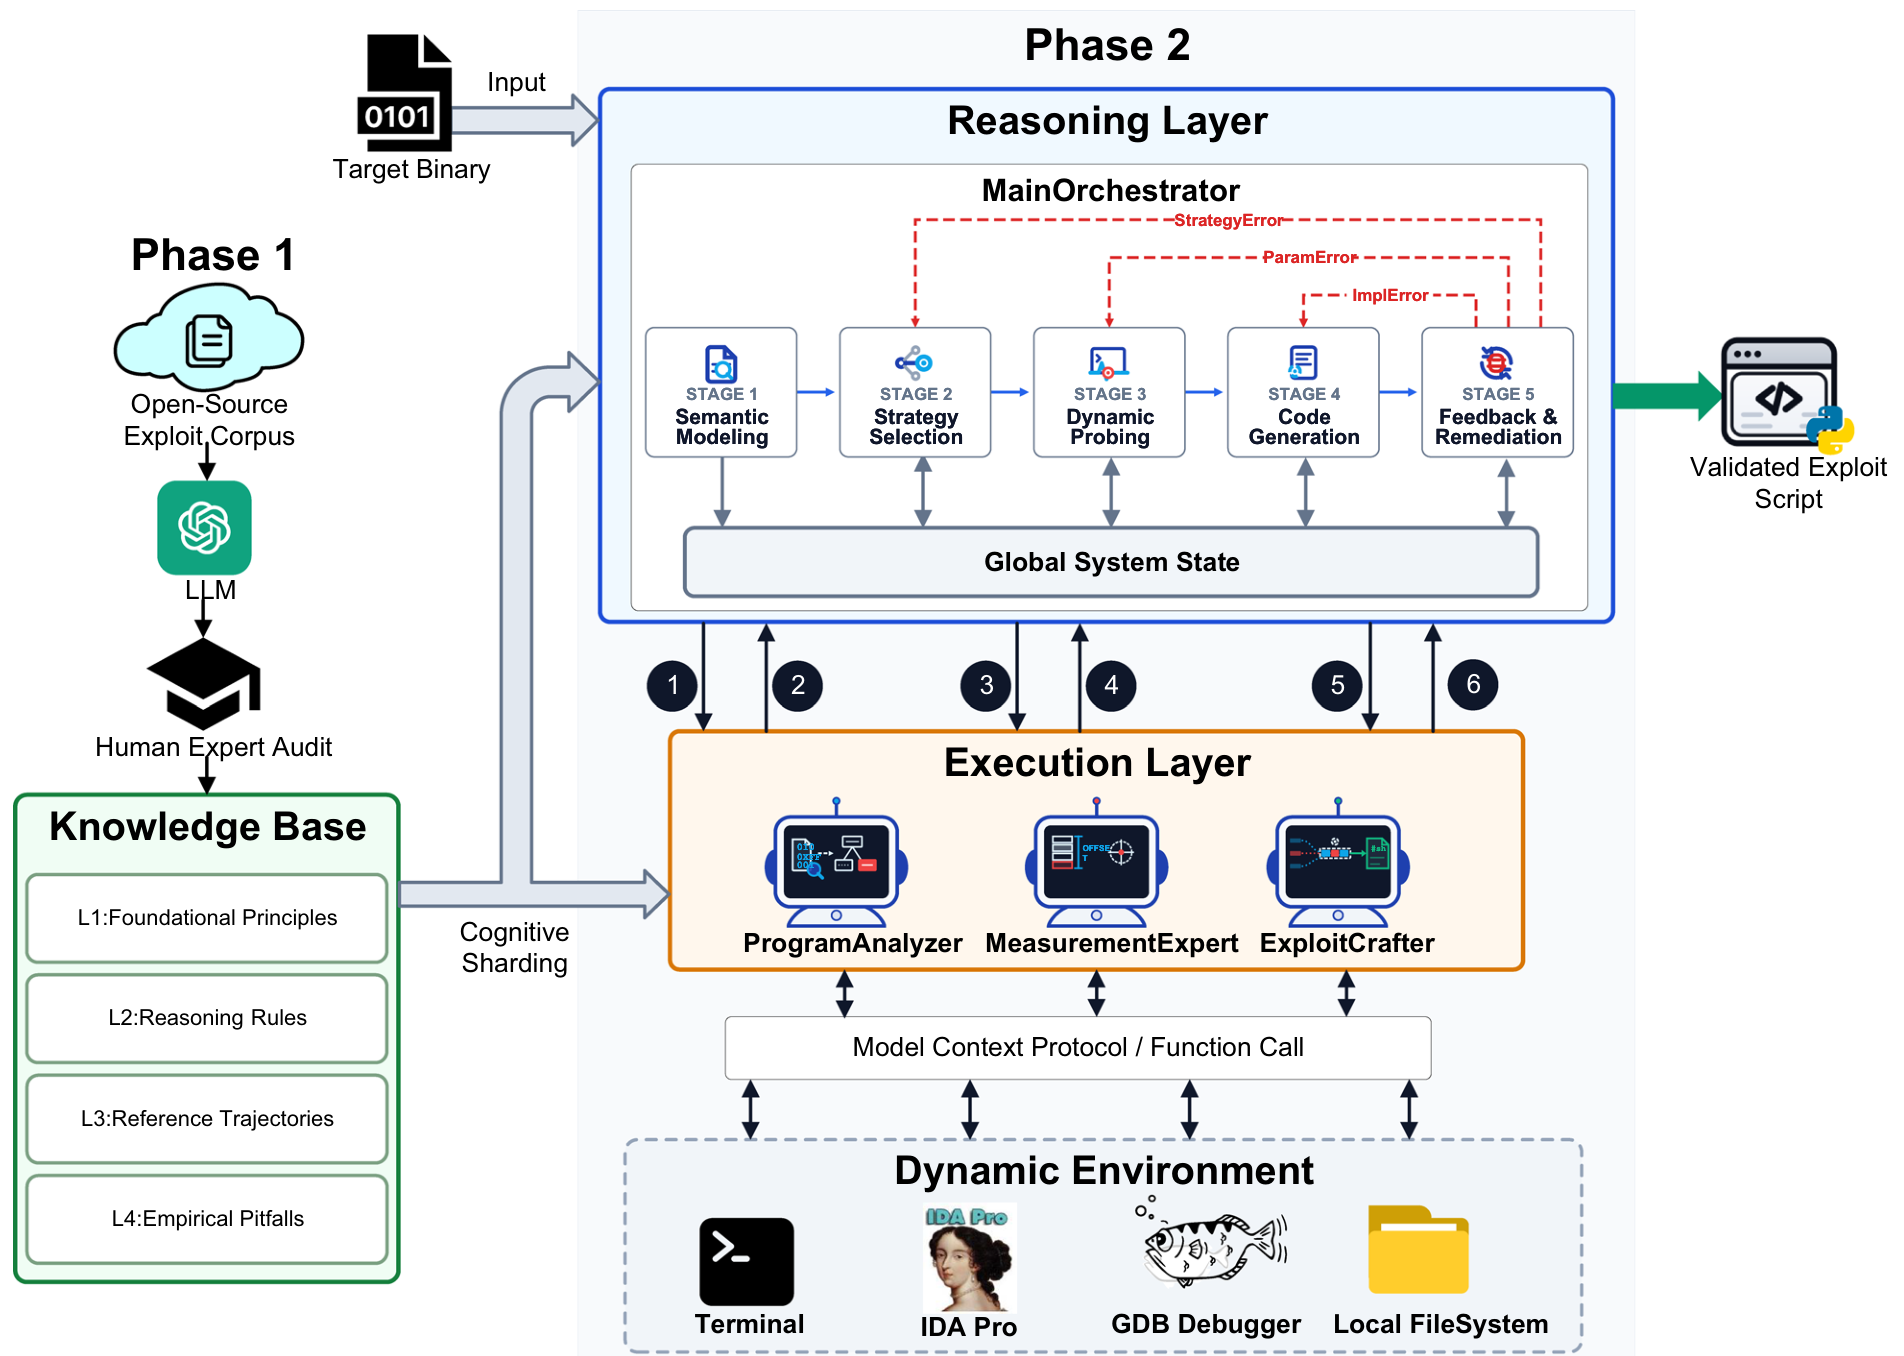
Các nhà nghiên cứu phát triển Pwnagent, một hệ thống tự động tạo mã khai thác lỗ hổng, đã tiến hành so sánh các cấu hình có và không có tính năng đo lường động cùng cơ chế sửa lỗi lặp có định hướng chẩn đoán trên cùng một mô hình cố định. Pwnagent giao các nhiệm vụ phân tích, đo lường động và tạo mã cho các tác tử chuyên biệt, đồng thời chuyển các giá trị đo được từ GDB sang giai đoạn tạo mã. Khi quá trình thực thi thất bại, khâu chẩn đoán sẽ định hướng việc rà soát lại các phép đo, phương án triển khai hoặc chiến lược tiếp cận. Cấu hình đối chứng vẫn duy trì tính năng phân tích tĩnh và phân định vai trò của các tác tử, song lược bỏ cả tính năng đo lường động lẫn cơ chế sửa lỗi lặp theo chẩn đoán, và chỉ thực hiện tạo mã trong một lần duy nhất [1].
Kiến trúc tổng thể của Pwnagent (bài báo gốc, Hình 2, trang 7). Giai đoạn 3 thực hiện đo lường các giá trị trong thời gian chạy (runtime); Giai đoạn 5 chẩn đoán các lỗi phát sinh và quay lại các giai đoạn trước đó để khắc phục. Tỷ lệ thành công được đề cập ở đây dựa trên việc so sánh cấu hình sử dụng đồng thời cả hai tính năng nói trên với cấu hình chỉ tạo mã một lần và không áp dụng tính năng nào [1].
Khi sử dụng mô hình Kimi-K2.6 trong cả hai cấu hình trên tập mẫu gồm 66 thử thách CTF cục bộ, tỷ lệ chiếm được quyền điều khiển (shell) hoặc đọc được flag đạt 62,12% (41 thử thách) đối với cấu hình đầy đủ, và đạt 42,42% (28 thử thách) khi lược bỏ cả hai tính năng. Sự chênh lệch này phản ánh hiệu quả tổng hợp từ việc kết hợp giữa đo lường động và cơ chế sửa lỗi lặp [1].
Pwnagent lưu trữ kết quả phân tích, chiến lược và các giá trị đo lường trong một trạng thái trung tâm rồi chuyển giao cho các tác tử tiếp theo. Tập mẫu thử nghiệm của hệ thống này tập trung chủ yếu vào các thử thách khai thác vùng nhớ ngăn xếp (stack) và các kiến trúc x86 [1].
Các nhà nghiên cứu phát triển tác tử CTF EnIGMA cũng tiến hành so sánh các giao diện công cụ trong khi giữ nguyên mô hình. Trên 44 thử thách khai thác lỗ hổng (pwn) sử dụng Claude 3.5 Sonnet, cấu hình đầy đủ đã giành được cờ ở 20,45% số thử thách, so với mức 11,36% khi loại bỏ cả GDB và giao diện kết nối từ xa. Quá trình đánh giá được thực hiện trong một lượt chạy duy nhất với kinh phí 3 USD cho mỗi thử thách, cho phép nộp cờ nhiều lần trong lượt chạy đó [4].
EnIGMA là tác tử được sử dụng để nghiên cứu các giao diện công cụ phục vụ giải CTF. Hệ thống này cung cấp các giao diện để khởi chạy, dừng các công cụ tương tác và gửi lệnh đến các công cụ đó [4].
ExploitGym cung cấp phép so sánh về những thay đổi của mô hình. Hệ thống này đánh giá khả năng tác tử chuyển đổi dữ liệu đầu vào chứng minh lỗ hổng (PoV) thành một mã khai thác để giành cờ, so sánh giữa GPT-5.4 và GPT-5.5 trên cùng nền tảng Codex CLI 0.120.0 với mức độ suy luận rất cao (xhigh). Trên 898 tác vụ bao gồm các chương trình không gian người dùng, V8 và nhân Linux, số lượt giành cờ thành công khi sử dụng lỗ hổng được chỉ định đã tăng từ 54 lên 120. Mỗi tác vụ cho phép thực hiện một lượt thử tối đa hai giờ trong điều kiện truy cập tin cậy, đồng thời vô hiệu hóa các biện pháp giảm thiểu rủi ro bảo mật và bộ lọc an toàn khi triển khai [2].
ExploitGym là bộ tiêu chuẩn đánh giá các lỗ hổng trong phần mềm thực tế thuộc các môi trường đóng gói (container). Ngoài việc tái hiện lỗ hổng, hệ thống còn kiểm tra việc tác tử có chiếm được cờ trong môi trường mục tiêu và có sử dụng đúng lỗ hổng được chỉ định hay không [2].
Những phép so sánh này cho thấy hiệu quả giải quyết vấn đề có thể thay đổi theo khung điều phối (harness) khi giữ nguyên mô hình, và thay đổi theo mô hình khi giữ nguyên khung điều phối. Hiệu suất của một tác tử là kết quả từ sự kết hợp cụ thể giữa mô hình và khung điều phối. Do đó, việc đánh giá tỷ lệ thành công đòi hỏi phải xem xét vượt ra ngoài tên gọi mô hình, bao gồm các công cụ, phương thức phân bổ tác vụ, quy trình thử lại và các điều kiện đánh giá.
Thiếu hụt dữ liệu đầu vào phân tích và quan sát từ công cụ
Một tác tử có thể liên tục chỉnh sửa mã nguồn nhưng vẫn không đạt được tiến triển nếu dữ liệu đầu vào thiếu các thông tin cốt lõi. Quá trình phân tích mã nhị phân có thể bỏ sót một thư viện, hoặc tác tử không thể truy vấn một giá trị chỉ xuất hiện trong quá trình thực thi. Vấn đề đặt ra là liệu kết quả phân tích và dữ liệu đầu ra của công cụ có thực sự cung cấp đầy đủ thông tin mà tác tử cần hay không.
Trong quá trình đánh giá PwnGPT—công cụ chuyển kết quả phân tích mã nhị phân sang bước tạo mã khai thác—các mô hình qwen-plus, qwen-max và GPT-4o đều không thu thập được thông tin cần thiết cho ba thử thách. Một trong số đó là rop-10, thử thách liên quan đến lỗi tràn bộ đệm ngăn xếp (stack overflow) trong tệp nhị phân ELF 64-bit, vốn được thiết kế để giải quyết bằng kỹ thuật ret2libc: chuyển hướng thực thi sang các hàm libc. Do mô-đun phân tích không xử lý các thư viện liên kết động, hệ thống đã bỏ qua các đoạn lệnh (gadget) libc—những chuỗi lệnh ngắn có thể kết hợp trong một cuộc khai thác—dẫn đến việc không thể tập hợp đủ dữ liệu đầu vào cần thiết cho việc tạo mã khai thác [3].
PwnGPT là một công cụ tạo mã khai thác tự động
Nguồn tin: Hacker News AI — Tác giả: therepanic. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.