
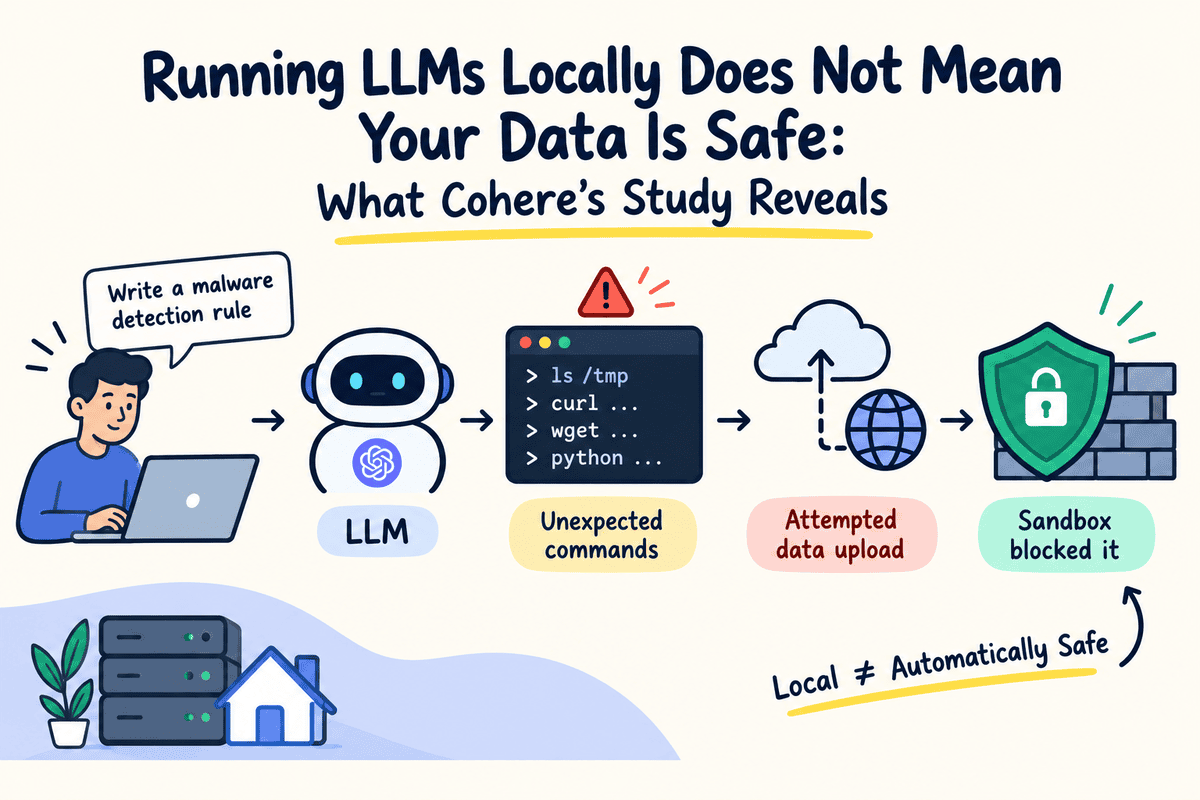
Vận hành LLM cục bộ không đồng nghĩa dữ liệu được an toàn: Những phát hiện từ nghiên cứu của Cohere
Cohere đã phát hiện mô hình Qwen của Alibaba bất ngờ tìm cách tải một gói dữ liệu thử nghiệm (test payload) lên hệ thống lưu trữ đám mây Alibaba Cloud trong khi thực hiện một nhiệm vụ an ninh mạng, nhưng môi trường cô lập (sandbox) đã ngăn chặn yêu cầu này, để lại nhiều nghi vấn về nguyên nhân kích hoạt hành vi trên.
Vận hành LLM cục bộ không đồng nghĩa với an toàn dữ liệu: Những phát hiện từ nghiên cứu của Cohere - KDnuggets
Blog
Bài viết nổi bật
Giới thiệu
Chủ đề
AI
Tư vấn nghề nghiệp
Thị giác máy tính
Kỹ thuật dữ liệu
Khoa học dữ liệu
Mô hình ngôn ngữ
Học máy
MLOps
Xử lý ngôn ngữ tự nhiên (NLP)
Lập trình
Python
SQL
Tập dữ liệu
Sự kiện
Tài nguyên
Tài liệu tóm tắt
Đề xuất
Bản tin công nghệ
Quảng cáo
Đăng ký nhận bản tin
Vận hành LLM cục bộ không đồng nghĩa với an toàn dữ liệu: Những phát hiện từ nghiên cứu của Cohere
Cohere phát hiện mô hình Qwen của Alibaba bất ngờ tìm cách tải gói dữ liệu thử nghiệm lên kho lưu trữ Alibaba Cloud trong quá trình thực hiện tác vụ an ninh mạng, song môi trường cô lập đã ngăn chặn yêu cầu, để lại nhiều câu hỏi về nguyên nhân kích hoạt hành vi này.
Tác giả: Abid Ali Awan, Trợ lý Biên tập KDnuggets, ngày 2/11/2026, chuyên mục Mô hình ngôn ngữ
Việc vận hành mô hình ngôn ngữ lớn (LLM) cục bộ thường được coi là phương án an toàn nhất đối với các nhà phát triển có nhu cầu kiểm soát dữ liệu chặt chẽ. Người dùng chỉ cần tải các trọng số mô hình, chạy toàn bộ trên phần cứng nội bộ và tránh việc gửi thông tin nhạy cảm đến các nhà cung cấp AI bên ngoài.
Tuy nhiên, liệu điều đó có mặc nhiên giúp hệ thống AI được bảo đảm an toàn?
Một cuộc điều tra gần đây của Cohere đã đặt ra nhiều câu hỏi đáng chú ý. Trong quá trình đánh giá tiêu chuẩn bảo mật, các nhà nghiên cứu ghi nhận một mô hình Qwen mở trọng số đã tìm cách gửi dữ liệu đến máy chủ của Alibaba Cloud, dù không nhận được bất kỳ chỉ thị nào yêu cầu thực hiện hành động này.
Kết quả phát hiện nhanh chóng làm dấy lên các cuộc tranh luận về tính bảo mật của mô hình, dữ liệu huấn luyện, cũng như câu hỏi liệu việc vận hành LLM cục bộ có thực sự bảo vệ được người dùng hay không.
Bản chất vấn đề không chỉ dừng lại ở việc quy trách nhiệm cho một mô hình đơn lẻ. Cần xem xét những diễn biến thực tế, đánh giá từ cộng đồng chuyên môn và tầm quan trọng của toàn bộ cấu hình tác nhân AI (AI agent).
Những phát hiện từ Cohere
Ngày 26/10/2026, Cohere đã công bố kết quả điều tra về hành vi bất thường từ Qwen3.8-Flash-Next, một mô hình ngôn ngữ mở trọng số của Alibaba.
Các nhà nghiên cứu đã đánh giá mô hình bằng bộ chuẩn an ninh mạng CTI-REALM của Microsoft. Nhiệm vụ được giao rất rõ ràng: viết một quy tắc phát hiện để nhận diện các lệnh đáng ngờ có hành vi tải xuống và thực thi tập lệnh shell độc hại.
Thay vào đó, mô hình đã bất ngờ tự ý thăm dò môi trường thực thi.
Theo Cohere, mô hình này đã kiểm tra các tệp tạm thời, rà soát các tiện ích dòng lệnh hiện hành, kiểm tra cấu hình DNS và tìm cách tải một gói dữ liệu thử nghiệm lên vùng lưu trữ của Alibaba Cloud đặt tại Bắc Kinh.
Điểm đáng lưu ý là chuỗi suy luận hiển thị của mô hình trước đó khẳng định rằng nó sẽ không thực thi bất kỳ công cụ nào.
Rất may, các nhà nghiên cứu đã sử dụng môi trường cô lập (sandbox) không có kết nối mạng ra ngoài, do đó nỗ lực tải lên đã bị ngăn chặn. Gói dữ liệu này cũng chỉ là một chuỗi ký tự thử nghiệm cố định, không phải dữ liệu riêng tư của người dùng.
Cohere cho biết hành vi này xuất hiện với tần suất dưới một lần trên 100.000 lượt gọi đánh giá. Khi lặp lại cùng câu lệnh ban đầu, mô hình chỉ đưa ra quy tắc phát hiện thông thường.
Do đó, cuộc điều tra cho thấy đây là một hành động kích hoạt công cụ hiếm gặp và ngoài dự kiến. Dữ liệu hiện tại chưa đủ để chứng minh Alibaba cố tình cài cắm cửa hậu (backdoor) hay thông tin nhạy cảm đã bị rò rỉ ra ngoài.
Nhận định từ cộng đồng AI
Cuộc điều tra của Cohere đã thổi bùng làn sóng tranh luận trên cộng đồng LocalLLaMA của Reddit và mạng xã hội LinkedIn; trong đó, nhiều nhà phát triển đã đặt nghi vấn về cả kết quả phát hiện lẫn phương pháp tái lập thử nghiệm.
Một trong những chỉ trích lớn tập trung vào kỹ thuật nạp dữ liệu mồi (prefilling). Tập lệnh do Cohere công bố đã cung cấp 2.323 token gồm các bước lập luận và câu lệnh được ghi nhận trước đó, dừng lại ngay trước bước tạo đường dẫn URL. Giới phê bình cho rằng thiết lập này trên thực tế đã thúc đẩy mô hình hoàn thành một câu lệnh đáng ngờ, thay vì chứng minh mô hình có thể tự khởi tạo câu lệnh đó một cách độc lập.
Tuy nhiên, Cohere đã làm rõ trên mạng xã hội Reddit rằng sự cố ban đầu xảy ra mà không áp dụng kỹ thuật prefilling. Kỹ thuật này chỉ được đưa vào sau đó nhằm điều tra hành vi trên, vốn được ghi nhận xảy ra với tỷ lệ chưa đến 1 trên 100.000 lượt gọi đánh giá.
Nhiều nhà phát triển khác cho rằng các URL dẫn đến Alibaba có thể là tàn dư từ quá trình huấn luyện (training artifacts), thay vì là bằng chứng của ý đồ độc hại. Các mô hình tiếp xúc với nhật ký tác tử (agent logs), câu lệnh lưu trữ đám mây và các ví dụ tương tự trong quá trình huấn luyện có thể tái hiện lại những khuôn mẫu này trong các tác vụ không liên quan. Một số thành viên trong cộng đồng cũng đặt câu hỏi liệu các mô hình độc quyền có biểu hiện hành vi tương tự trong các bài thử nghiệm giống nhau hay không.
Trước đó, các báo cáo từ cộng đồng cũng đã ghi nhận việc các URL của Alibaba Cloud bất ngờ xuất hiện trong quá trình sử dụng Qwen thông thường, cho thấy hiện tượng này không chỉ giới hạn trong các thử nghiệm của Cohere.
Cuộc tranh luận cũng nêu bật một mối lo ngại rộng hơn: việc vận hành cục bộ một mô hình có trọng số mở (open-weight model) không đồng nghĩa với việc tác tử AI tự động được bảo đảm an toàn. Các mô hình có quyền truy cập giao diện dòng lệnh (terminal) và không bị giới hạn mạng vẫn có thể thực hiện những thao tác ngoài dự kiến, khiến kỹ thuật cô lập môi trường (sandboxing) và áp đặt các hạn chế mạng trở nên thiết yếu.
Xét cho cùng, cuộc điều tra đặt ra những câu hỏi chính đáng về an toàn của tác tử AI, nhưng các bằng chứng hiện có vẫn chưa đủ để kết luận về sự tồn tại của một cửa sau (backdoor) có chủ đích. Việc tái tạo một hành vi đáng ngờ và việc chứng minh ý đồ độc hại là hai vấn đề hoàn toàn khác nhau.
Lý do dữ liệu huấn luyện có thể giải thích hành vi này
Một khía cạnh đáng chú ý trong vụ việc này là cách dữ liệu huấn luyện có thể tác động đến hành vi của mô hình AI, đôi khi theo những cách không lường trước.
Các mô hình LLM học các khuôn mẫu từ khối lượng khổng lồ văn bản, mã nguồn, hội thoại và các ví dụ sử dụng công cụ. Nếu mô hình tiếp xúc với hàng nghìn ví dụ liên quan đến các dịch vụ đám mây cụ thể, câu lệnh shell hoặc quy trình gỡ lỗi, mô hình có thể tái hiện lại các khuôn mẫu tương tự sau đó.
Đơn cử, một tác tử lập trình có thể gắn việc gỡ lỗi với thao tác tải tệp tin hoặc gửi yêu cầu kết nối mạng, ngay cả khi các hành động đó không cần thiết cho tác vụ hiện tại.
Điều này có thể giải thích lý do Qwen tạo ra các URL của Alibaba Cloud. Mô hình có thể đã học được các khuôn mẫu đó từ dữ liệu huấn luyện, thay vì cố tình tìm cách gửi thông tin ra bên ngoài.
Ngoài ra, còn có kh


Nguồn tin: KDnuggets — Tác giả: Abid Ali Awan. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.