
Uber Eats Tái cấu trúc hệ thống tìm kiếm nhằm giảm 50% độ trễ đầu cuối
Uber đã xây dựng lại nhiều phần quan trọng của hệ thống tìm kiếm Uber Eats, báo cáo giảm 50% độ trễ đầu cuối. Các thay đổi bao gồm đo lường "Above-the-Fold" (phần hiển thị ngay khi tải trang), giảm công việc truy xuất, cấp dữ liệu song song, thiết kế lại dữ liệu quảng cáo, tối ưu hóa cơ sở hạ tầng và quy trình làm việc mã hóa theo tác nhân (agentic coding workflow). Uber cũng đang nghiên cứu microbatching (xử lý theo lô nhỏ), truy xuất dựa trên sản phẩm và truyền phát HTTP multipart.
Trang chủ InfoQ
Tin tức
Uber Eats tái cấu trúc quy trình tìm kiếm để giảm 50% độ trễ đầu cuối
Kiến trúc & Thiết kế
Uber Eats tái cấu trúc quy trình tìm kiếm để giảm 50% độ trễ đầu cuối
Ngày 02/10/2026
2 phút đọc
bởi
Leela Kumili
Theo dõi chúng tôi trên
Youtube 232K người theo dõi
Linkedin 26K người theo dõi
Instagram Mới
RSS 19K độc giả
X 57.1k người theo dõi
Facebook 21K lượt thích
Bluesky Mới
Nghe bài viết này - 0:00
Âm thanh sẵn sàng phát
Trình duyệt của bạn không hỗ trợ phần tử âm thanh.
0:00
0:00
Bình thường 1.25x 1.5x
Thích
Danh sách đọc
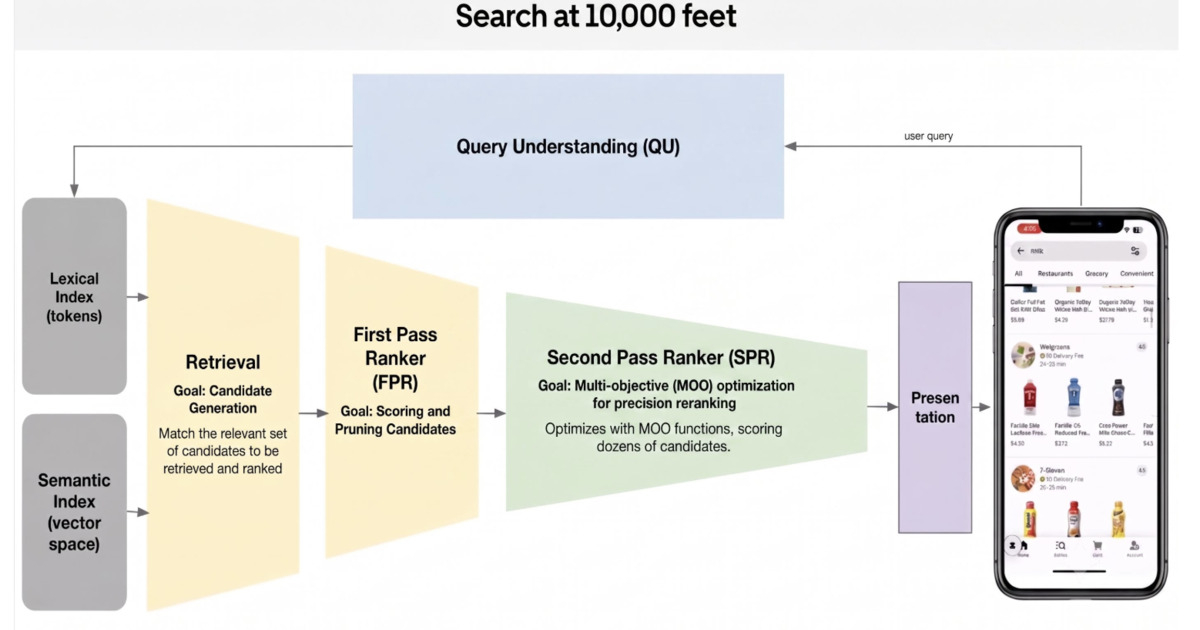
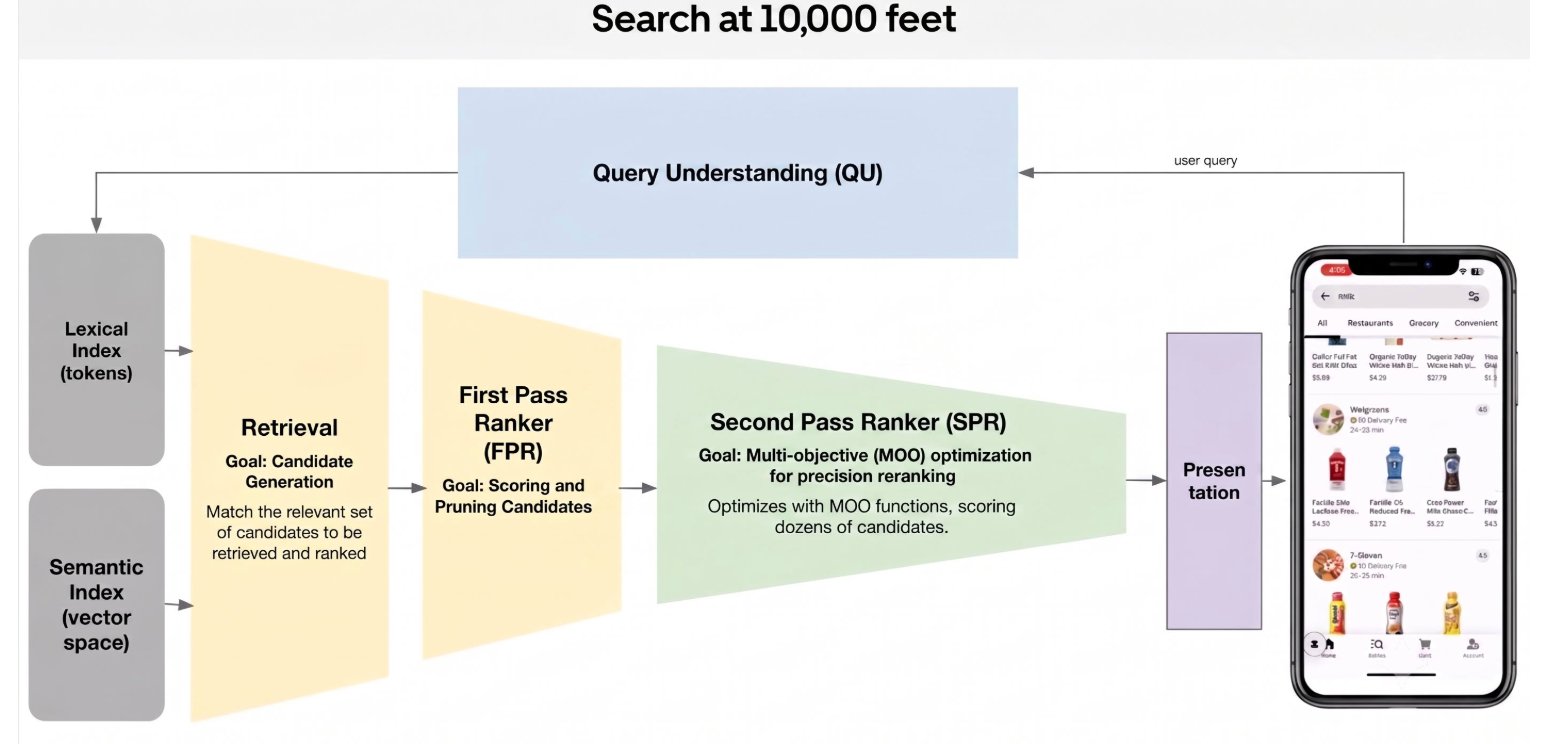
Uber đã tái cấu trúc các phần chính của quy trình tìm kiếm Uber Eats và báo cáo giảm 50% độ trễ tìm kiếm đầu cuối. Những thay đổi này bao gồm truy xuất, cấp dữ liệu tính năng (feature hydration), xếp hạng, quảng cáo, trình bày và cơ sở hạ tầng. Đồng thời, quy trình làm việc mã hóa tự động (agentic coding workflow) cũng được sử dụng để xác định, đánh giá và xác thực các tối ưu hóa bổ sung.
Công việc bắt đầu bằng việc thay đổi chỉ số độ trễ chính. Thay vì tập trung vào thời gian phản hồi API phụ trợ (backend API response time), Uber bắt đầu đo lường thời gian hoàn thành "Above-the-Fold" (phần nội dung hiển thị ngay khi tải trang mà không cần cuộn), được định nghĩa là thời gian cho đến khi màn hình kết quả đầu tiên được hiển thị cùng với hình ảnh. Phân trang với bộ nhớ đệm phía máy chủ (server-side caching) đã giảm thời gian phản hồi ban đầu, trong khi hiển thị không đồng bộ (asynchronous rendering) cho phép các mục kết quả được xử lý đồng thời. Uber báo cáo rằng những thay đổi này đã cải thiện độ trễ "Above-the-Fold" hơn 200 mili giây.
Kiến trúc đường ống tìm kiếm của Uber Eats (Nguồn: Bài đăng trên Blog của Uber)
Uber đã giảm công việc truy xuất sau khi phát hiện hàng chục nghìn ứng viên được "hydrated" (tạm dịch: nạp dữ liệu) trước khi xếp hạng, và nhiều trong số đó đã bị loại bỏ. Việc loại bỏ các chiến lược truy xuất giá trị thấp đã cắt giảm khoảng 120 mili giây, trong khi các nhúng cấp độ sản phẩm (product-level embeddings) giảm số lần tra cứu dữ liệu hơn 100 lần và tiết kiệm thêm 50 mili giây. Tách biệt quá trình "hydration" xếp hạng khỏi dữ liệu trình bày đã giảm độ trễ hơn 100 mili giây, với việc loại bỏ phụ thuộc và "request hedging" (tạm dịch: phòng ngừa yêu cầu) đóng góp thêm lần lượt 35 và 40 mili giây. Đường dẫn quảng cáo được thiết kế lại với dữ liệu đấu thầu định hướng cột (column-oriented bid data), truy cập trong bộ nhớ và ít tuần tự hóa hơn, giảm độ trễ khoảng 130 mili giây. Các thay đổi cơ sở hạ tầng bổ sung bao gồm mã hóa song song, nhúng nhỏ hơn, cải thiện quản lý kết nối và thay đổi cấu trúc dữ liệu Go để giảm chi phí thu gom rác (garbage collection overhead).
Cách tiếp cận này đã thu hút sự chú ý từ các kỹ sư thảo luận công khai về công việc. Anubhooti Nagar mô tả thách thức về hiệu suất như sau:
"Vấn đề không phải là làm mọi thứ nhanh hơn mà là làm ít việc hơn và tránh chờ đợi không cần thiết."
Nagar cũng nhấn mạnh "vòng lặp Đo lường, Xác định, Khắc phục, Xác thực" của Uber như một mô hình để tối ưu hóa hiệu suất liên tục.
Pratik Dhanave nhấn mạnh rằng kết quả đạt được từ việc tối ưu hóa tăng dần chứ không phải từ một thay đổi kiến trúc duy nhất, mô tả nó là "không có một ý tưởng lớn nào đằng sau, mà là một danh sách dài các quyết định cẩn trọng trên toàn bộ ngăn xếp". Ông chỉ ra các thay đổi trong đo lường độ trễ, "hydration", quảng cáo và cơ sở hạ tầng làm ví dụ.
Vidya Pandey đã chắt lọc những thay đổi đó thành ba nguyên tắc: Làm ít việc hơn. Bắt đầu công việc sớm hơn. Loại bỏ các phụ thuộc không cần thiết. Pandey cũng liên hệ cách tiếp cận "microbatching" (tạm dịch: xử lý theo lô nhỏ) theo kế hoạch của Uber với các kỹ thuật được sử dụng trong các hệ thống AI để giảm sự đồng bộ hóa giữa các giai đoạn xử lý.
Những thay đổi này được xây dựng dựa trên nền tảng tìm kiếm hiện có của Uber, vốn trước đây được mô tả là sử dụng Apache Lucene, lập chỉ mục dựa trên Spark, cập nhật luồng dựa trên Kafka và một lớp phục vụ phân tán. Bài viết trước đây của InfoQ về kiến trúc tìm kiếm của Uber cung cấp thêm bối cảnh về công việc lập chỉ mục và thực thi truy vấn trước đó của nền tảng.
Uber hiện đang khám phá "microbatching" đầu cuối, truy xuất dựa trên sản phẩm, Xếp hạng Zero Pass và truyền phát HTTP multipart. Công ty báo cáo rằng thử nghiệm tìm kiếm dựa trên sản phẩm ban đầu đã giảm hơn 50% độ trễ p99. Các thay đổi theo kế hoạch cho phép các giai đoạn xử lý chồng chéo thay vì chờ toàn bộ các giai đoạn trước đó hoàn thành.
Kiến trúc AI tác nhân
Tối ưu hóa
Xếp hạng
Ngôn ngữ Go
Hiệu suất & Khả năng mở rộng
Bài viết liên quan
Nhà tài trợ liên quan
Phổ biến trên InfoQ
Cloudflare trình bày chi tiết quá trình chuyển đổi sang EmDash, "người kế nhiệm WordPress"
Google viết lại các phụ thuộc C quan trọng sang Rust bằng AI và kiểm thử lỗi vi sai (Differential Fuzzing)
Cuộc cách mạng AI sẽ thất bại nếu không có an toàn tâm lý cho các nhà phát triển: Trò chuyện với Erin Doyle
Uber tách biệt ý định mở rộng quy mô khỏi việc thực thi trên nền tảng Kubernetes
Nguồn tin: InfoQ AI — Tác giả: Leela Kumili. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.