
Tự động khắc phục sự cố cho các cụm GPU Together: Từ lỗi GPU đến nút mạng hoạt động bình thường
Tính năng tự động khắc phục sự cố của Together GPU Clusters có khả năng phát hiện các lỗi liên quan đến GPU, máy chủ (host) và hạ tầng mạng (fabric), lựa chọn phương án xử lý tối ưu nhất, đồng thời cho phép người dùng thiết lập quy trình tự động sửa chữa theo từng loại lỗi và từng mã Xid cụ thể. Cơ chế hoạt động cụ thể như sau:
Ở quy mô cụm máy chủ, các lỗi GPU là thực tế khó tránh khỏi. Lỗi Xid, lỗi ECC hai bit (double-bit ECC), sự cố GPU ngắt kết nối khỏi bus PCIe hoặc đường truyền InfiniBand chập chờn đều có thể làm đình trệ tác vụ huấn luyện phân tán hoặc khiến một bản sao suy luận (inference replica) ngừng hoạt động. Việc phát hiện sự cố thường là khâu đơn giản. Thách thức lớn nhất nằm ở toàn bộ quy trình xử lý từ khi phát sinh lỗi cho đến khi đưa nút mạng (node) trở lại trạng thái hoạt động bình thường.
Đầu năm nay, tính năng tự động khắc phục sự cố nút mạng (Automatic node remediation) hoàn toàn đã chính thức được công bố. Khách hàng sử dụng cụm GPU cùng nền tảng suy luận nội bộ đã và đang ứng dụng năng lực này nhằm nâng cao khả năng phục hồi của khối lượng công việc và giảm thiểu thời gian gián đoạn hoạt động. Nhận được sự đánh giá cao từ người dùng, hệ thống này được phân tích chi tiết dưới đây về cơ chế vận hành cũng như định hướng thiết kế.
Hệ thống kiểm tra "sức khỏe thụ động" (Passive health) được triển khai trước tiên, nhằm giám sát liên tục từng nút mạng, từ bên trong máy ảo (VM) cho đến máy chủ vật lý bên dưới. Khi phát hiện sự cố, cơ chế tự động sửa lỗi sẽ đề xuất phương án khắc phục tối giản nhất, đồng thời cung cấp các bằng chứng xác thực liên quan. Người quản trị có thể thiết lập trước cho từng loại lỗi cụ thể về việc quy trình sửa chữa cần phê duyệt hay tự động thực thi, cũng như thời gian chờ tải công việc hiện tại hoàn tất. Các hệ thống phát hiện lỗi riêng của người dùng cũng có thể kích hoạt quy trình sửa chữa thông qua cùng một luồng xử lý bằng cách bổ sung một chú thích (annotation) duy nhất trên nút mạng.
Khả năng cung ứng:
Hiện đã phát hành chính thức: kiểm tra sức khỏe thụ động, đề xuất sửa chữa, chính sách tự động khắc phục (bao gồm phê duyệt theo từng lỗi và từng nút), kiểm soát thời gian chờ trạng thái nhàn rỗi, quy trình nâng cấp mức độ xử lý (escalation ladder), rào chắn an toàn (safety rails), cùng tính năng sửa chữa qua API và bảng điều khiển (console).
Bản thử nghiệm (Preview): các thỏa thuận khắc phục dựa trên nhãn nút (node-label based remediation contracts), cho phép tích hợp các hệ thống phát hiện riêng như NVSentinel hoặc các bộ điều khiển tùy chỉnh.
Các tín hiệu phát hiện và biện pháp khắc phục mới liên tục được bổ sung nhằm bảo đảm phạm vi bao phủ tối đa và rút ngắn thời gian phục hồi.
Lý do trạng thái NotReady là chưa đủ:
Hầu hết các giải pháp tự động sửa chữa nút hiện nay chỉ dựa trên một tín hiệu duy nhất: nút chuyển sang trạng thái NotReady. Tín hiệu này không có sự phân biệt giữa việc nút bị hỏng hoàn toàn hay chỉ tạm thời mất kết nối. Khi sự cố lưu trữ hoặc mạng ảnh hưởng đồng loạt đến nhiều nút, toàn bộ các nút liên quan đều chuyển sang trạng thái NotReady. Hệ thống hiện tại đã tích hợp cơ chế ngắt mạch tự động (circuit breaker) để ngăn chặn việc thay thế hàng loạt nút. Bên cạnh đó, NotReady không nêu rõ nguyên nhân nút gặp sự cố, do đó không cung cấp đủ căn cứ để lựa chọn giữa việc khởi động lại hay thay thế máy mới.
Vì vậy, cơ chế tự động sửa lỗi tuân thủ một nguyên tắc nhất quán: không tiến hành sửa chữa nếu không có kết quả kiểm tra sức khỏe không đạt đi kèm, và mọi hoạt động sửa chữa đều phải có bằng chứng xác thực.
Quy trình xử lý (pipeline)
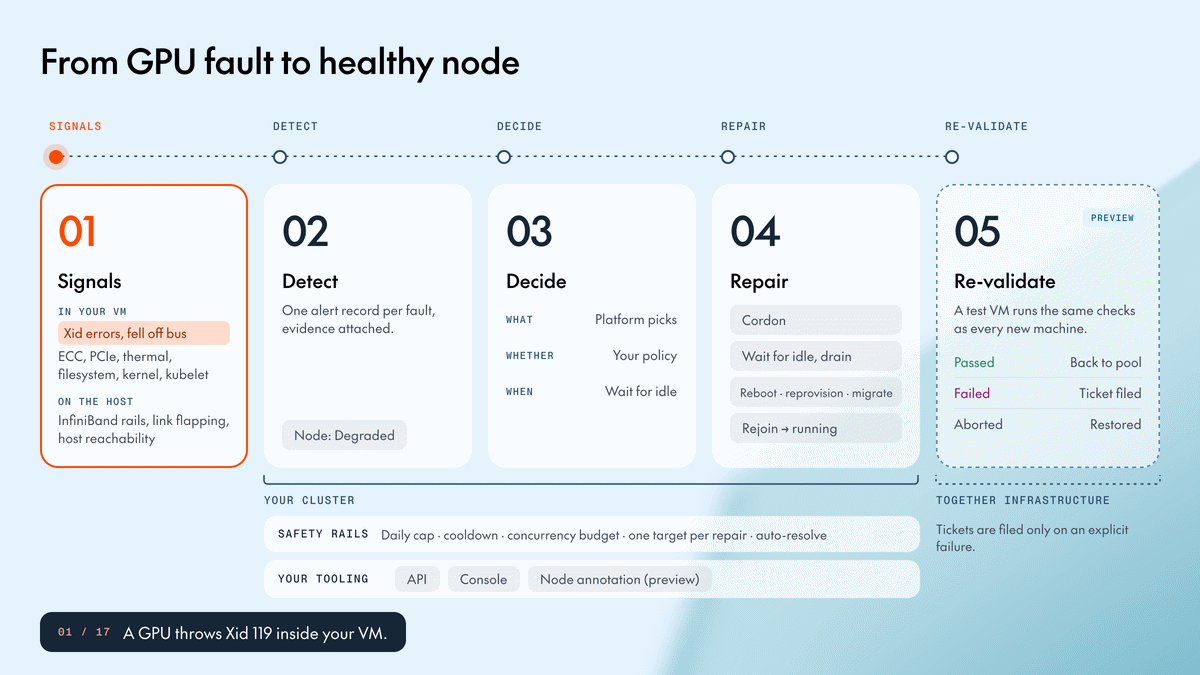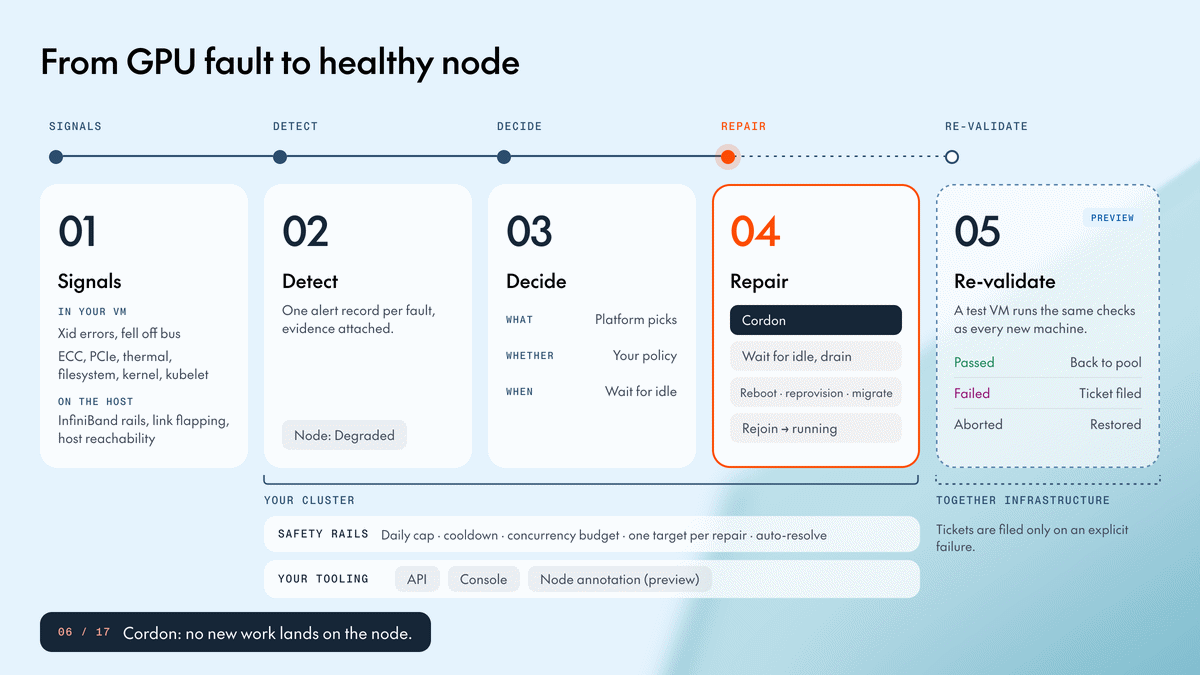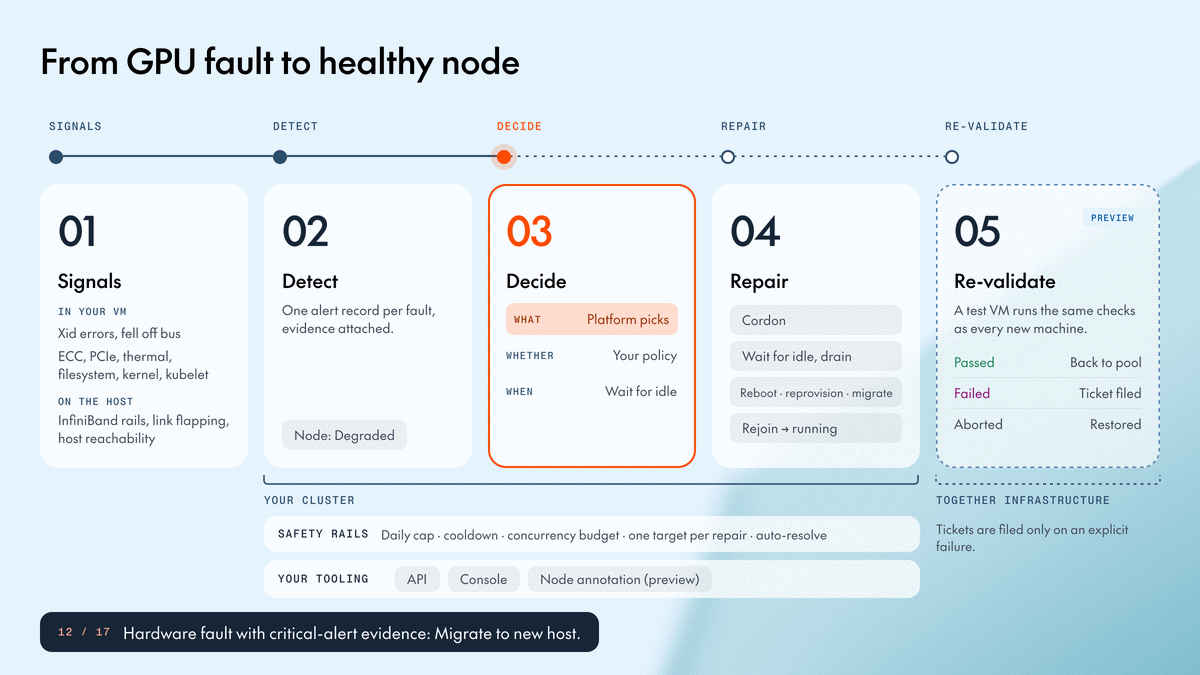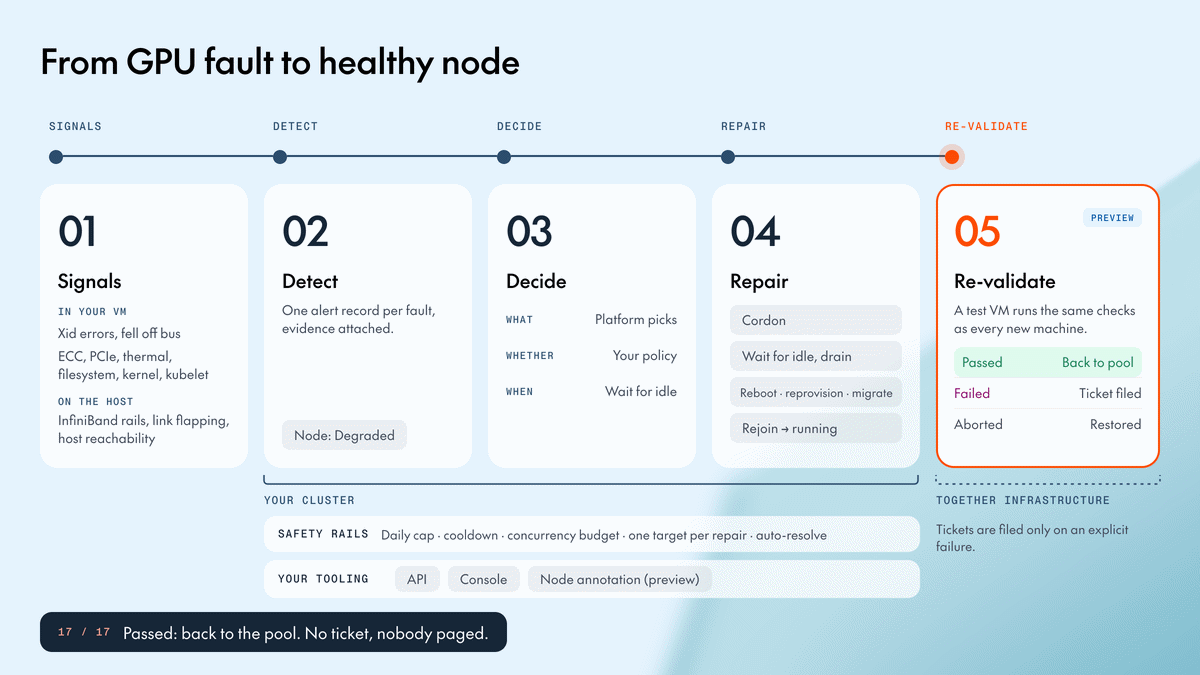
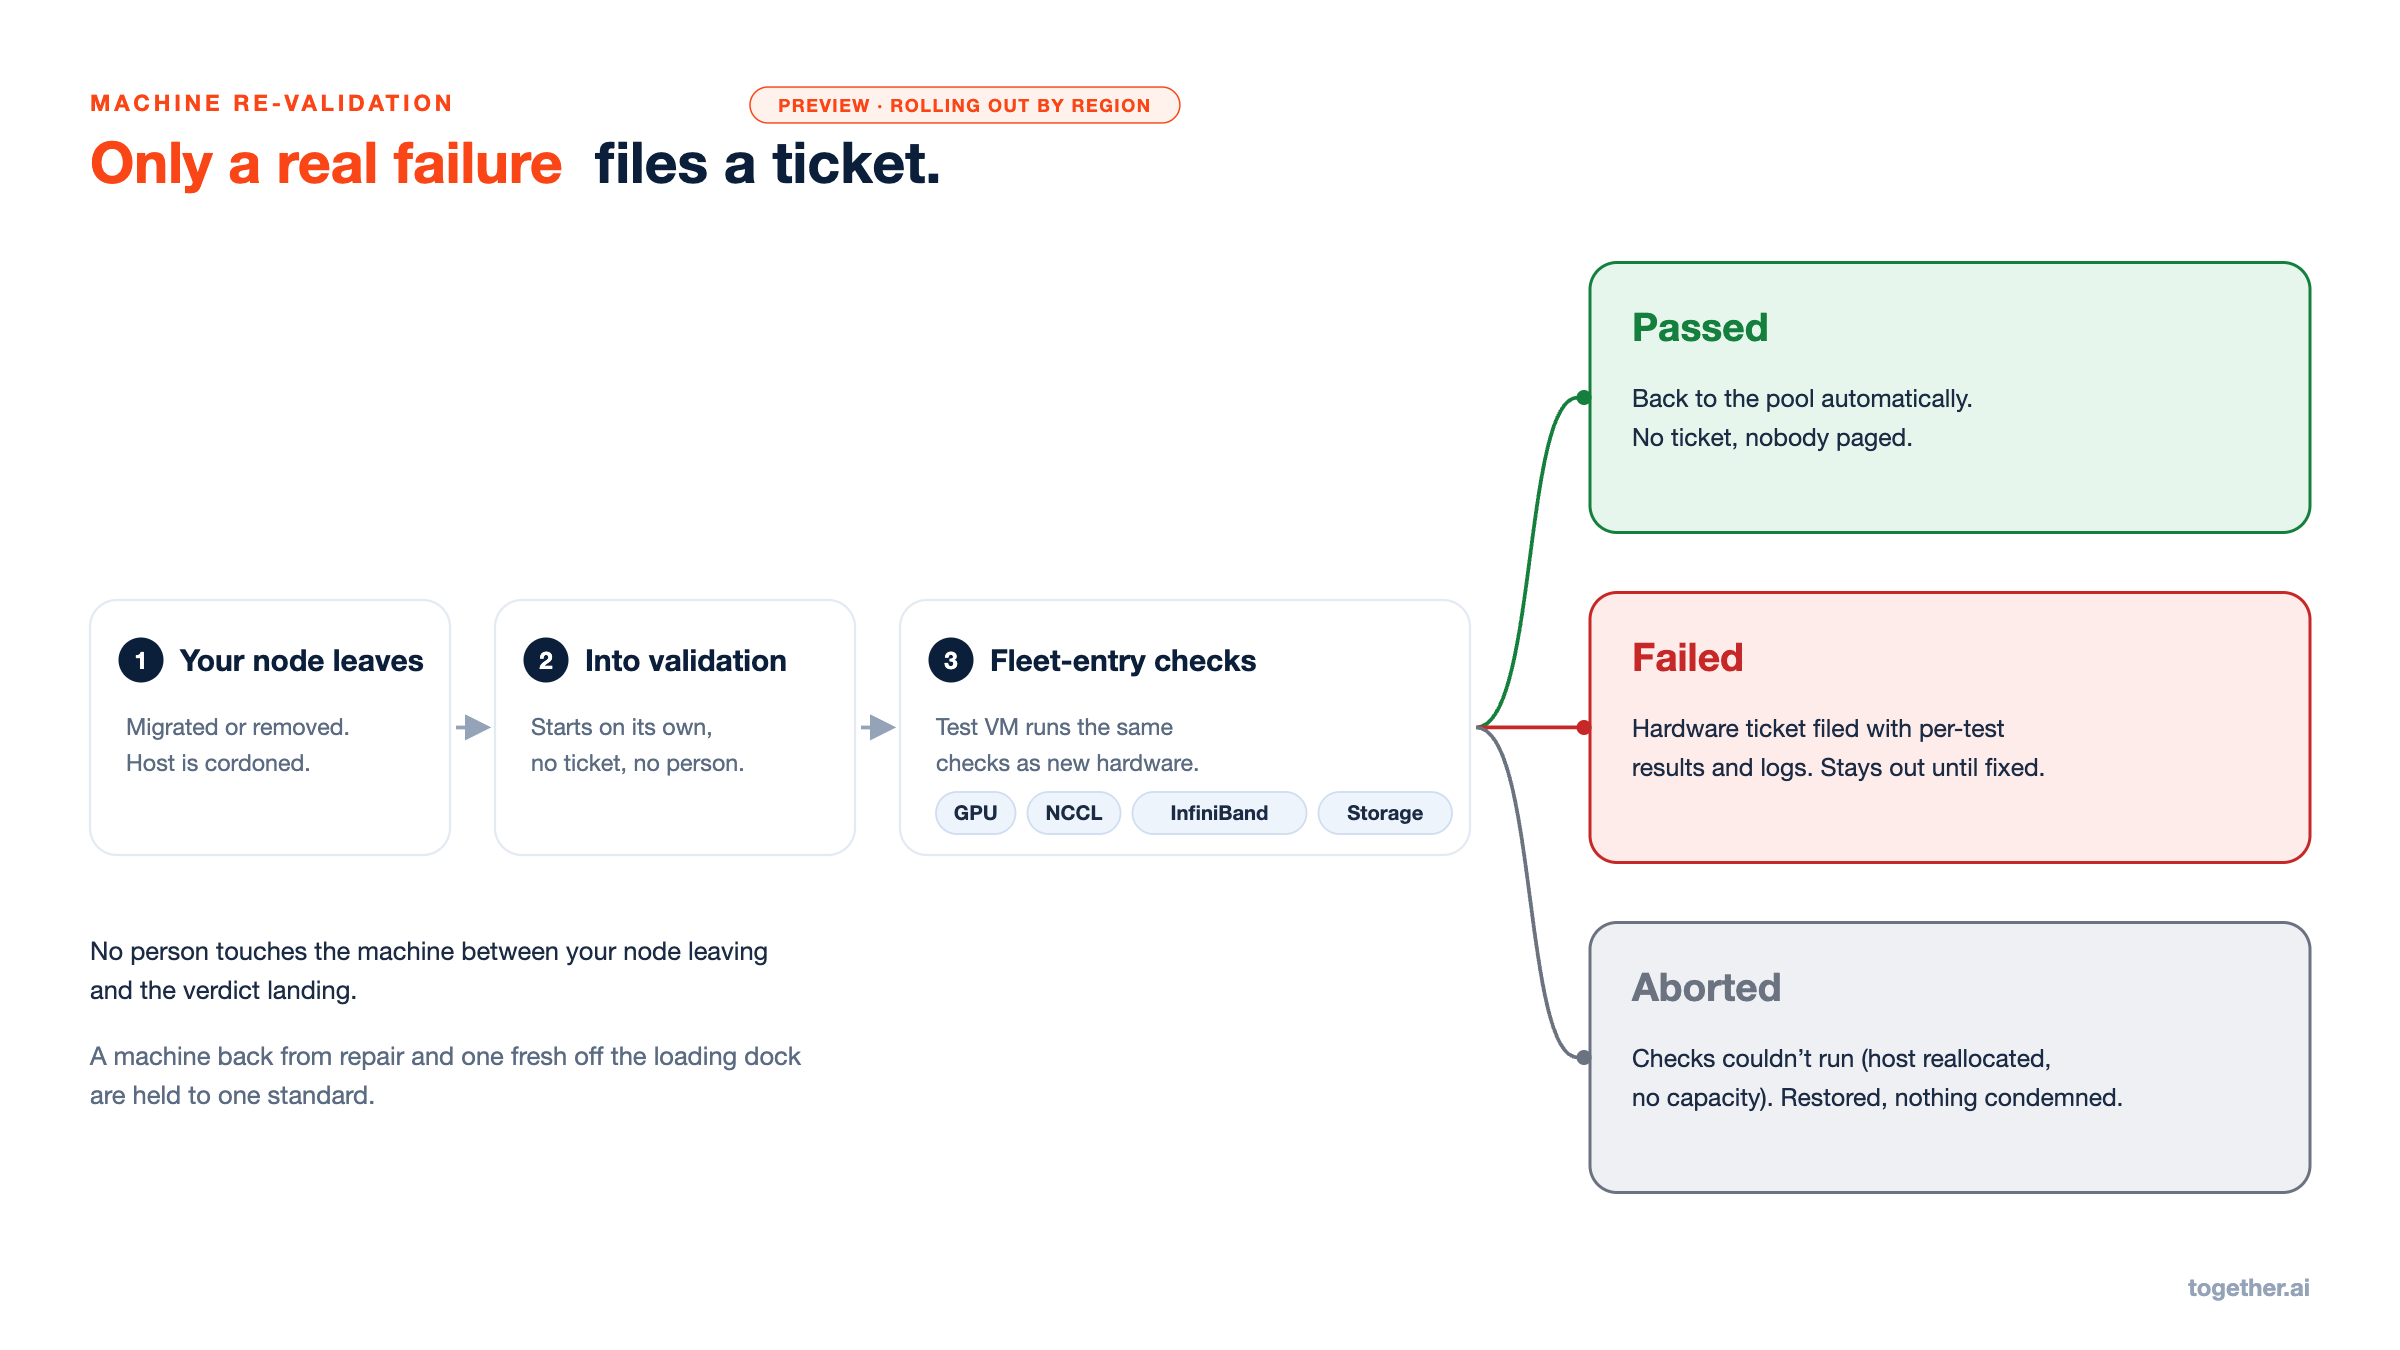
Quy trình tự động sửa chữa: các tín hiệu từ bên trong máy ảo (VM) và từ máy chủ vật lý được đưa vào các khâu Phát hiện, Quyết định và Sửa chữa bên trong cụm máy chủ của người dùng; các máy chủ sau khi di trú sẽ được chuyển sang khâu Tái xác thực trên hạ tầng của Together. Quy trình gồm bốn giai đoạn: phát hiện lỗi, quyết định có can thiệp và can thiệp khi nào, sửa chữa nút (node), và tái xác thực máy chủ. Ba giai đoạn đầu vận hành trên cụm máy chủ của người dùng. Giai đoạn thứ tư vận hành trên hạ tầng của nhà cung cấp, tại máy chủ vật lý mà nút vừa rời khỏi. Các yêu cầu gắn nhãn nút từ công cụ phát hiện của người dùng được tiếp nhận tại giai đoạn quyết định và được xử lý hoàn toàn tương đương quy trình của hệ thống.
1. Phát hiện lỗi từ cả hai phía của phần mềm giám sát máy ảo (hypervisor)
Các GPU trong cụm Together GPU Clusters được kết nối trực tiếp (pass-through) vào máy ảo nhằm bảo đảm hiệu năng tương đương máy chủ vật lý. Điều này đồng nghĩa với việc các lỗi GPU có thể được ghi nhận từ bên trong máy ảo, trong khi các lỗi về máy chủ vật lý và hạ tầng mạng kết nối (fabric) được ghi nhận từ phía máy chủ. Do đó, hoạt động phát hiện lỗi được triển khai đồng thời từ cả hai phía của hypervisor và quy tụ về một đầu mối.
Bên trong máy ảo, các công cụ giám sát (exporter) theo dõi:
nhật ký hạt nhân (kernel log), nhằm phát hiện các lỗi Xid và hiện tượng GPU mất kết nối khỏi bus PCIe
DCGM, nhằm theo dõi lỗi ECC hai bit, lỗi phân bổ lại hàng (row-remap), tỷ lệ truyền lại PCIe và tình trạng tiết giảm xung nhịp do quá nhiệt (thermal throttling)
Node Problem Detector, nhằm phát hiện hệ thống tệp chỉ đọc, sự cố dừng hoạt động của XFS, khóa chết hạt nhân (kernel deadlock) và tình trạng kubelet hoặc containerd liên tục khởi động lại
Trên Slurm, một công cụ giám sát sẽ báo cáo các nút bị đánh dấu DOWN hoặc DRAIN.
Trên máy chủ vật lý, hệ thống theo dõi trạng thái rail InfiniBand và hiện tượng chập chờn liên kết (link flapping) tương ứng với máy ảo sử dụng các đường truyền này. Khả năng kết nối của máy chủ vật lý cũng được giám sát, bảo đảm trường hợp máy chủ ngừng hoạt động sẽ được ghi nhận là một sự cố trên nút thay vì không phản hồi tín hiệu.
Mỗi cảnh báo đều cung cấp phần tóm tắt chuẩn hóa, phần mô tả bằng ngôn ngữ thông thường và gói dữ liệu minh chứng có thể đọc bằng máy. Đối với lỗi Xid, dữ liệu bao gồm từng mã lỗi và mã định danh của NVIDIA. Đối với hiện tượng tiết giảm xung nhịp do quá nhiệt, dữ liệu gồm mức nhiệt độ đỉnh và số lần tiết giảm. Mặt phẳng điều khiển (control plane) giữ nguyên các chuỗi dữ liệu này, bảo đảm bảng điều khiển (console), API (dưới dạng linked_alerts) và các thông báo gửi đến người dùng luôn hiển thị nội dung thống nhất.
Hệ thống phân tách rạch ròi giữa thông tin ghi nhận và hành động xử lý. Mọi cảnh báo liên quan đến sửa chữa đều được ghi lại và đánh dấu nút ở trạng thái Suy giảm (Degraded). Chỉ các tín hiệu đã được liên kết với một hành động cụ thể mới kích hoạt quy trình sửa chữa. Ví dụ, cảnh báo áp lực dung lượng đĩa (disk pressure) sẽ hiển thị nhưng không kích hoạt việc khởi động lại hệ thống, do khởi động lại không thể xử lý dứt điểm vấn đề này. Những cảnh báo chưa được liên kết hành động vẫn được thống kê và ghi nhật ký đầy đủ, tuyệt đối không bị bỏ sót, đồng thời được chuyển tiếp tới đội ngũ hỗ trợ kỹ thuật để điều tra, xử lý.
2. Chính sách: Hệ thống quyết định phương thức xử lý, người dùng quyết định việc áp dụng và thời điểm thực hiện
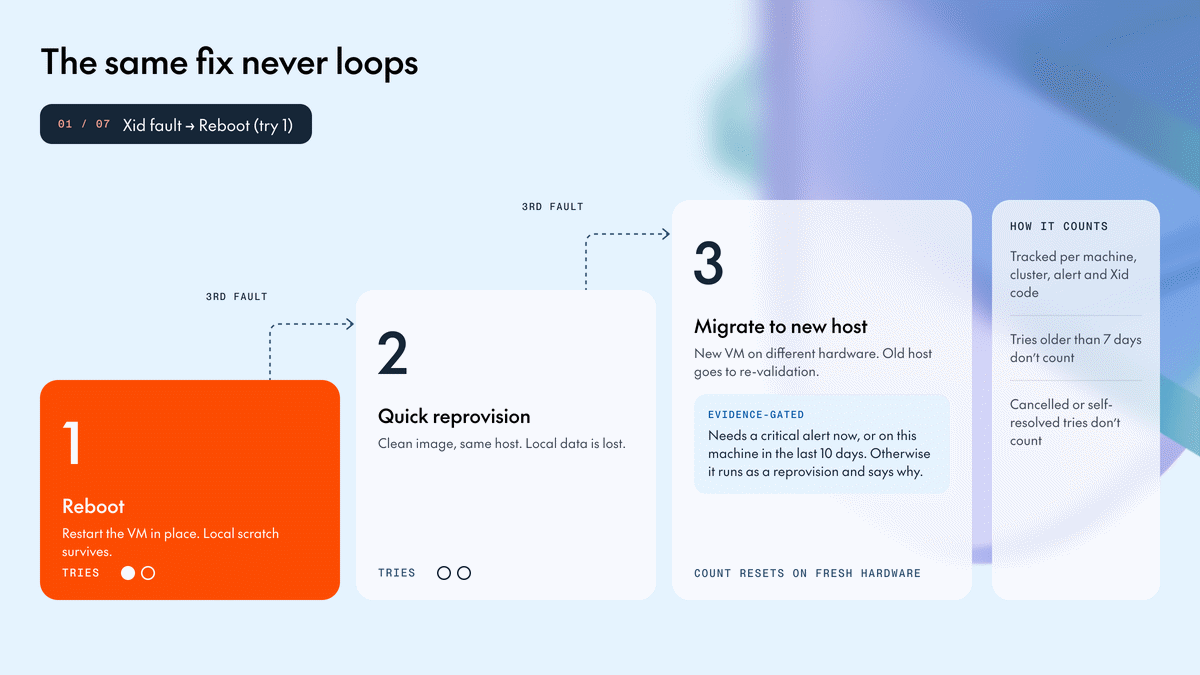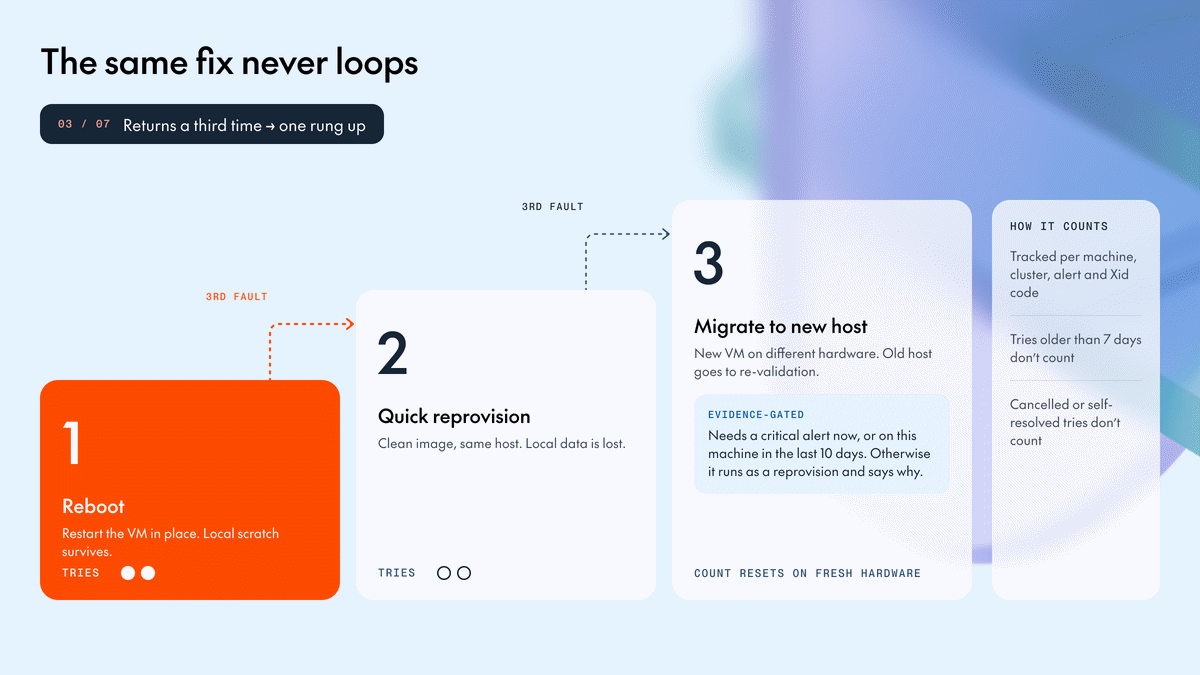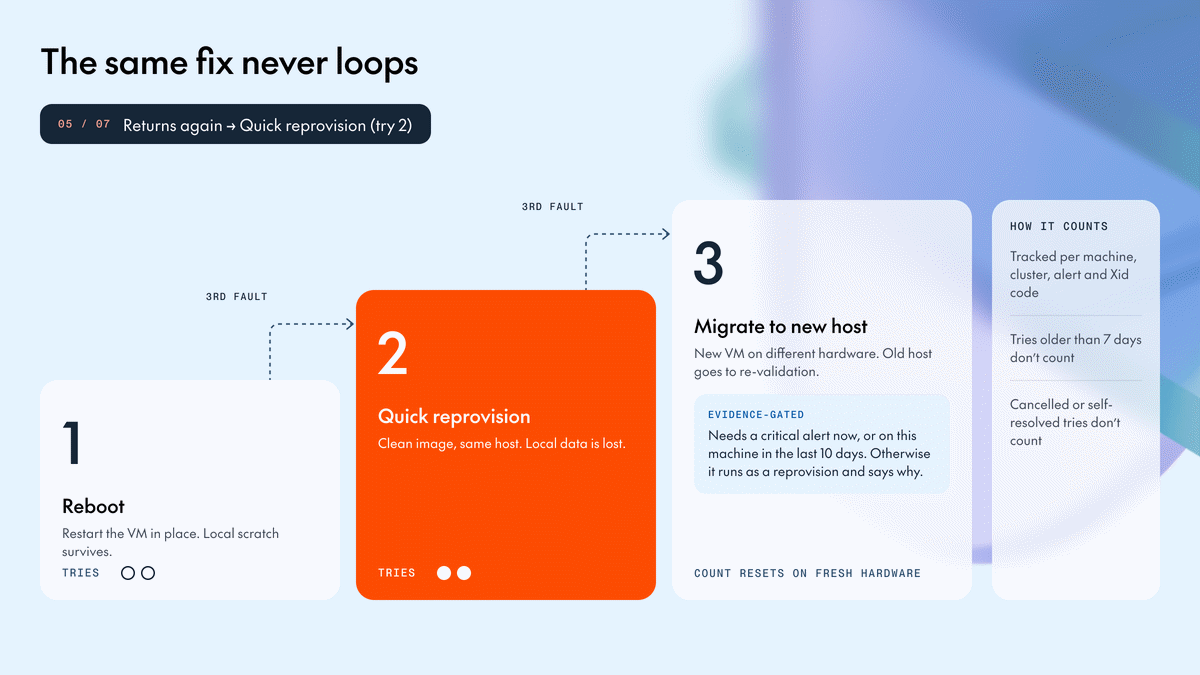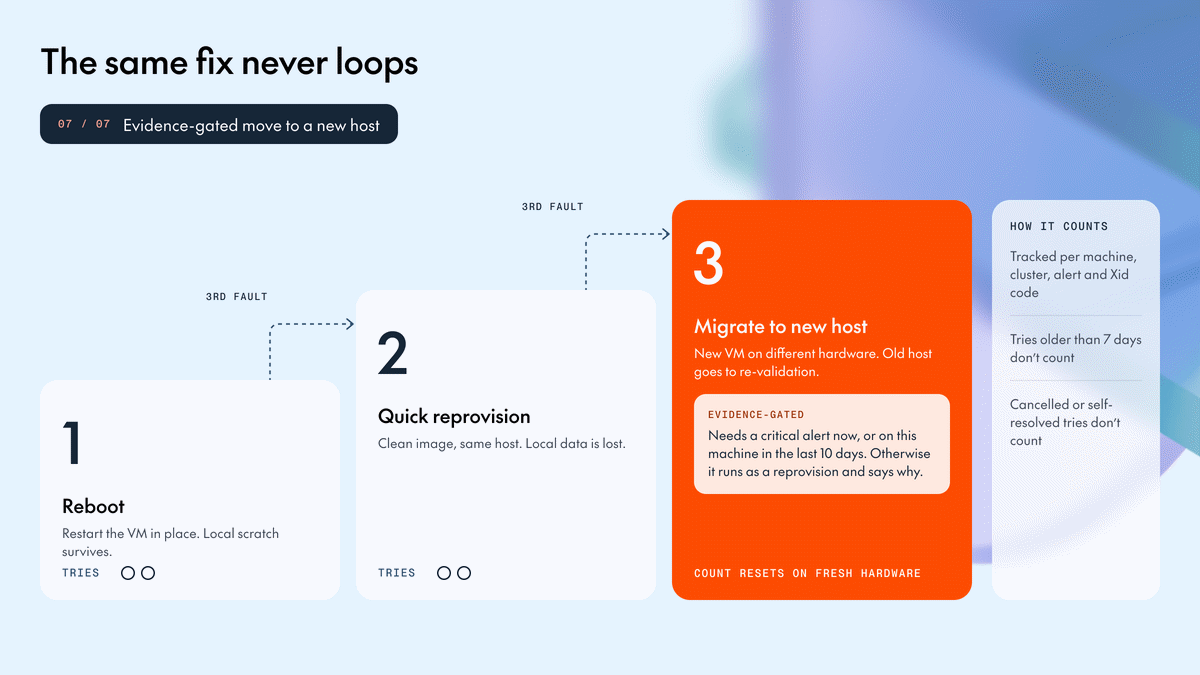
Phương thức xử lý do nền tảng đảm trách. Mỗi tín hiệu lỗi được quy chiếu tới hành động can thiệp tối thiểu có thể khắc phục sự cố, giúp người dùng không cần phải phân loại ý nghĩa của từng mã lỗi Xid:
Quyết định áp dụng phương thức xử lý phụ thuộc vào người quản trị. Tại tab Repairs, chính sách Tự động khắc phục (Auto-remediation policy) được mặc định ở chế độ Phê duyệt trước khi sửa chữa (Approve before repair): mọi đề xuất đều chờ nhân sự vận hành can thiệp để chấp thuận hoặc thay đổi tác vụ. Người dùng có thể chuyển chế độ mặc định sang Tự động hoàn toàn (Fully automatic), song đây không phải là quyết định áp dụng cho toàn bộ hệ thống. Danh mục tác vụ sửa chữa (Repair actions checklist) nhóm các lỗi theo biện pháp khắc phục tương ứng, cho phép lựa chọn các lỗi có thể xử lý tự động mà không cần giám sát. Trong nhóm mã lỗi Xid, quyền phê duyệt có thể được thiết lập riêng cho từng mã. Một cấu hình phổ biến là tự động phê duyệt khởi động lại đối với mã Xid 119 và 95, đồng thời duy trì việc kiểm duyệt đối với tác vụ di trú (migration). Danh mục Xid cũng phát huy tác dụng ở chế độ Phê duyệt trước khi sửa chữa, áp dụng khi cần một danh sách ngắn các lỗi được tự động xử lý trong lúc các trường hợp còn lại chờ kiểm tra thủ công.
Thời điểm triển khai cũng hoàn toàn do người quản trị quyết định. Quá trình sửa chữa đòi hỏi phải rút cạn tài nguyên (drain node), do đó tính năng Chờ trạng thái nhàn rỗi (Wait for idle) sẽ giữ tiến trình cho đến khi node thực sự không còn tải. Trên Kubernetes, điều này đồng nghĩa với việc không có pod đang chạy nào trên node yêu cầu GPU. Trên Slurm, cơ chế này xác nhận bộ điều phối (scheduler) báo cáo không còn tác vụ nào được phân bổ trên node. Thông số Thời gian chờ tối đa (Maximum wait) giới hạn thời gian giữ tiến trình, với mức mặc định là 2 giờ và mức trần là 24 giờ. Tùy chọn Không làm gián đoạn tác vụ đang chạy (Do not interrupt running jobs) sẽ dỡ bỏ hoàn toàn giới hạn này. Cần thiết lập thời gian chờ tối thiểu

Nguồn tin: Together AI Blog. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.