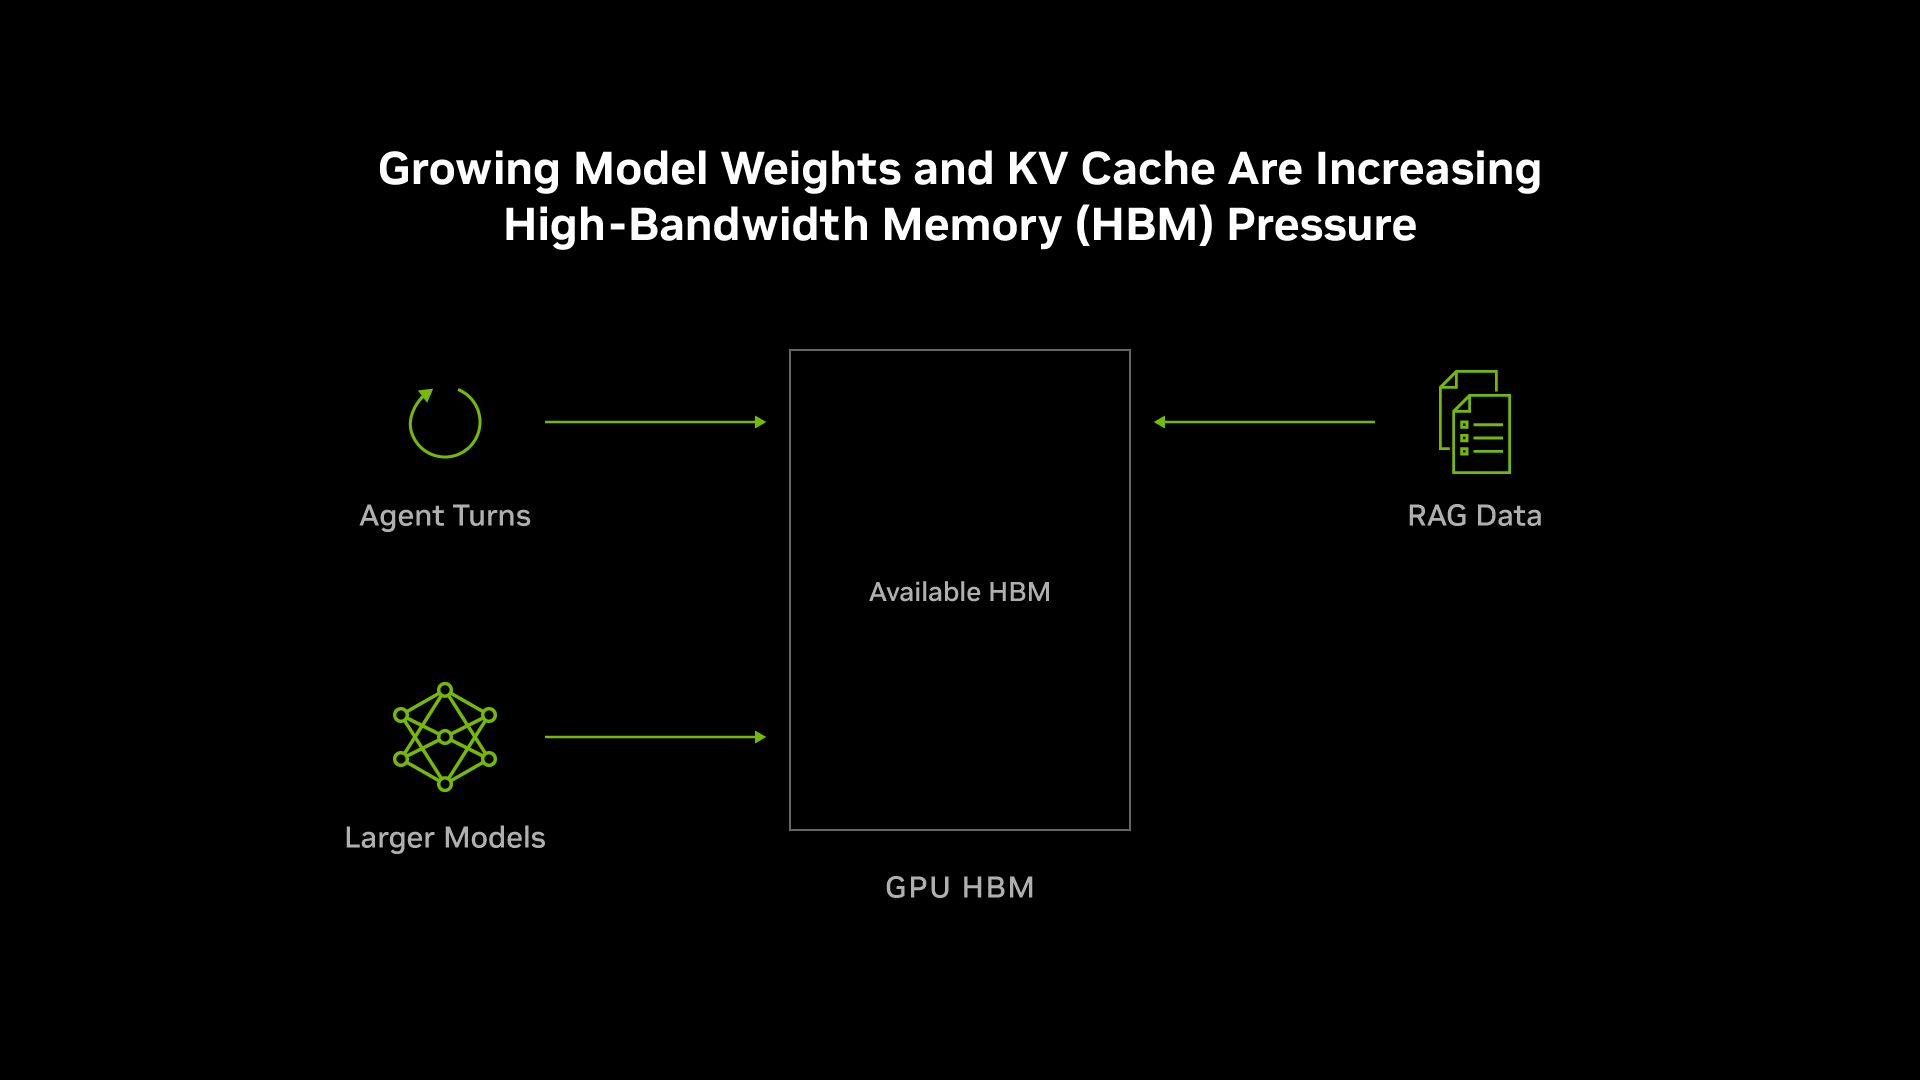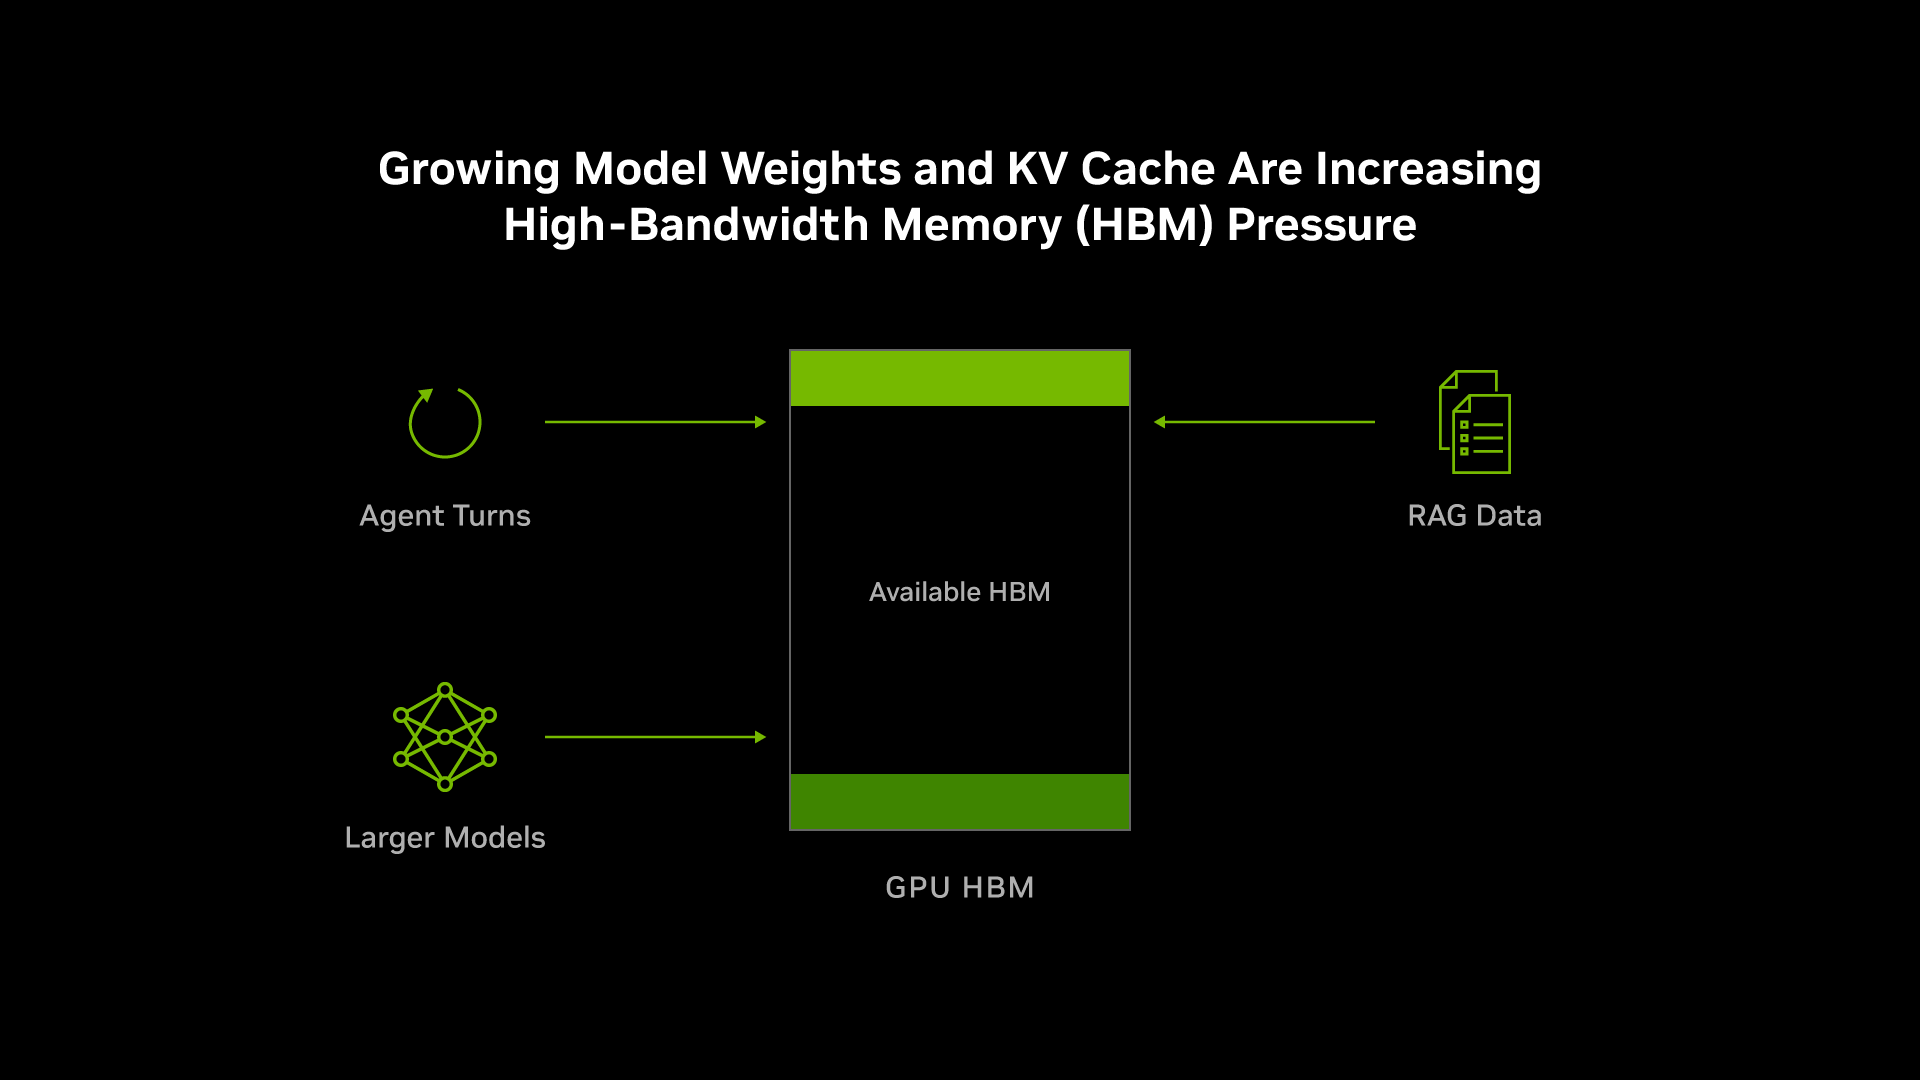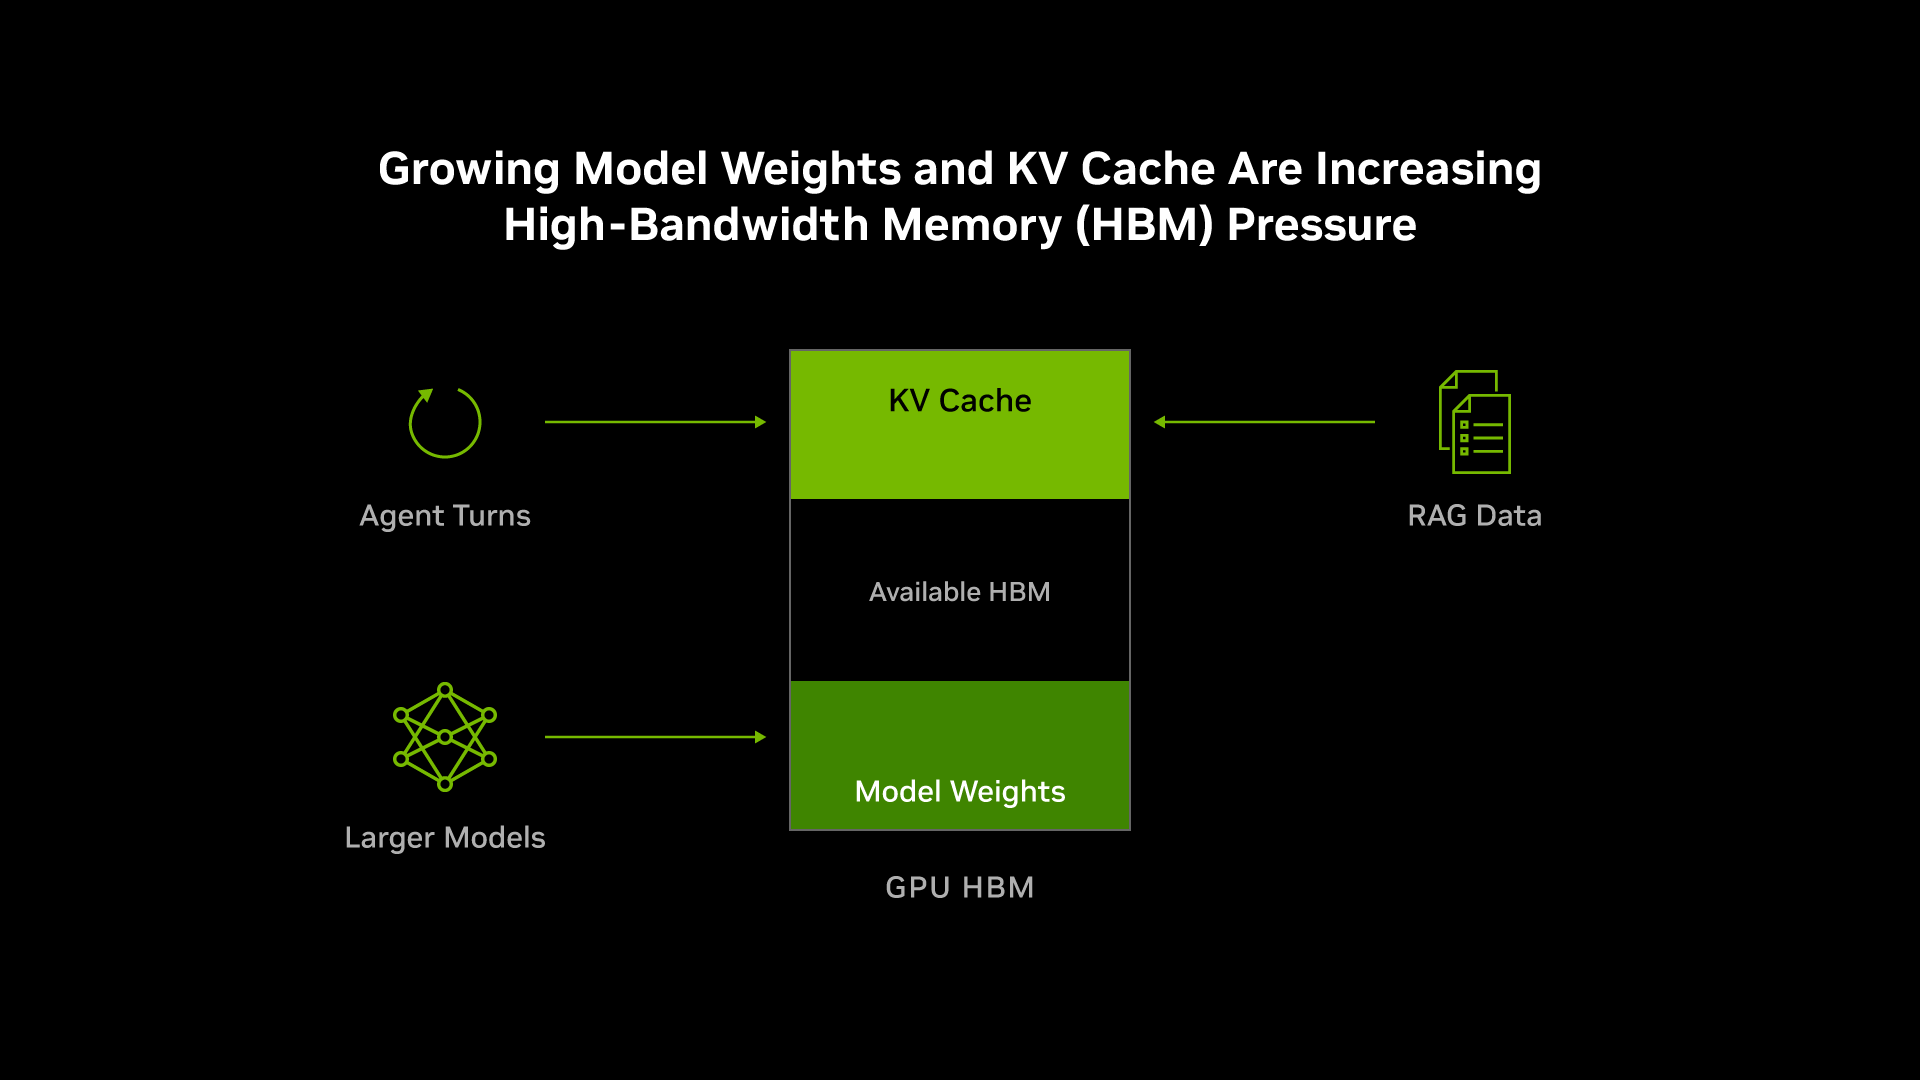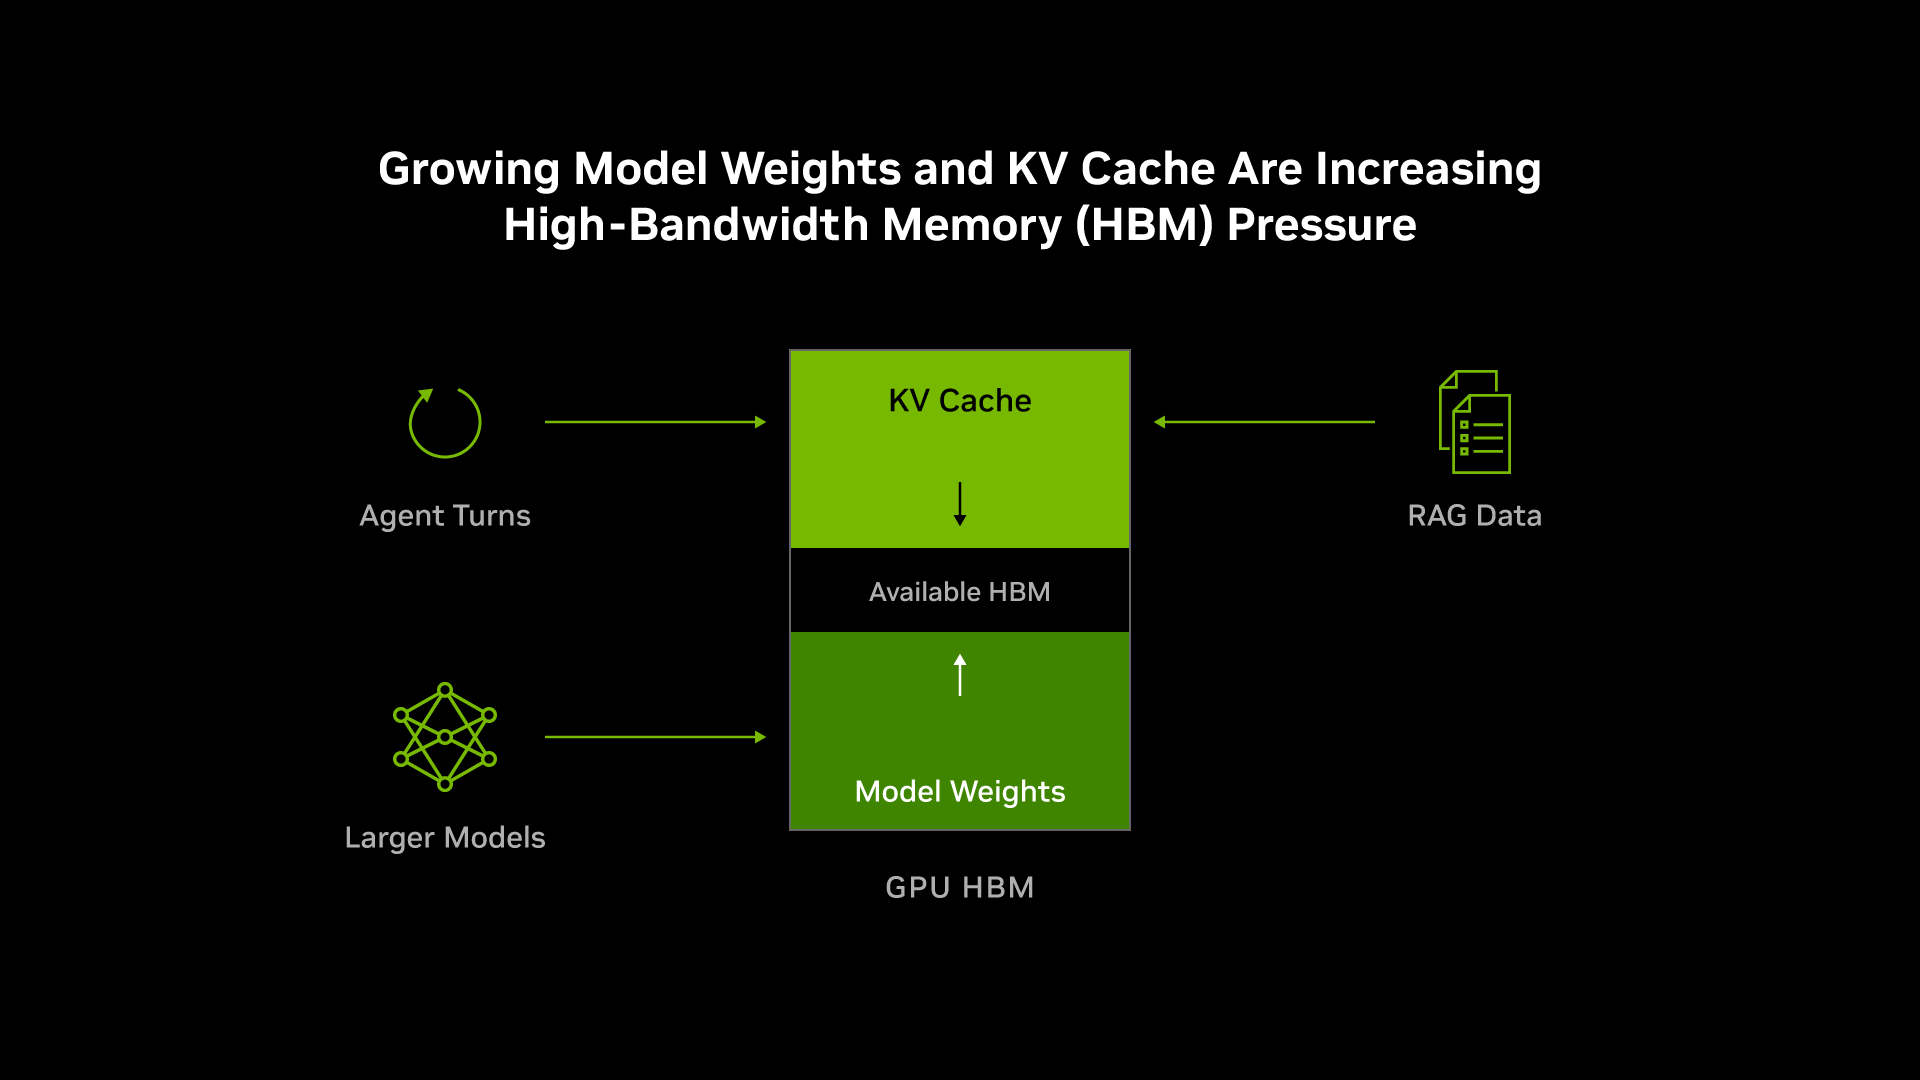
Các mô hình quy mô lớn hơn, độ dài ngữ cảnh tăng và các ứng dụng tác tử (agentic applications) đang gia tăng áp lực lên bộ nhớ GPU, trong bối cảnh nguồn cung bị thắt chặt và giá cả tăng cao — xu hướng được dự báo sẽ tiếp diễn trong thời gian tới.
NVIDIA đang hợp tác chặt chẽ với các đối tác sản xuất bộ nhớ nhằm nhanh chóng ứng dụng các công nghệ bộ nhớ mới nhất. NVIDIA là đơn vị đầu tiên tích hợp các công nghệ HBM3e và HBM4 vào ngăn xếp điện toán tăng tốc (accelerated computing stack).
Tuy nhiên, phương pháp tiếp cận không đơn thuần là tăng thêm dung lượng bộ nhớ trên GPU, mà là đồng thiết kế toàn diện (full-stack codesign). NVIDIA chủ động thiết kế đồng bộ GPU, CPU, hạ tầng mạng, hệ thống lưu trữ và phần mềm nhằm khai thác tối đa hiệu quả của bộ nhớ ở mọi tầng của
Quy mô mô hình ngày càng lớn, ngữ cảnh dài hơn cùng các ứng dụng tác tử (agentic applications) đang gia tăng áp lực lên bộ nhớ GPU trong bối cảnh nguồn cung thắt chặt và giá cả leo thang — xu hướng được dự báo sẽ tiếp diễn trong thời gian tới.
NVIDIA đang hợp tác chặt chẽ với các đối tác sản xuất bộ nhớ nhằm nhanh chóng ứng dụng các công nghệ tiên tiến nhất. NVIDIA là đơn vị đầu tiên đưa các công nghệ HBM3e và HBM4 vào ngăn xếp điện toán tăng tốc (accelerated computing stack).
Tuy nhiên, cách tiếp cận ở đây không đơn thuần là tích hợp thêm dung lượng bộ nhớ vào GPU, mà là đồng thiết kế toàn diện (full-stack codesign). NVIDIA chủ động thiết kế đồng bộ GPU, CPU, thiết bị mạng, bộ lưu trữ và phần mềm nhằm tối ưu hóa hiệu quả sử dụng bộ nhớ ở mọi tầng trong nhà máy AI (AI factory).
Điều này có ý nghĩa quan trọng bởi một nhà máy AI vận hành dựa trên hệ thống phân cấp bộ nhớ và lưu trữ. Bộ nhớ băng thông cao (HBM) của GPU là tầng nhanh nhất, đắt đỏ nhất và có mức độ cạnh tranh tài nguyên gay gắt nhất — nơi trọng số mô hình (model weights) và bộ nhớ đệm KV (KV cache) cạnh tranh dung lượng hạn hẹp. Bên dưới tầng này là bộ nhớ CPU, ổ SSD cục bộ và bộ lưu trữ dùng chung; mỗi tầng đều đánh đổi tốc độ để lấy dung lượng lớn hơn với chi phí trên mỗi bit thấp hơn.
Hiệu quả xử lý của từng byte dữ liệu phụ thuộc vào mức độ tối ưu của toàn bộ hệ thống phân cấp: thu gọn dữ liệu cần lưu trữ, phân bổ vào đúng tầng và đưa trở lại GPU trước thời điểm cần sử dụng.
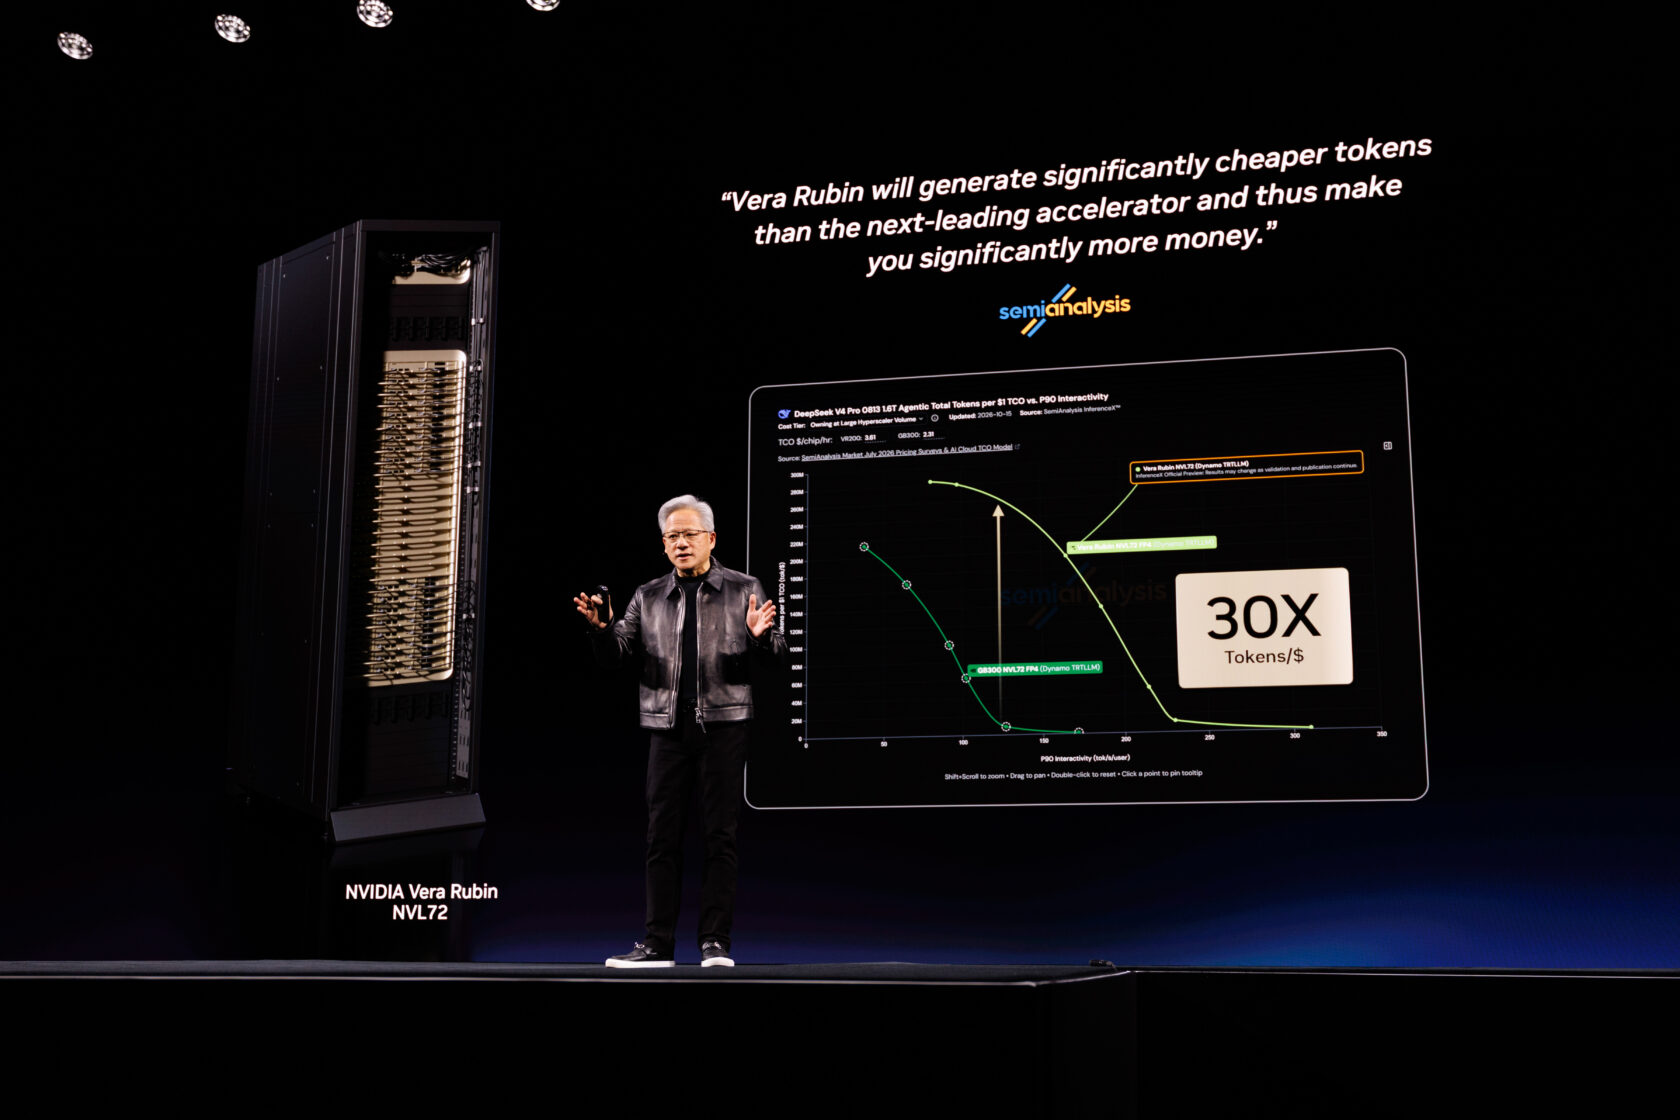
Xét trên từng byte, NVIDIA đạt hiệu suất sử dụng bộ nhớ tối ưu ở mọi tầng — điều này được thể hiện rõ qua các kết quả thực tế. Từ kiến trúc NVIDIA Blackwell Ultra đến nền tảng Vera Rubin, dung lượng HBM trên mỗi GPU chỉ tăng khoảng 3%, nhưng thông lượng tác tử tính trên mỗi USD chi phí đã tăng tới 30 lần theo đánh giá của SemiAnalysis AgentX.
Quá trình suy luận tác tử gia tăng áp lực lên HBM
Các mô hình AI tiên tiến hiện nay sở hữu hàng nghìn tỷ tham số — những giá trị chứa đựng toàn bộ tri thức mô hình đã tiếp thu qua quá trình huấn luyện.
Bộ nhớ đệm KV, nơi lưu trữ ngữ cảnh giúp mô hình hiểu từng yêu cầu đang xử lý mà không cần tính toán lại dữ liệu cũ, cũng đang mở rộng nhanh chóng. Tiến trình thực thi của các tác tử mang theo ngữ cảnh trước đó qua nhiều lần gọi mô hình và công cụ, trong một số trường hợp phải xử lý tới 3 triệu token, khiến bộ nhớ làm việc cho mỗi yêu cầu tăng dần theo thời gian.
Công nghệ tạo sinh tăng cường truy xuất (RAG) bổ sung thêm thông tin doanh nghiệp liên quan vào các câu lệnh (prompt), làm gia tăng khối lượng ngữ cảnh cần xử lý và duy trì.
Trong quá trình suy luận, HBM chủ yếu đảm nhiệm việc lưu trữ cả tham số mô hình lẫn bộ nhớ đệm KV. Kết quả là áp lực đè nặng lên HBM ngày càng gia tăng.
Vì sao các nhà máy AI cần hệ thống phân cấp bộ nhớ
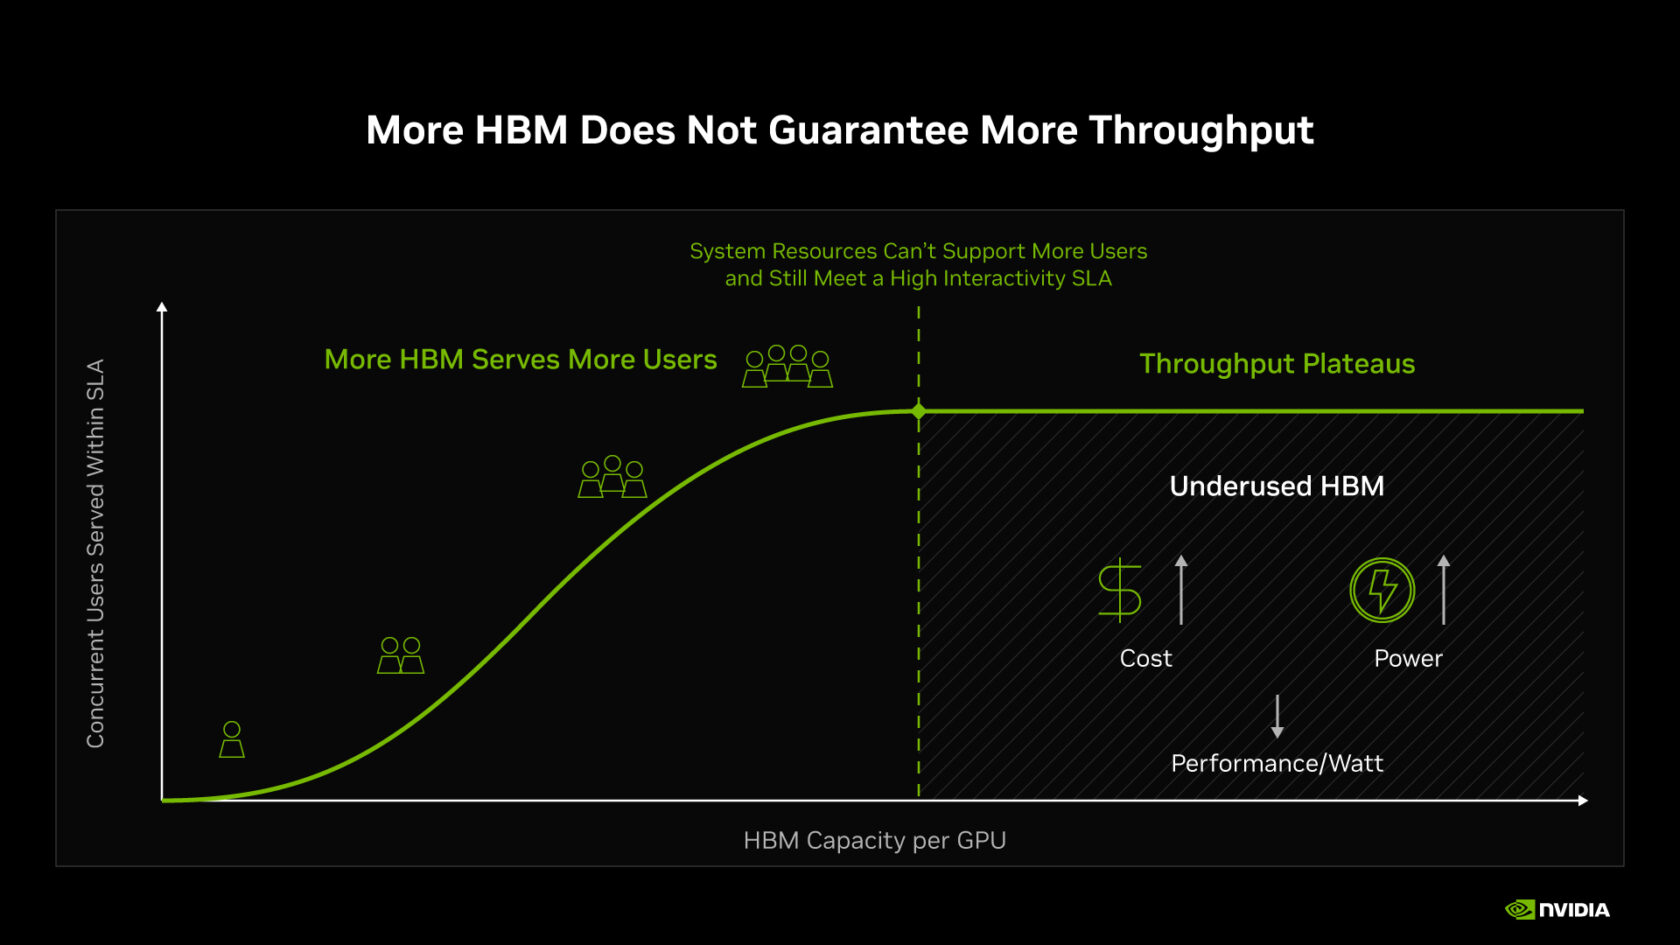
Tăng dung lượng HBM trên mỗi GPU là giải pháp hiển nhiên trước áp lực nói trên, song dung lượng chỉ phát huy giá trị trong giới hạn dữ liệu mà băng thông có thể vận chuyển.
Có thể hình dung HBM như một nhà kho và băng thông bộ nhớ là các cửa bốc dỡ hàng hóa. Kho lớn hơn chứa được nhiều hàng hơn, nhưng các cửa bốc dỡ mới quyết định khối lượng hàng hóa xuất nhập trong cùng một thời điểm. Khi các cửa này hoạt động hết công suất, việc luân chuyển thêm hàng hóa sẽ mất nhiều thời gian hơn và làm chậm tốc độ phản hồi. Nếu độ trễ vượt quá ngưỡng cam kết dịch vụ, không gian bổ sung sẽ không thể khai thác hiệu quả, trong khi vẫn làm tăng chi phí và tiêu hao thêm năng lượng.
Đây cũng là lý do không một quy trình vận hành nào lưu trữ toàn bộ hàng hóa ở vị trí gần nhất và nhanh nhất. Hàng hóa đang lưu chuyển được giữ gần dây chuyền. Hàng hóa ở trạng thái chờ được chuyển tới khu vực lân cận rộng hơn, chi phí thấp hơn và được chuyển trở lại trước khi cần dùng đến.
Một nhà máy AI cũng đối mặt với giới hạn tương tự.
Việc tăng HBM cho phép lưu trữ thêm bộ nhớ đệm KV và hỗ trợ số lượng người dùng đồng thời lớn hơn. Mỗi người dùng bổ sung đều dùng chung tài nguyên tính toán và băng thông bộ nhớ. Tuy nhiên, khi người dùng yêu cầu tốc độ phản hồi nhanh, băng thông bộ nhớ cuối cùng sẽ không thể cung cấp dữ liệu kịp với tốc độ xử lý của bộ tính toán: một giới hạn kỹ thuật được các kỹ sư gọi là bức tường bộ nhớ (memory wall).
Vượt quá giới hạn đó, dung lượng HBM bổ sung không thể phát huy hiệu quả, song vẫn làm tăng chi phí và tiêu hao năng lượng. Dữ liệu vẫn cần không gian lưu trữ, nhưng không phải mọi dữ liệu đều đòi hỏi tầng lưu trữ nhanh nhất và tốn kém nhất. Do đó, một nhà máy AI cần quản lý dữ liệu theo phân tầng bộ nhớ và lưu trữ.
Tối ưu hóa giá trị của từng byte dữ liệu thông qua đồng thiết kế toàn diện (full-stack codesign)
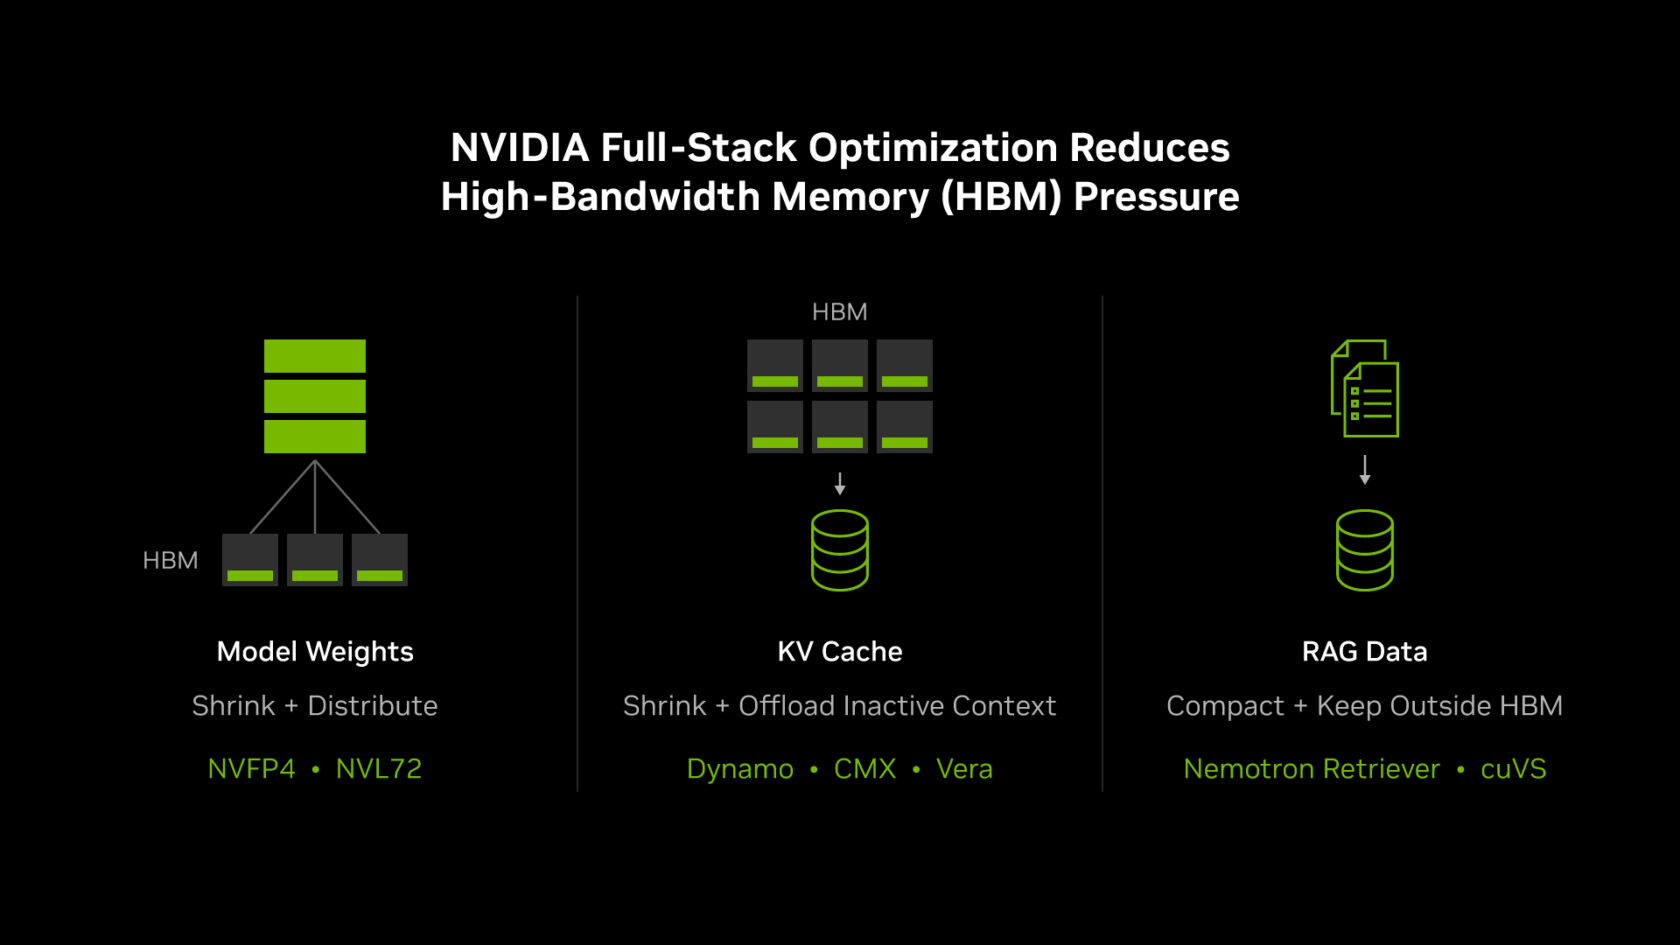
Chiến lược đồng thiết kế toàn diện của NVIDIA tối ưu hóa từng byte HBM bằng cách giải tỏa áp lực từ trọng số mô hình (model weights), KV cache và dữ liệu RAG. Quá trình này được thực hiện thông qua các kỹ thuật nhắm vào từng nguồn gây lãng phí tài nguyên:
Tinh giản trọng số mô hình và phân bổ trên toàn miền NVL72.
Định dạng NVFP4 giúp giảm không gian cần thiết cho trọng số so với FP8 – mức độ chính xác thấp nhất có thể đạt được trên nền tảng NVIDIA Hopper. Các mô hình gần đây, bao gồm FLUX.2 [klein] của Black Forest Labs, Inkling của Thinking Machines Lab, Beam 1.0 của Reflection, Meta Muse Spark của Meta, Step 5 Preview của StepFun và NVIDIA Nemotron 3.5 Super VL, đã được phát hành với các điểm kiểm tra (checkpoint) định dạng NVFP4. Điều này cho thấy xu hướng ngày càng gia tăng của các đơn vị phát triển mô hình trong việc áp dụng độ chính xác 4-bit nhằm nâng cao tốc độ và tối ưu hóa bộ nhớ khi suy luận.
Trong hệ thống NVL72, trọng số mô hình có thể được phân bổ trên tối đa 72 GPU, giúp mỗi GPU chỉ cần đảm nhận một phần nhỏ của mô hình; qua đó giải phóng thêm HBM cho KV cache và phục vụ nhiều người dùng đồng thời hơn.
Tinh giản KV cache và chuyển tải ngữ cảnh không hoạt động sang các tầng lưu trữ có chi phí thấp hơn.
Việc áp dụng định dạng NVFP4 cho KV cache giúp giảm dung lượng chiếm dụng so với FP8, cho phép lưu trữ nhiều ngữ cảnh hơn trong HBM.
CPU NVIDIA Vera hỗ trợ theo hai phương thức: Tốc độ thực thi công cụ nhanh hơn giúp rút ngắn thời gian KV cache ở trạng thái nhàn rỗi khi thực hiện lệnh gọi công cụ; đồng thời bộ nhớ LPDDR dung lượng lớn của CPU này, kết nối với các GPU NVIDIA Rubin qua giao tiếp NVLink-C2C, tạo ra không gian lưu trữ liền kề để ngữ cảnh tạm dừng có thể chờ đợi và truy xuất lại một cách nhanh chóng.
Khi ngữ cảnh không được sử dụng, phần mềm suy luận NVIDIA Dynamo sẽ chuyển ngữ cảnh đó sang bộ nhớ lưu trữ ngữ cảnh NVIDIA CMX — một tầng lưu trữ được thiết kế nhằm tối ưu dung lượng với chi phí trên mỗi bit thấp hơn đáng kể so với HBM — và đưa trở lại trước khi tái sử dụng. Khác với ổ SSD cục bộ, CMX được chia sẻ giữa các máy chủ; và khác với hệ thống lưu trữ doanh nghiệp, CMX loại bỏ các chi phí vận hành bảo vệ dữ liệu dài hạn không cần thiết đối với ngữ cảnh tồn tại ngắn hạn. Các đối tác lưu trữ bộ nhớ ngữ cảnh NVIDIA CMX bao gồm Cloudian, DDN, Dell Technologies, Everpure (trước đây là Pure Storage), HPE, IBM, NetApp, VAST và WEKA.
Tính năng tái sử dụng KV cache (KV Cache Reuse) của Dynamo liên kết các tầng lưu trữ lại với nhau, quản lý KV cache như một tài nguyên thống nhất trên toàn hệ thống bao gồm bộ nhớ GPU, bộ nhớ CPU và bộ nhớ lưu trữ, giúp ngữ cảnh sau khi tính toán một lần có thể được tái sử dụng trên toàn hệ thống.
Thu gọn không gian nhúng RAG và lưu trữ chỉ mục bên ngoài HBM.
RAG chuyển đổi tài liệu doanh nghiệp thành các vector nhúng (embeddings) — tức các biểu thức biểu diễn dạng số cho phép hệ thống tìm kiếm theo ngữ nghĩa thay vì từ khóa — và được sắp xếp thành một cấu trúc có thể tìm kiếm
Nguồn tin: NVIDIA AI Blog — Tác giả: Amr Elmeleegy. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.