
Together Compiler: Biên dịch liên tục phục vụ suy luận AI
Together Compiler sử dụng các tác tử (agent) và công cụ xử lý thường trực (persistent engine) để tối ưu hóa các mô hình mở trong vòng chưa đầy 24 giờ, đem lại thông lượng cao hơn tới 3,7 lần khi lưu lượng truy cập thay đổi.
Khối lượng công việc suy luận AI luôn biến động liên tục. Có hàng nghìn trạng thái vận hành khác nhau trải rộng trên các mô hình mới, nền tảng phần cứng, tệp khách hàng, trường hợp sử dụng và đặc tính lưu lượng truy cập. Việc tối ưu hóa thủ công cho từng trạng thái này không còn khả năng mở rộng.
Các kiến trúc mô hình có sự phân hóa mạnh: khoảng 11 năm đã trôi qua kể từ khi kiến trúc Transformer ra đời. Dù nhiều nhận định cho rằng các kiến trúc sẽ dần quy về một mối, nhưng không có mô hình nào trong nhóm 10 mô hình LLM mã nguồn mở hàng đầu trên OpenRouter sử dụng cùng một kiến trúc.
Khối lượng công việc có độ biến thiên cao: Together xử lý hàng nghìn tỷ token mỗi ngày cho hàng nghìn khách hàng, với từng đặc tính lưu lượng riêng biệt (kích thước lô - batch size, độ dài chuỗi, sự mất cân bằng chuyên gia MoE, độ thưa thớt của cơ chế attention, thời lượng phiên làm việc và lĩnh vực áp dụng).
Phần cứng có sự đa dạng lớn: các dòng H100, B200, B300, NVL72, VR, Groq cùng nhiều nền tảng khác đều đòi hỏi những chiến lược tối ưu hóa riêng biệt.
Về mặt lý thuyết, các hệ thống tác tử (agent) rất phù hợp để giải quyết vấn đề này. Các tác tử có thể thích ứng với khối lượng công việc mới và tìm kiếm trong không gian tối ưu hóa tiềm năng mà không phụ thuộc vào các quy tắc cố định hay phương pháp kinh nghiệm (heuristics) vốn gây trở ngại cho các chuyên gia và trình biên dịch học máy truyền thống. Tuy nhiên, các hệ thống tác tử hiện nay đang gặp điểm nghẽn về tốc độ thử nghiệm.
Together Compiler (TKCC) được giới thiệu là vòng lặp tối ưu hóa liên tục thực thụ đầu tiên, ứng dụng các tác tử có thông lượng cao để tối ưu hóa cho nhiều khối lượng công việc suy luận khác nhau.
Trong vòng chưa đầy 24 giờ, TKCC đạt tốc độ xử lý token trên giây (TPS) cao hơn tới 2,6 lần trên các mô hình mã nguồn mở tiên tiến (Kimi K3, GLM 5.3, MiniMax M3.1-Flash, DeepSeek v4.1-Flash); thiết lập kỷ lục mới trên bảng đo chuẩn InferenceX của SemiAnalysis về độ trễ thấp với 1.111 TPS trên MiniMax M3.1-Flash và 1.205 TPS trên DeepSeek v4.1-Flash; đồng thời vượt trội hơn 1,7 lần so với các megakernel mã nguồn mở hiện có trong cấu hình tiêu chuẩn Llama 1B với kích thước lô bằng 1 (batch size 1). Ngoài ra, TKCC còn có khả năng mở rộng sang các lĩnh vực ngoài suy luận mô hình ngôn ngữ (như mô hình hóa thời tiết, phương trình vi phân đạo hàm riêng - PDE, chuỗi thời gian và sinh học). Sự gia tăng hiệu năng này đạt được nhờ thông lượng thử nghiệm của TKCC cao hơn 252 lần so với các hệ thống tối ưu hóa hiệu năng bằng tác tử cơ sở. Hiện tại, Together Compiler đang phục vụ hàng nghìn tỷ token mỗi ngày.
Lưu lượng truy cập biến đổi liên tục
Với tư cách là đơn vị cung cấp dịch vụ suy luận, Together ghi nhận nhiều hành vi người dùng khác nhau dựa trên đặc thù khu vực, các đợt phát hành mô hình mới và tính chất bùng nổ lưu lượng đột biến.
Đặc thù khu vực: Người dùng trên thế giới có xu hướng lựa chọn mô hình khác nhau. Thực tế ghi nhận lưu lượng trong giờ làm việc tại một quốc gia có độ dài câu lệnh (prompt) gấp 1,4 lần so với một quốc gia khác (97.000 so với 70.000).
Các đợt phát hành mô hình mới: Người dùng cần thời gian để tìm hiểu cách tích hợp các mô hình mới phát hành vào quy trình làm việc. Ban đầu, người dùng có xu hướng tương tác qua hội thoại và đánh giá thử nghiệm. Ngay sau đó, độ dài câu lệnh tăng 80% chỉ sau hai tuần kể từ thời điểm phát hành khi người dùng chuyển dịch sang các tác vụ dựa trên tác tử.
Tính chất bùng nổ đột biến: Khách hàng có thể gửi lượng lớn yêu cầu đột ngột vào các thời điểm bất kỳ trong ngày. Độ dài câu lệnh có thể tăng gấp đôi bất ngờ và tỷ lệ trúng bộ nhớ đệm (cache hit rate) có nguy cơ sụt giảm nếu không được xử lý cẩn trọng.
Rõ ràng, việc thích ứng với hành vi người dùng liên tục thay đổi đòi hỏi các giải pháp tối ưu hóa chuyên biệt cho từng đợt triển khai mới.
Tổng quan về Together Compiler
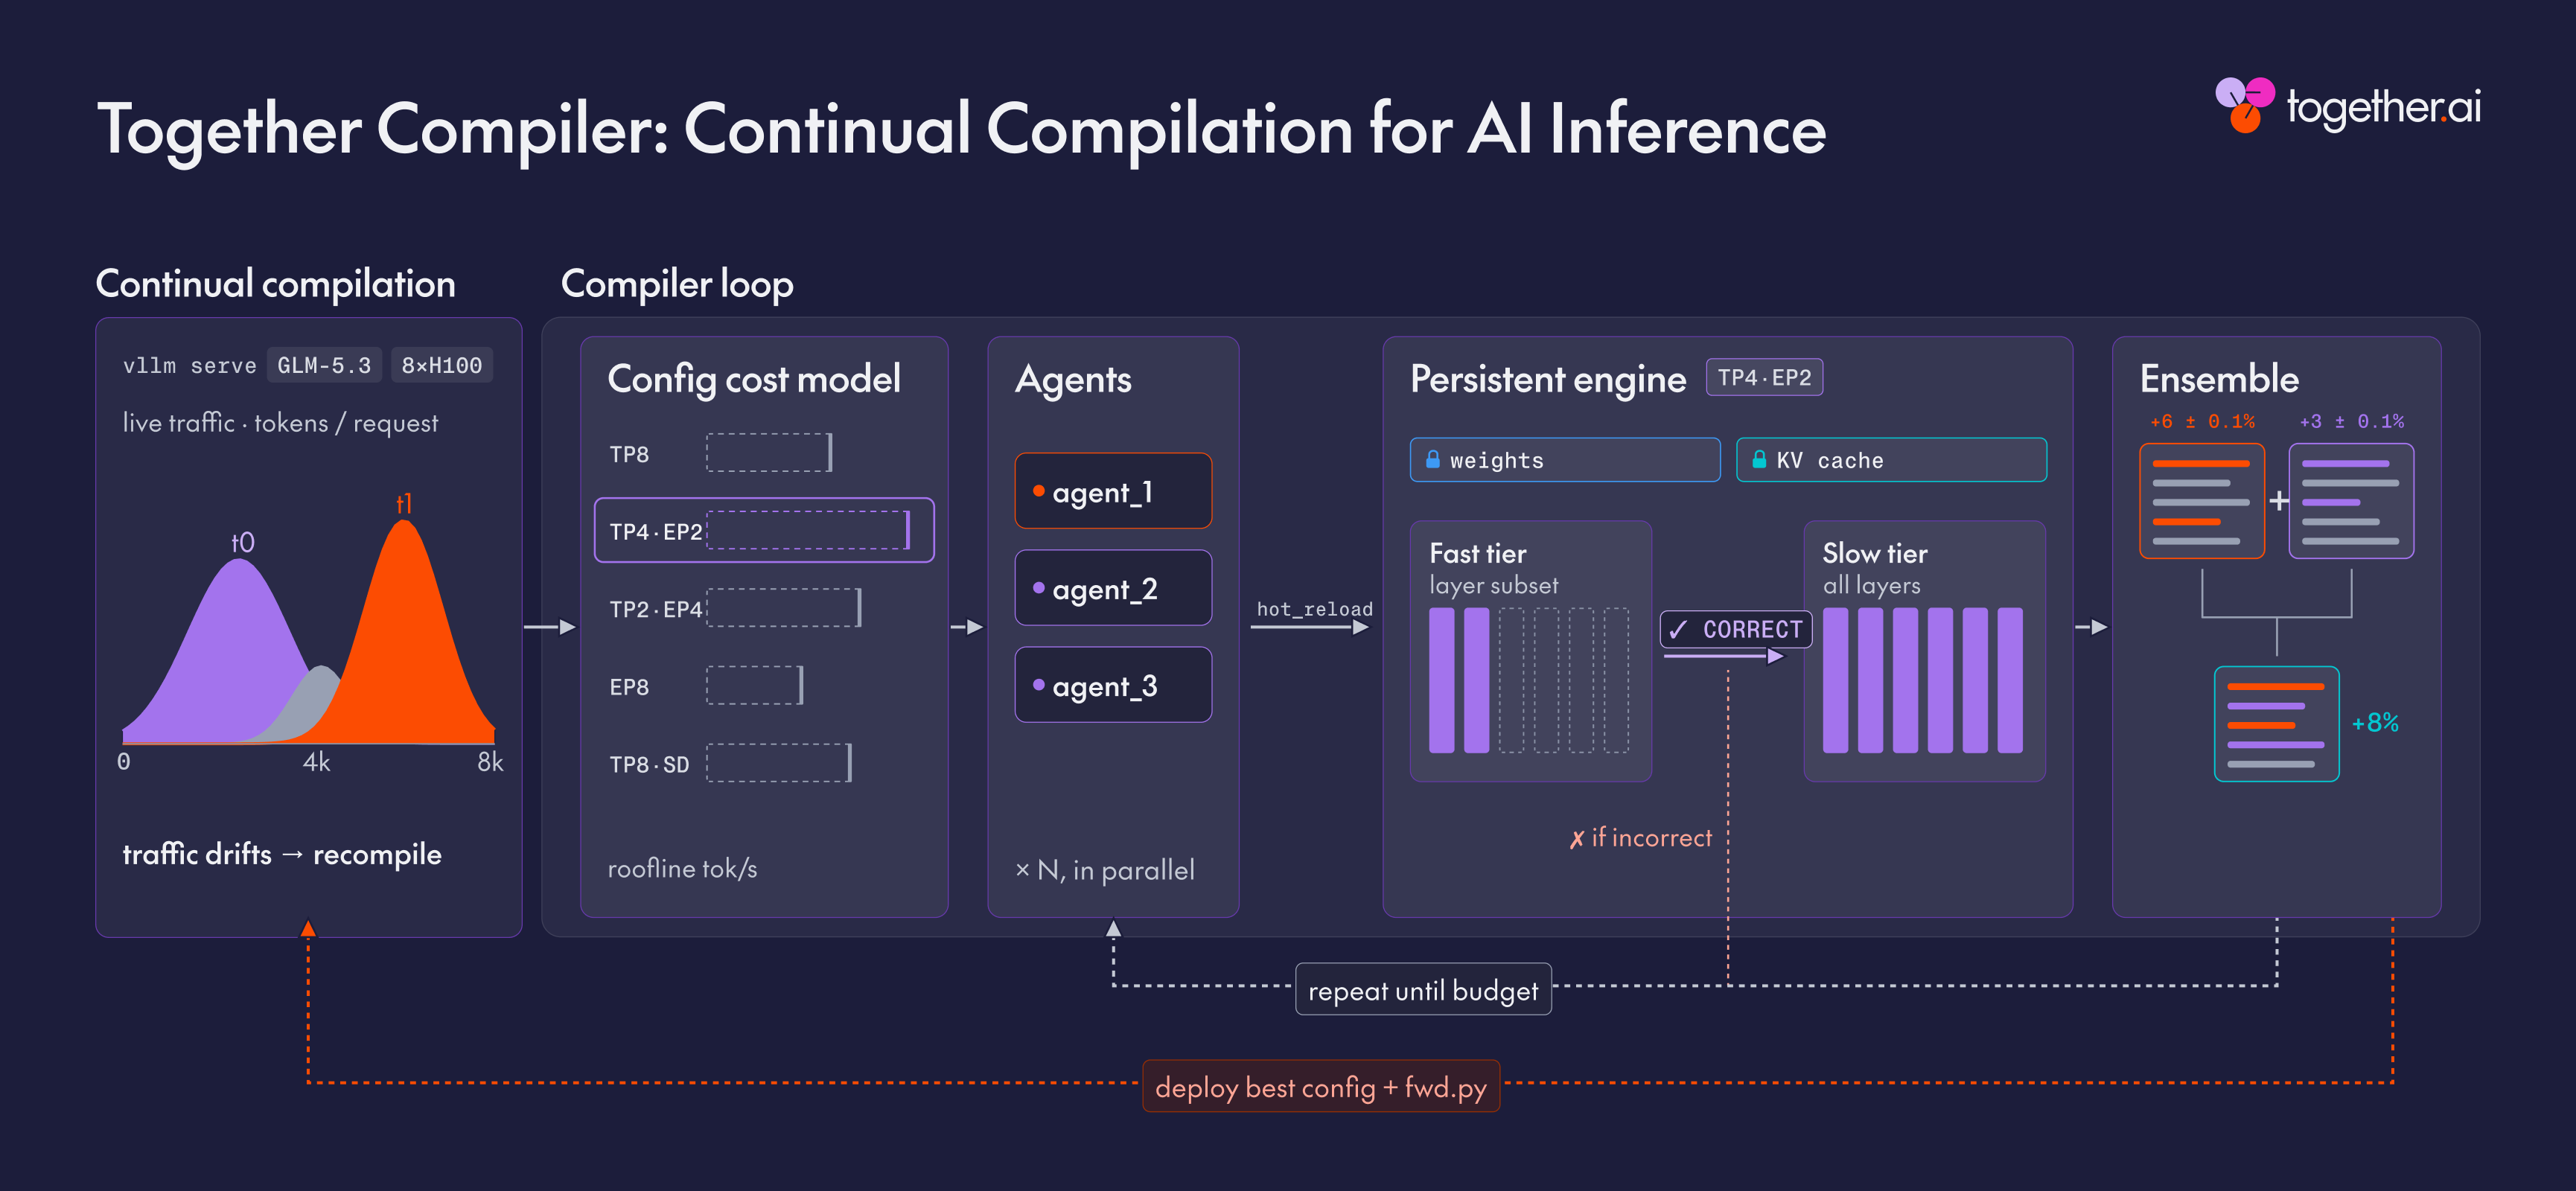
TKCC tiếp nhận đầu vào gồm đặc tính lưu lượng truy cập, mô hình và phần cứng, sau đó sử dụng các tác tử để tạo ra một chuỗi giải pháp tối ưu hóa cho công cụ suy luận.
Hình 1: Together Compiler thực hiện biên dịch lại khi lưu lượng truy cập thay đổi, kết hợp các tác tử (agent), một engine duy trì liên tục và một mô hình kết hợp trong vòng lặp. Những phát hiện cốt lõi của TKCC bao gồm:
1. TKCC tối đa hóa thông lượng thử nghiệm và giảm thiểu thời gian chờ của GPU trong quá trình tác tử tối ưu hóa
Hầu hết các hệ thống tối ưu hóa suy luận dựa trên tác tử hiện nay đều yêu cầu tác tử phải khởi chạy và đóng các engine như vLLM, SGLang hoặc TRT-LLM để kiểm tra từng thử nghiệm mới. Tuy nhiên, thời gian khởi động engine kéo dài hàng chục phút, gây cản trở đáng kể đến thông lượng thử nghiệm (xem bảng bên dưới). Thay vào đó, TKCC đề xuất mô hình mới về "engine duy trì liên tục", trong đó engine chỉ khởi động một lần và có thể nạp trực tiếp (hot-reload) bất kỳ lượt truyền xuôi (forward pass) tiềm năng nào mà không cần khởi động lại. Để bảo đảm các engine duy trì liên tục luôn có những phương án tối ưu hóa mới nhằm thử nghiệm, TKCC khởi tạo nhiều tác tử liên tục đưa ra ý tưởng và trao đổi qua bảng tin nội bộ để xử lý song song các nhiệm vụ.
Giai đoạn
Hiện trạng (giây)
Together Compiler (giây)
Khởi tạo tiến trình và worker
93
–
Tải trọng số
50
–
Định cỡ KV-cache
21
–
Khởi động nhân JIT (JIT kernel warm-up)
93
–
Tự động vi chỉnh (Autotuning)
193
–
Máy chủ API sẵn sàng
10
–
Gọi RPC và thiết lập Together Compiler
–
1,7
Ghi nhận đồ thị CUDA (CUDA-graph capture)
7
7,3
Tổng thời gian sẵn sàng phục vụ
467
9,0
Bảng 1: Quá trình khởi động engine tiêu tốn nhiều thời gian
2. TKCC cân bằng giữa thông lượng đo lường và độ trung thực của phép đo
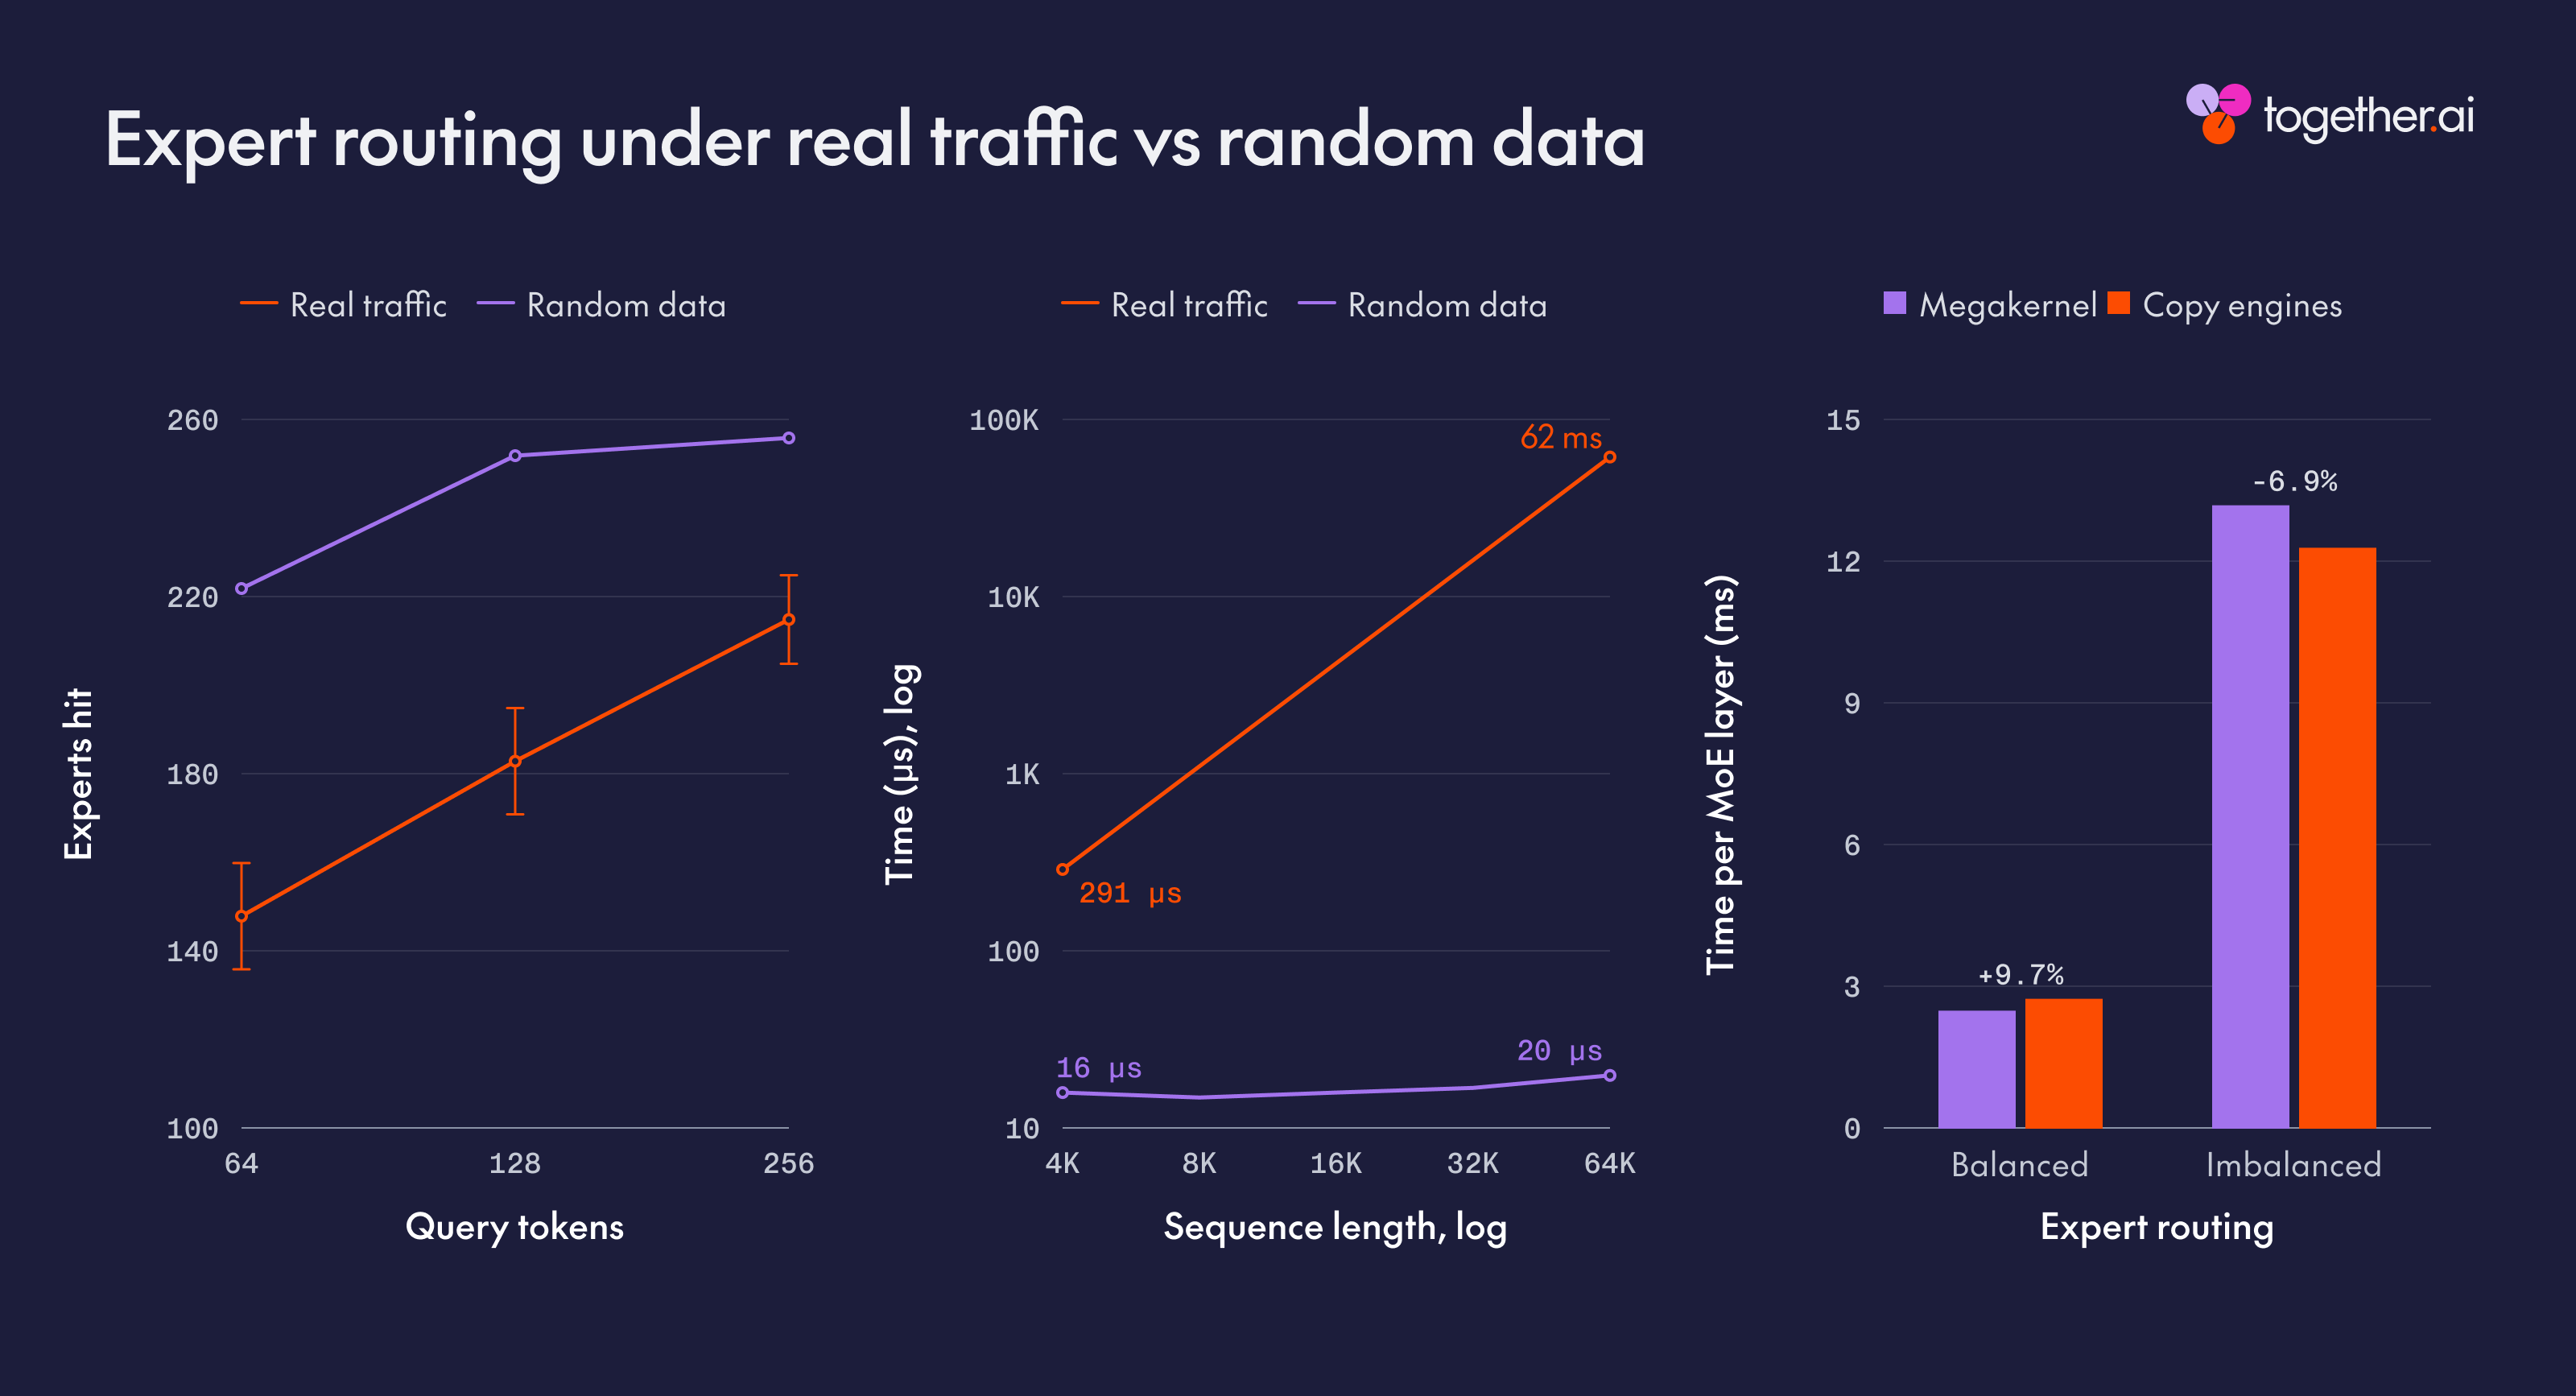
Các hệ thống tối ưu hóa tác tử hiện nay hoặc liên tục khởi động lại engine suy luận khiến thông lượng thử nghiệm thấp, hoặc tối ưu hóa các nhân (kernel) độc lập một cách riêng lẻ bên ngoài engine suy luận dẫn đến độ trung thực của phép đo không cao. Những hệ thống tối ưu hóa kernel độc lập thường đánh giá thông qua dữ liệu đầu vào ngẫu nhiên. Tuy nhiên, với các kiến trúc hiện đại sử dụng những thành phần phụ thuộc vào dữ liệu như MoE và cơ chế chú ý sparse-k, phân phối dữ liệu đầu vào có ảnh hưởng trực tiếp đến việc chiến lược tối ưu hóa nào sẽ mang lại hiệu quả vượt trội (xem hình bên dưới). Dữ liệu đầu vào có độ trung thực cao đóng vai trò then chốt cho quá trình tối ưu hóa hiệu quả. TKCC sử dụng hệ thống engine duy trì liên tục phân tầng nhằm cân bằng giữa thông lượng và độ trung thực: các "engine nhanh" tải một vài tầng và là lựa chọn lý tưởng cho việc lặp nhanh với độ biến thiên thời gian thấp, trong khi các "engine chậm hơn" tải nhiều tầng và thích hợp để kiểm tra mức độ duy trì hiệu quả tối ưu hóa trên các phân phối dữ liệu thực tế.
Hình 2: Dữ liệu đầu vào làm thay đổi các chiến lược tối ưu hóa.
Hình 3: Kiến trúc hai tầng của Together Compiler vượt trội so với các phương án thay thế. 3. TKCC sử dụng mô hình chi phí tùy chỉnh để lựa chọn các chiến lược song song hóa (ví dụ: TP, EP, DCP...) nhằm giúp các tác tử đạt hiệu năng cao nhất
Các hệ thống hiện tại sở hữu những phương pháp phức tạp để lựa chọn cấu hình suy luận đáp ứng yêu cầu thỏa thuận mức dịch vụ (SLA). Tuy nhiên, việc lựa chọn cấu hình lý tưởng cũng đối mặt với sự đánh đổi tương tự giữa thông lượng và độ trung thực: việc đo lường từng cấu hình song song hóa là bất khả thi, đặc biệt là do phần mềm


Nguồn tin: Together AI Blog. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.