
Tinh chỉnh (Fine-Tuning) so với Vector nhúng cố định (Frozen Embeddings): Thời điểm nên điều chỉnh LLM hay tầng phân loại Sklearn
Bài viết này phân tích phương pháp so sánh hai chiến lược thích ứng mô hình ngôn ngữ lớn (LLM) cho một lĩnh vực cụ thể: tinh chỉnh (fine-tuning) bằng LoRA so với...
Fine-Tuning so với Frozen Embeddings: Lựa chọn điều chỉnh LLM hay đầu phân loại Sklearn
Tác giả: Iván Palomares Carrascosa, ngày 27/10/2026, chuyên mục Language Models 0
Chia sẻ
Đăng bài
Chia sẻ
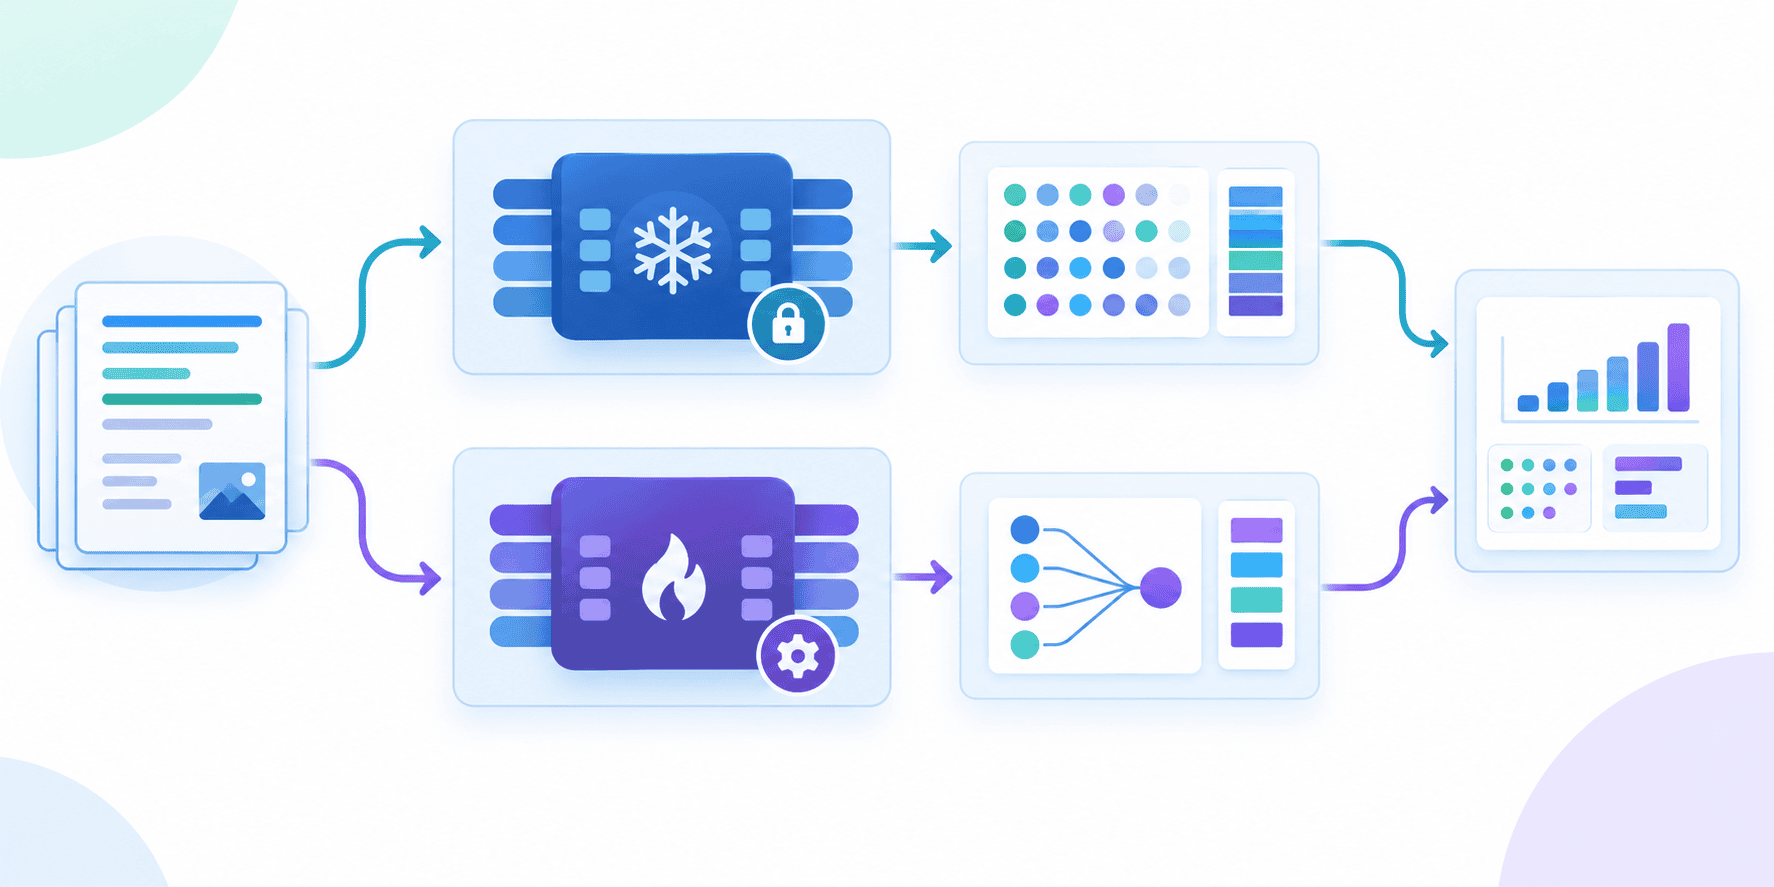
Bài viết này phân tích và so sánh hai chiến lược thích ứng mô hình ngôn ngữ lớn (LLM) với một lĩnh vực chuyên biệt: tinh chỉnh (fine-tuning) bằng LoRA và huấn luyện bộ phân loại scikit-learn trên các vector nhúng cố định (frozen embeddings).
Các nội dung chính bao gồm:
Cơ chế hoạt động của frozen embeddings như một giải pháp thay thế tinh gọn cho việc tinh chỉnh toàn bộ mô hình, cùng các trường hợp áp dụng phù hợp.
Cách thức triển khai tinh chỉnh QLoRA bằng thư viện PEFT kết hợp với mô hình Hugging Face và một đầu phân loại (classification head).
So sánh hai chiến lược về thời gian huấn luyện và độ chính xác phân loại trên tập dữ liệu thực tế.
Giới thiệu
Khi điều chỉnh một mô hình ngôn ngữ lớn (LLM) cho một lĩnh vực cụ thể, phương pháp kinh điển được cộng đồng học máy (machine learning) lựa chọn là tinh chỉnh mô hình trên tập dữ liệu chuyên ngành. Tuy nhiên, vấn đề đặt ra là: liệu quy trình này có luôn cần thiết, hay các chiến lược thay thế như sử dụng frozen embeddings kết hợp với các bộ phân loại hạ nguồn (downstream classifiers) gọn nhẹ trên mô hình sẽ là hướng tiếp cận tối ưu hơn, đặc biệt khi xây dựng các ứng dụng tiết kiệm chi phí và bị giới hạn tài nguyên tính toán?
Bài viết cung cấp một thử nghiệm so sánh thực tế giữa việc tinh chỉnh LLM cục bộ bằng LoRA (Low-Rank Adaptation, thuật toán cập nhật trọng số hiệu quả) và việc chỉ huấn luyện bộ phân loại hạ nguồn scikit-learn trên frozen embeddings; đồng thời phân tích, đánh giá thời điểm nên ưu tiên từng chiến lược dựa trên chi phí và hiệu năng.
Để theo dõi hiệu quả ví dụ thực hành dưới đây, người đọc cần có kiến thức cơ bản về LLM, các quy trình then chốt như tinh chỉnh mô hình và các thư viện liên quan như transformers của Hugging Face.
Thiết lập ban đầu
Trường hợp thực hiện thử nghiệm trên Google Colab, môi trường thực thi cần được thiết lập sang GPU (T4), do mã nguồn và các phương pháp áp dụng đều được tối ưu hóa cho GPU. Các thư viện cần cài đặt gồm:
!pip install -q -U bitsandbytes peft accelerate evaluate
1
!pip install -q -U bitsandbytes peft accelerate evaluate
Trong các môi trường Python khác, các thư viện scikit-learn, transformers và datasets cũng cần được cài đặt đầy đủ trước khi tiếp tục.
Quy trình bắt đầu bằng việc khai báo các gói thư viện cần thiết và tải tập dữ liệu chuẩn ag_news từ kho lưu trữ Hugging Face, bao gồm các bài báo đã được phân loại theo chủ đề.
import torch
import numpy as np
import time
from datasets import load_dataset
from transformers import AutoTokenizer, AutoModelForSequenceClassification, BitsAndBytesConfig
# Để sử dụng Llama-3, thay đổi thành "meta-llama/Meta-Llama-3-8B"
MODEL_ID = "Qwen/Qwen2.5-1.5B"
print("1. Loading dataset...")
dataset = load_dataset("fancyzhx/ag_news")
# Sử dụng một tập hợp con nhỏ để quá trình so sánh trên GPU hoàn tất trong vài phút thay vì nhiều giờ
train_subset = dataset["train"].shuffle(seed=42).select(range(800))
test_subset = dataset["test"].shuffle(seed=42).select(range(200))
1
2
3
4
5
6
7
8
9
10
11
12
13
14
import torch
import numpy as np
import time
from datasets import load_dataset
from transformers import AutoTokenizer, AutoModelForSequenceClassification, BitsAndBytesConfig
# Để sử dụng Llama-3, thay đổi thành "meta-llama/Meta-Llama-3-8B"
MODEL_ID = "Qwen/Qwen2.5-1.5B"
print("1. Loading dataset...")
dataset = load_dataset("fancyzhx/ag_news")
# Sử dụng một tập con nhỏ để việc so sánh thực thi trong vài phút thay vì nhiều giờ trên GPU
train_subset = dataset["train"].shuffle(seed=42).select(range(800))
test_subset = dataset["test"].shuffle(seed=42).select(range(200))
Tiếp theo, tiến hành tải mô hình cùng bộ tách từ (tokenizer) liên kết, bảo đảm cấu hình đầu phân loại (classification head) tương thích với bài toán (tập dữ liệu) cụ thể, trong đó các bài báo được phân chia thành bốn nhóm xác định:
print("2. Configuring Tokenizer...")
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
tokenizer.pad_token = tokenizer.eos_token # Cần thiết cho các mô hình decoder-only
print("3. Loading Base Model in 4-bit...")
bnb_config = BitsAndBytesConfig(
load_in_4bit=True,
bnb_4bit_compute_dtype=torch.bfloat16,
bnb_4bit_quant_type="nf4"
)
# Tải mô hình cùng đầu phân loại
model = AutoModelForSequenceClassification.from_pretrained(
MODEL_ID,
num_labels=4,
quantization_config=bnb_config,
device_map="auto"
)
model.config.pad_token_id = tokenizer.pad_token_id
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
print("2. Configuring Tokenizer...")
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
tokenizer.pad_token = tokenizer.eos_token # Cần thiết cho các mô hình decoder-only
print("3. Loading Base Model in 4-bit...")
bnb_config = BitsAndBytesConfig(
load_in_4bit=True,
bnb_4bit_compute_dtype=torch.bfloat16,
bnb_4bit_quant_type="nf4"
)
# Tải mô hình cùng đầu phân loại
model = AutoModelForSequenceClassification.from_pretrained(
MODEL_ID,
num_labels=4,
quantization_config=bnb_config,
device_map="auto"
)
model.config.pad_token_id = tokenizer.pad_token_id
Chiến lược A: Véc-tơ nhúng đóng băng & Scikit-learn
Quy trình bắt đầu bằng việc thử nghiệm phương án thay thế cho kỹ thuật tinh chỉnh (fine-tuning) mô hình. Nguyên lý hoạt động như sau: thay vì tái huấn luyện LLM, hệ thống sử dụng mô hình này thuần túy như một bộ trích xuất đặc trưng (feature extractor). Văn bản được đưa qua “mô hình đóng băng” (nơi các trọng số không đổi) để trích xuất trạng thái ẩn cuối cùng (véc-tơ nhúng) của token kết thúc. Các véc-tơ nhúng đa chiều này sau đó được chuyển đến một mô hình phụ trợ — nhằm huấn luyện một bộ phân loại truyền thống gọn nhẹ trên nền tảng LLM đã đóng băng.
Bước đầu tiên là thiết lập hàm xử lý logic để trích xuất các véc-tơ nhúng đóng băng từ văn bản đầu vào:
from sklearn.ensemble import RandomForestClassifi

Nguồn tin: Machine Learning Mastery — Tác giả: Iván Palomares Carrascosa. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.