
Thị giác máy tính: Thuật toán SIFT (Scale Invariant Feature Transform)
Ghép nối đối tượng tinh xảo từ nhiều góc nhìn. Bài viết Computer Vision: SIFT algorithm (Scale Invariant Feature Transform) xuất hiện lần đầu trên Towards Data Science.
Trí tuệ nhân tạo
Thị giác máy tính: Thuật toán SIFT (Scale Invariant Feature Transform)
Ghép nối đối tượng tinh tế từ nhiều góc nhìn
Slava Efimov
Ngày 5 tháng 10 năm 2026
12 phút đọc
Giới thiệu
SIFT là một trong những thuật toán nổi tiếng nhất trong lĩnh vực thị giác máy tính. Mục tiêu cốt lõi của thuật toán này là phát hiện các điểm đặc trưng (keypoint) của đối tượng, tạo ra các bộ mô tả (descriptor) cho chúng và ghép nối các đối tượng tương tự giữa các hình ảnh.
Đúng như tên gọi, SIFT là một thuật toán bất biến theo tỷ lệ (scale-invariant), nghĩa là cùng một đối tượng có thể xuất hiện ở các tỷ lệ khác nhau trong một cặp hình ảnh, và SIFT vẫn có thể phát hiện thành công các điểm đặc trưng của nó.
Ngoài ra, SIFT còn bất biến theo phép quay (rotation-invariant), giúp việc ghép nối các đối tượng bị xoay trở nên khả thi.
Chúng ta hãy cùng tìm hiểu sâu hơn về cách SIFT hoạt động.
Lưu ý: Trong bài viết này, chúng tôi sẽ đề cập đến Laplacian of Gaussian (LoG) như một phép biến đổi được sử dụng để phát hiện cạnh trong hình ảnh. Nếu bạn chưa quen thuộc với kỹ thuật này, bạn nên tham khảo một trong các bài viết về phát hiện cạnh.
Hãy tìm hiểu từng bước với lộ trình Học máy (Machine Learning) tương tác.
Tìm kiếm các điểm quan tâm
Trong quy trình làm việc của mình, SIFT xây dựng một số phiên bản của hình ảnh gốc bằng cách áp dụng các phép biến đổi thay đổi kích thước (resize) và làm mờ Gaussian (Gaussian blur).
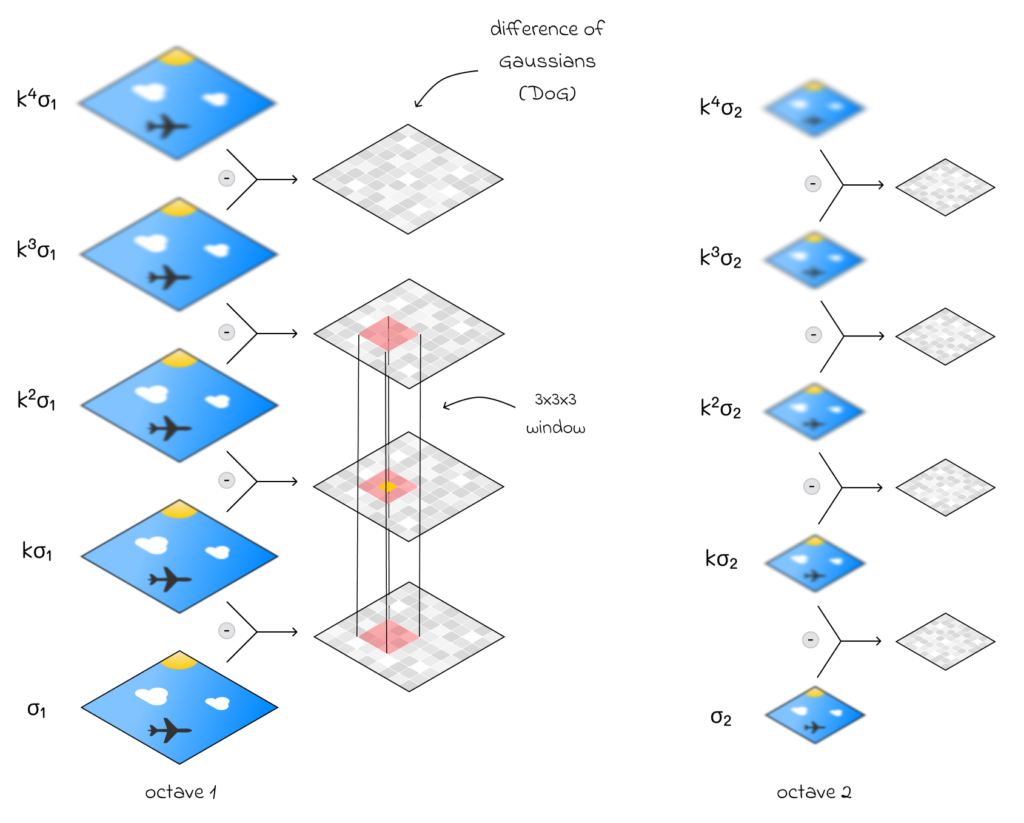
Để đơn giản, hãy hình dung I(x, y) là một hình ảnh gốc. Đầu tiên, với các giá trị k và σ1 đã chọn, SIFT xây dựng một số phiên bản của hình ảnh gốc bằng cách áp dụng làm mịn Gaussian với các độ lệch chuẩn khác nhau: σ1, k⋅σ1, k2⋅σ1, k3⋅σ1, ... , trong đó k > 1.
Điều này tạo ra một chuỗi hình ảnh, trong đó mỗi hình ảnh tiếp theo mờ hơn một chút so với hình ảnh trước đó. Chuỗi hình ảnh này được gọi là một quãng tám (octave).
Sau đó, SIFT tính toán sự khác biệt từng cặp D1, D2, …, Dn giữa các hình ảnh thu được, được gọi là hiệu của các hàm Gaussian (Difference of Gaussians – DoG). Những khác biệt này làm nổi bật các pixel có sự thay đổi cường độ cao. Sau đó, thuật toán xếp chồng các Di và cố gắng tìm các cực trị cục bộ trong chúng. Cách thực hiện như sau:
Đối với mỗi điểm trong Di(x, y), SIFT kiểm tra 26 điểm lân cận của nó:
8 điểm liền kề trên cấp độ Di;
9 điểm ngay phía trên Di(x, y) (trên cấp độ Di+1);
9 điểm ngay phía dưới Di(x, y) (trên cấp độ Di-1);
Sau đó, một trong ba trường hợp sau có thể xảy ra:
Nếu Di(x, y) lớn hơn tất cả 26 điểm lân cận của nó, thì SIFT đánh dấu nó là một cực đại.
Nếu Di(x, y) nhỏ hơn tất cả 26 điểm lân cận, thì SIFT đánh dấu nó là một cực tiểu;
Nếu không, điểm Di(x, y) sẽ bị bỏ qua.
Để đơn giản, điểm Di(x, y) và 26 điểm lân cận của nó có thể được hình dung như một lưới 3x3x3 với tâm tại Di(x, y). Quy trình này cho phép xác định các đặc trưng mạnh nhất.
Các giá trị cực trị được tìm thấy đại diện cho các điểm quan tâm. Trên thực tế, có thể có quá nhiều điểm như vậy; đó là lý do tại sao SIFT áp dụng ngưỡng (thresholding) hoặc một toán tử khác để chỉ giữ lại những điểm đại diện cho những thay đổi lớn nhất.
Để tính đến các biến thể tỷ lệ khác nhau, cùng một quy trình được lặp lại cho một hình ảnh ban đầu đã được giảm (lấy mẫu xuống – downsampled) về chiều rộng và chiều cao theo hệ số hai. Kết quả là, một chuỗi quãng tám mới được xây dựng với nhiễu Gaussian lớn hơn được áp dụng cho nó, với các giá trị σ sau: σ2, k⋅σ2, k2⋅σ1, k3⋅σ2, ... , trong đó σ2 = 2σ1. Như trước đây, các giá trị cực trị được tìm thấy từ sự khác biệt hình ảnh bằng cách sử dụng phương pháp lưới 3x3x3.
Một ví dụ về hai quãng tám (octave) được xây dựng. Mỗi quãng tám chứa 5 hình ảnh với mức độ làm mờ tăng dần. Hình ảnh đầu tiên (thấp nhất) trong quãng tám thứ hai là sự tiếp nối hợp lý của hình ảnh cuối cùng (cao nhất) trong quãng tám thứ nhất. Mặc dù có thể có giá trị σ thấp hơn, điều này được bù đắp bằng kích thước hình ảnh đã được lấy mẫu giảm (downsampled).
Đối với lần lặp thứ ba, hình ảnh được lấy mẫu giảm một lần nữa (giảm chiều rộng và chiều cao theo hệ số hai), và một quãng tám mới, mờ hơn được xây dựng với các giá trị σ là σ3, k⋅σ3, k2⋅σ3, k3⋅σ3, ... , trong đó σ3 = 2σ2 = 4σ1.
Toàn bộ quá trình được lặp lại cho một số lần lặp xác định.
**Trực giác**
Chúng ta đã hiểu cách tìm các điểm quan tâm. Bây giờ, hãy trả lời một số câu hỏi quan trọng để xây dựng trực giác về quá trình này.
**Tại sao sử dụng DoG thay vì LoG?**
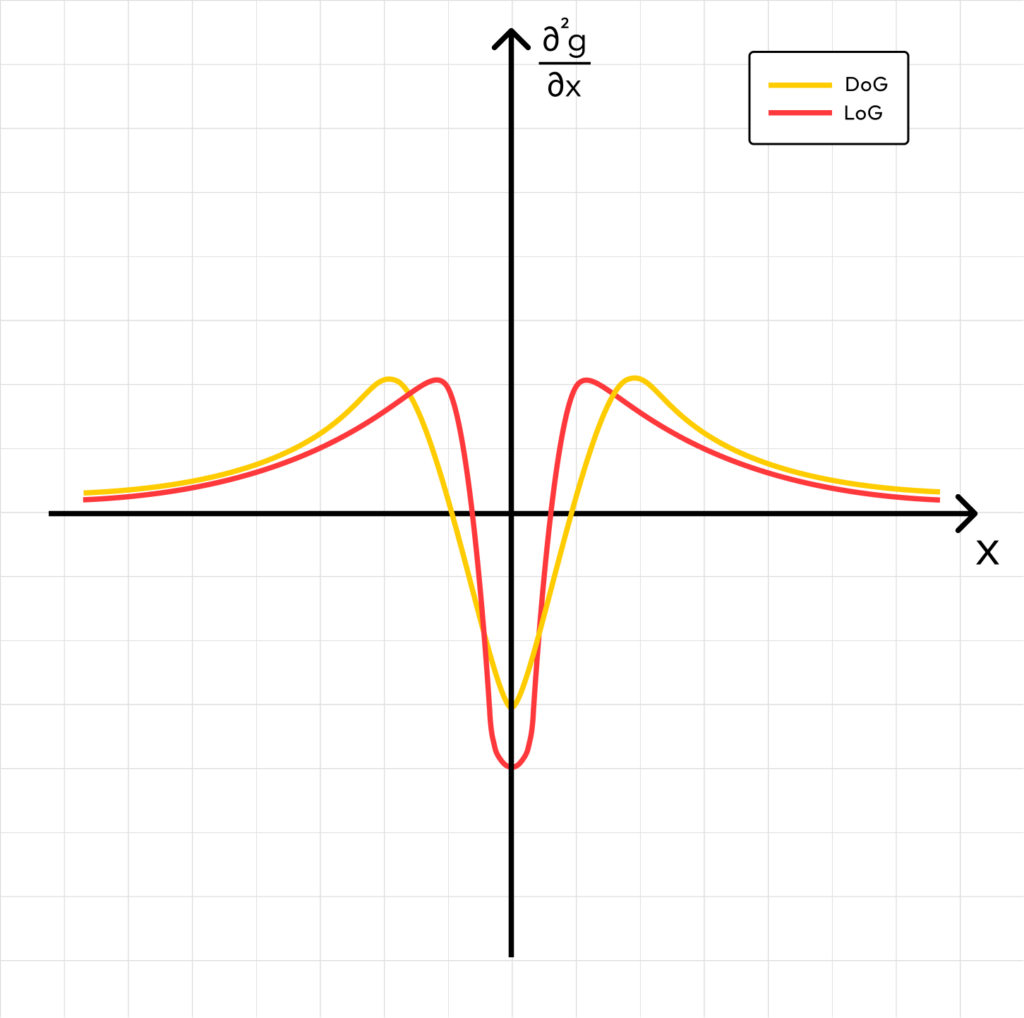
Trước đây, chúng ta đã nhận thấy rằng Laplacian of Gaussian (LoG) là một phép biến đổi rất hữu ích để xác định các cạnh trong hình ảnh. Đồng thời, hóa ra có một phép xấp xỉ rất tốt cho sự khác biệt của hai LoG được điều chỉnh tỷ lệ (scaled) áp dụng cho cùng một hình ảnh:
DoG = nkσ - nσ ≈ (k - 1)σ2 ⋅ ▽2nσ
Trên thực tế, việc tính toán DoG bằng công thức này nhiều lần ít tốn kém về mặt tính toán hơn nhiều so với việc áp dụng công thức LoG gốc mỗi lần.
Sự khác biệt trực quan giữa đồ thị LoG và DoG. Nói một cách đại khái, DoG có thể được xem là một phiên bản LoG đã được điều chỉnh tỷ lệ.
**Tại sao phải xây dựng một số DoG trong một quãng tám duy nhất?**
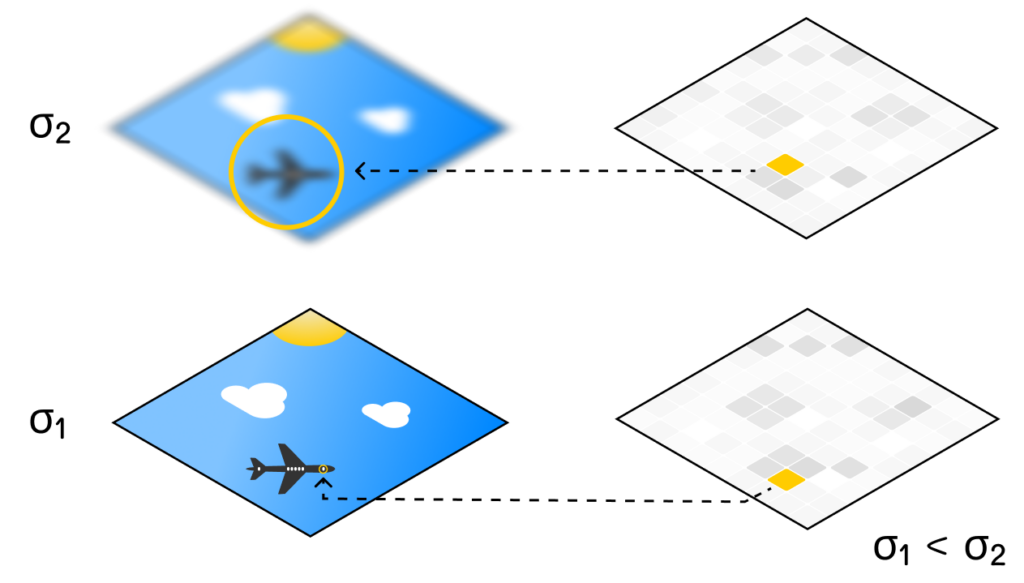
Trong một quãng tám duy nhất, độ mờ của hình ảnh tăng dần. Sự khác biệt giữa hai DoG liên tiếp làm nổi bật các điểm quan tâm trên các tỷ lệ khác nhau.
Ví dụ, một DoG được xây dựng giữa một cặp hình ảnh mạng liên tiếp (ở cuối một quãng tám) giúp phát hiện các đặc trưng nhỏ hơn dễ dàng hơn nhiều. Tuy nhiên, đối với các đặc trưng lớn hơn, điều này lại khó khăn. Vì lý do đó, chúng ta cũng tính toán một DoG cho các hình ảnh mờ hơn (ở đầu một quãng tám), nơi các đặc trưng nhỏ hơn không hiển thị, và thuật toán tập trung nhiều hơn vào các vùng lớn hơn.
SIFT điều chỉnh kích thước đặc trưng một cách thích hợp dựa trên tham số σ của lớp DoG. Các giá trị σ cao hơn tương ứng với kích thước đặc trưng lớn hơn.
**Tại sao phải xây dựng một số quãng tám?**
Rõ ràng là khi độ mờ tăng lên, chúng ta có thể phát hiện các đặc trưng lớn hơn. Vì vậy, một câu hỏi tự nhiên nảy sinh: tại sao không chỉ sử dụng một quãng tám duy nhất, lặp lại từ mức độ làm mờ rất nhỏ đến rất cao? Bằng cách này, chúng ta có thể phát hiện các đặc trưng ở mọi kích thước.
Động lực để xây dựng một số quãng tám nằm ở hai khía cạnh:
Khi độ mờ tăng lên, các chi tiết nhỏ trở nên không nhìn thấy được trong hình ảnh. Vì vậy, về mặt hiệu quả, không có lý do gì để giữ độ phân giải hình ảnh đầy đủ ở các mức độ làm mờ cao hơn. Lấy mẫu giảm (downsampling) làm giảm số lượng pixel theo hệ số 4, giúp quá trình xử lý nhanh hơn nhiều.
Việc xấp xỉ các nhân Gaussian rất lớn có thể
Nguồn tin: Towards Data Science — Tác giả: Slava Efimov. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.