
Quản trị các tác nhân AI
Từ việc giám sát một tác nhân AI đến điều khiển một đội ngũ. Bài viết Cách quản lý các tác nhân AI xuất hiện lần đầu trên Towards Data Science.
Quản trị dữ liệu
Cách quản lý các tác nhân AI
Từ việc bảo vệ một tác nhân đến điều khiển một đội tác nhân
Amber Roberts
Ngày 04/10/2026
9 phút đọc
Thời điểm này năm ngoái, tôi đã phát hành một khóa học Deeplearning.ai cùng với Andrew Ng về Quản lý các tác nhân AI, với mục tiêu giáo dục các nhà phát triển về những kiến thức cơ bản về bảo vệ dữ liệu để triển khai tác nhân hiệu quả và có trách nhiệm. Động lực cho khóa học này xuất phát từ nghiên cứu về vi phạm dữ liệu năm 2025 của IBM, trong đó phát hiện 97% các tổ chức gặp phải vi phạm liên quan đến AI thiếu kiểm soát truy cập AI phù hợp, và 63% hoàn toàn không có chính sách quản trị AI nào.
Một năm là một khoảng thời gian dài trong phát triển AI, và chúng ta đã đi một chặng đường dài từ các tác nhân không có quản trị hoặc phải vật lộn với việc quản lý một tác nhân duy nhất. Các nhóm hiện đang đối mặt với một thách thức quản trị mới: sự tràn lan của tác nhân (sự phát triển không kiểm soát của các tác nhân AI tự trị trong một tổ chức mà không có sự theo dõi, quyền sở hữu hoặc quản trị tập trung). Theo Gartner, đến năm 2028, một doanh nghiệp Fortune 500 trung bình sẽ sử dụng hơn 150.000 tác nhân AI. Tuy nhiên, theo công ty này, chỉ 13% các tổ chức tin rằng họ có hệ thống quản trị tác nhân AI phù hợp. Kể từ năm ngoái, khả năng triển khai đã trở nên dễ dàng hơn bao giờ hết. Sự xuất hiện của các tác nhân viết mã như Claude Code và Codex, cũng như nhiều tùy chọn low-code/no-code, đã giảm đáng kể rào cản đối với việc triển khai tác nhân. Một hệ quả là các nhóm hiện đang đối mặt với khả năng đội tác nhân của họ sử dụng token lãng phí rất lớn và phát sinh chi phí không lường trước. Một thách thức nghiêm trọng khác là các con đường bổ sung để dữ liệu nhạy cảm bị rò rỉ. Không ngạc nhiên khi các thách thức quản trị đã phát triển.
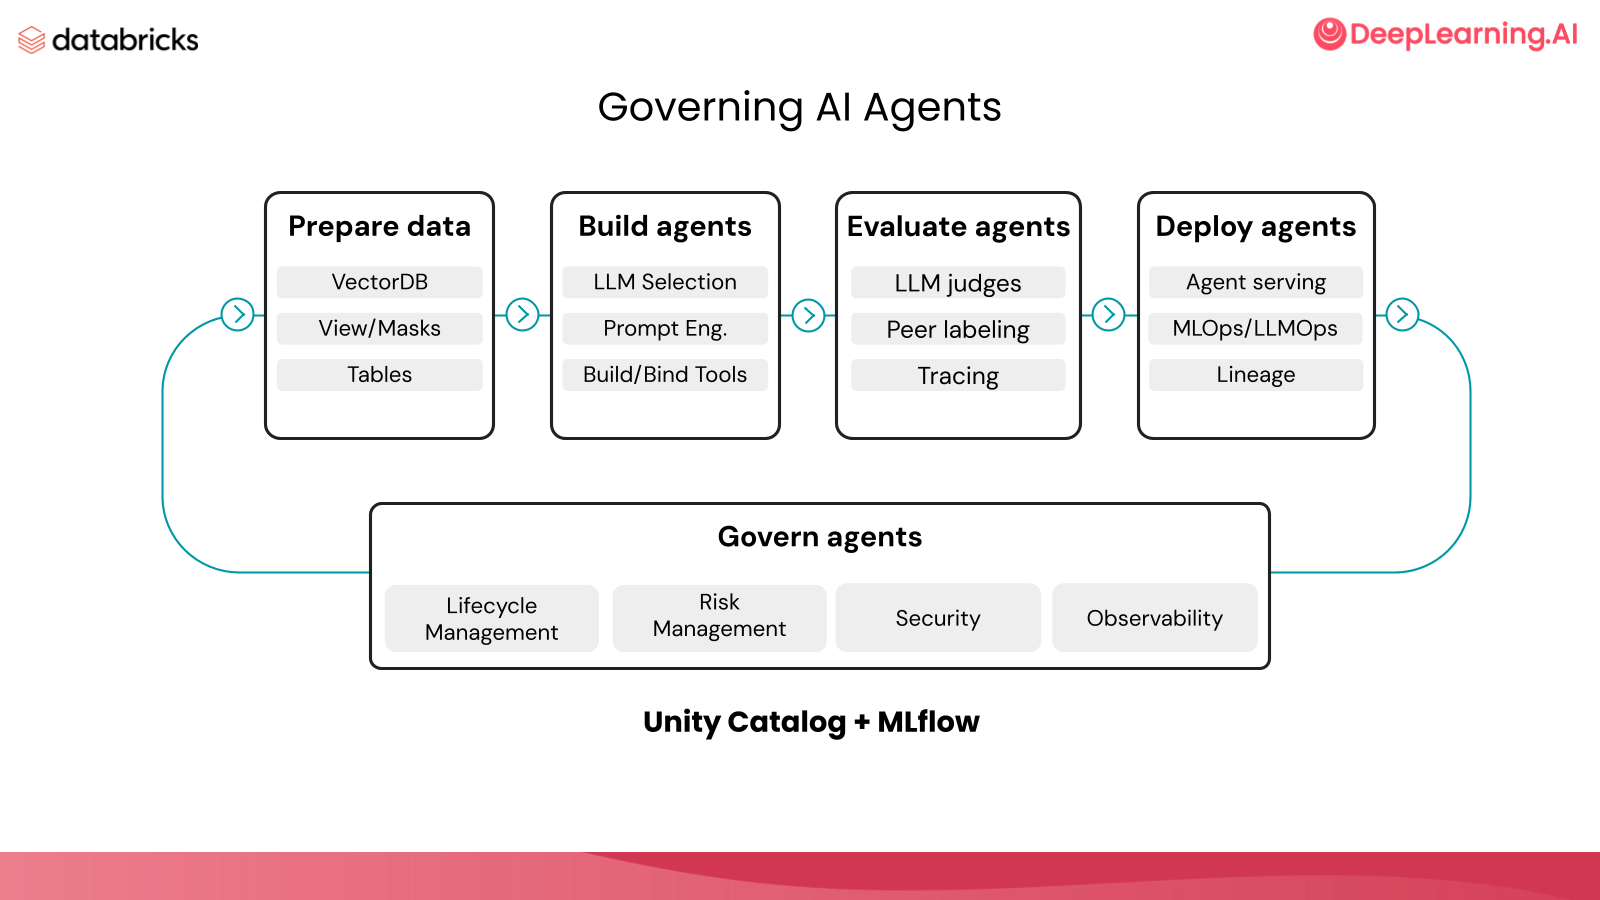
Hiện tại, tôi đang chứng kiến khách hàng xây dựng tác nhân nhanh hơn bao giờ hết, và bản chất của vấn đề đã thay đổi. Một năm trước, chúng tôi tập trung vào việc bổ sung bốn trụ cột quản trị cho một tác nhân duy nhất: quản lý vòng đời, quản lý rủi ro, bảo mật và khả năng quan sát.
Tìm hiểu từng bước với lộ trình Kỹ sư dữ liệu tương tác.
Ngay cả khi đó, chúng tôi đã biết rằng việc xây dựng một tác nhân không phải là phần khó. Bạn có thể thiết lập một tác nhân trong một buổi chiều, kết nối khả năng quan sát, trỏ nó vào một phần dữ liệu đã sao chép, và nó trông như thể đã sẵn sàng sản xuất. Sau đó, bạn cố gắng chạy nó trong thực tế, chống lại các hệ thống trực tiếp và ở quy mô lớn, và bạn sẽ gặp phải bức tường thực sự quan trọng: cơ sở hạ tầng ở quy mô lớn. Hiện tại, điều này không thay đổi, nhưng sự thay đổi là gì? Sự khác biệt là điều này đang xảy ra với hàng chục tác nhân/tác nhân phụ cùng một lúc. Các tác nhân đang nhân lên nhanh hơn nhiều nhóm có thể quản lý chúng. Các nhóm hiện cần được trang bị một nền tảng dữ liệu có khả năng mở rộng việc theo dõi, cấp phép và quản trị tập trung theo số lượng tác nhân đang được xây dựng. Hãy cùng xem xét cách các trụ cột quản trị đã phát triển vào năm 2026.
Chúng ta đã ở đâu: bốn trụ cột và một tác nhân
Năm ngoái, tôi đã giảng khóa học miễn phí này thông qua DeepLearning.AI về quản lý các tác nhân AI, nơi chúng tôi đã xây dựng một tác nhân phân tích nhân sự được quản lý trên Unity Catalog và MLflow. Toàn bộ khóa học được chắt lọc thành bốn trụ cột:
Quản lý vòng đời (Phân tách nhiệm vụ): lập phiên bản, triển khai và ngừng hoạt động các tác nhân với toàn bộ nguồn gốc trên các môi trường phát triển (dev), thử nghiệm (staging) và sản xuất (prod).
Quản lý rủi ro (Phòng thủ theo chiều sâu): các biện pháp phòng thủ chồng chéo như phát hiện thông tin nhận dạng cá nhân (PII), hàng rào bảo vệ (guardrails), kiểm soát tuân thủ và giám sát, từ việc nhập dữ liệu đến hiệu suất mô hình.
Bảo mật (Quyền truy cập tối thiểu): các tác nhân và người dùng chỉ nhận được các quyền tối thiểu mà vai trò của họ yêu cầu, được thực thi thông qua xác thực, mã hóa và kiểm soát truy cập chi tiết.
Khả năng quan sát (Kiểm toán mọi thứ): ghi lại mọi đầu vào, đầu ra và quyết định để đảm bảo khả năng truy xuất nguồn gốc và tuân thủ hoàn chỉnh.
Hình 1: Mô hình quản trị từ khóa học “Governing AI Agents” năm 2025 của Deeplearning.ai. Bốn trụ cột nằm dưới vòng đời của tác nhân (agent), trên nền tảng Unity Catalog + MLflow. Các trụ cột này nghe có vẻ trừu tượng cho đến khi làm việc trực tiếp với bộ phận pháp lý, kiểm toán viên và lãnh đạo. Khi đó, chúng sẽ quy về ba câu hỏi rất cụ thể.
Tác nhân có thể tiếp cận những gì? Trong quá trình xây dựng của chúng tôi, câu trả lời là: không bao giờ truy cập trực tiếp vào bảng. Mọi thứ đều chạy qua các lớp, từ che giấu (masking) đến chế độ xem (views) đến nhóm (groups) đến hàm (functions), với việc phân loại dữ liệu được thực thi ở mỗi lớp và chỉ cho phép truy cập tổng hợp trên các bảng nhạy cảm. Trên thực tế, điều đó có nghĩa là tác nhân có thể trả lời "Tỷ lệ nghỉ việc trong bộ phận kỹ thuật quý này là bao nhiêu?" nhưng về mặt cấu trúc không thể tiết lộ mức lương của bất kỳ cá nhân nào.
Điều gì đã thay đổi và tôi có thể hoàn tác không? Tác nhân được đăng ký dưới dạng mô hình Unity Catalog có phiên bản và được triển khai từ phiên bản đó, nằm trên các hàm và chế độ xem được kiểm soát phiên bản. Vì vậy, khi chất lượng câu trả lời giảm vào thứ Ba, bạn biết chính xác những gì đã được triển khai vào thứ Hai và bạn có thể hoàn nguyên thay vì gỡ lỗi một hộp đen trong môi trường sản xuất.
Tôi có thể tái tạo những gì đã xảy ra không? Mọi lệnh gọi hàm đều được ghi lại, MLflow theo dõi mọi lần chạy và có một dấu vết kiểm toán từ truy vấn cho đến dữ liệu cơ bản. Khi một kiểm toán viên hỏi tác nhân đã chạm vào những gì vào ngày 3 tháng 3, đó là một truy vấn, không phải một cuộc điều tra kéo dài ba tuần.
Tuy nhiên, hãy lưu ý phạm vi của tất cả những điều này. Toàn bộ mục tiêu, một năm trước, là đưa một tác nhân vào sản xuất một cách an toàn.
Hiện trạng: quản trị phải mở rộng quy mô
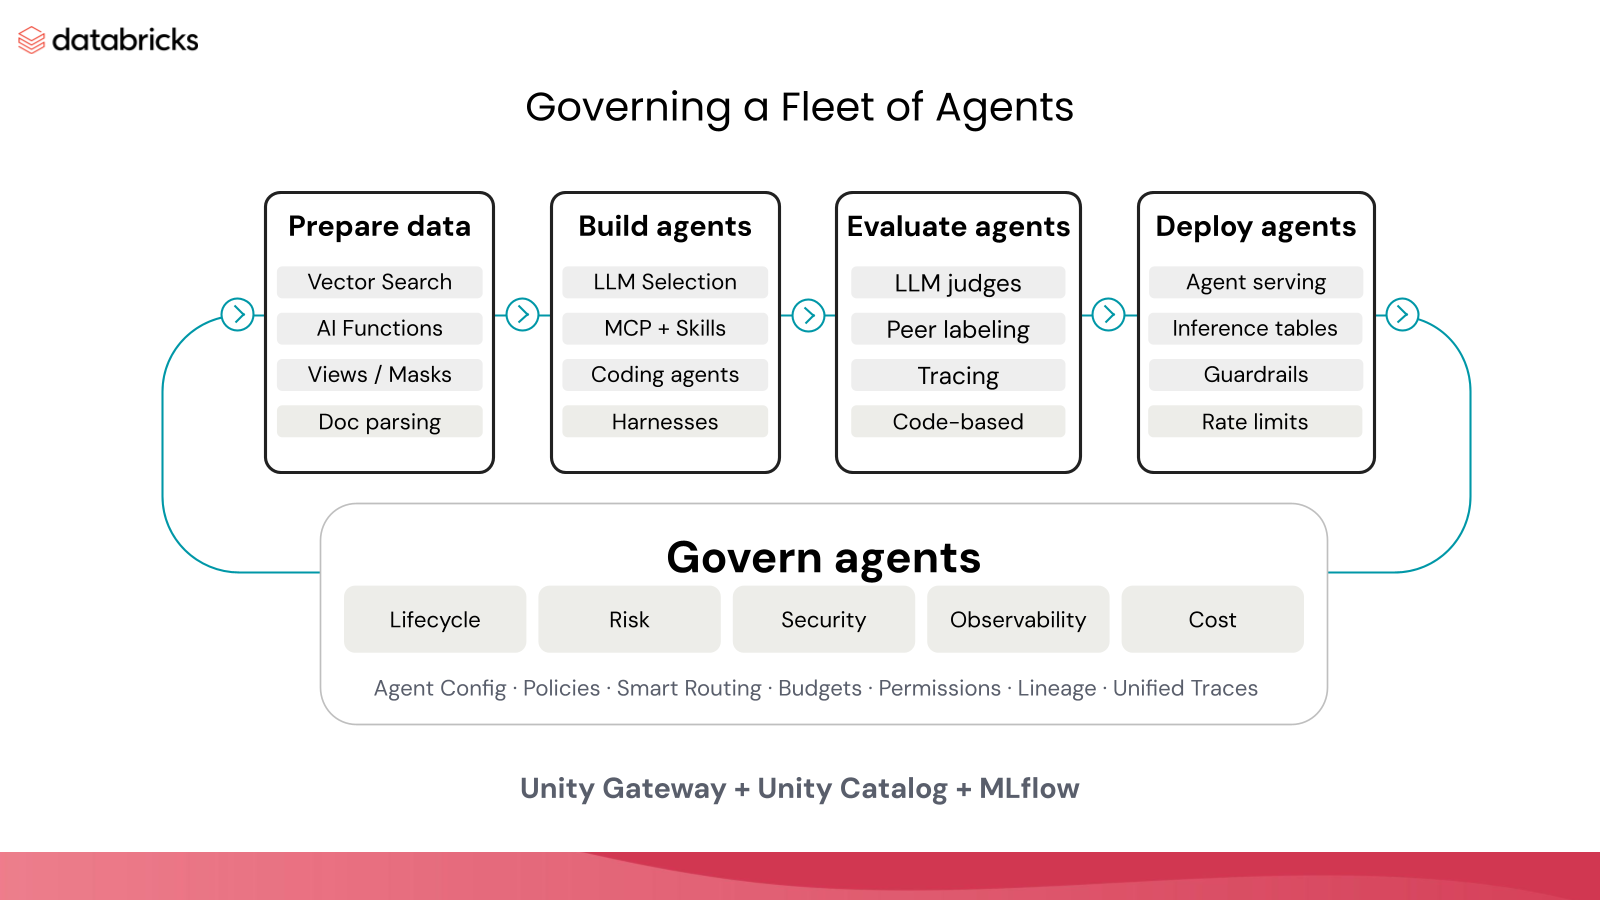
Mặc dù bốn trụ cột vẫn còn giá trị, nhưng giờ đây mỗi trụ cột phải được áp dụng cho toàn bộ đội ngũ tác nhân cùng một lúc. Điều đó đòi hỏi hai yếu tố: các chính sách áp dụng trên toàn cầu, cho mọi tác nhân, và cơ sở hạ tầng để thực thi chúng.
Mọi tác nhân đều cần quyền truy cập được quản lý vào dữ liệu trực tiếp, không phải một mẫu sao chép trông ổn trong bản thử nghiệm. Ngoài ra, mọi tác nhân đều tạo ra bản ghi riêng: dấu vết, chi tiêu và nhật ký truy cập; và tất cả những điều đó phải được lưu trữ ở nơi có thể truy vấn. Giờ đây, việc cấu hình thủ công nguồn gốc (lineage) và đặc quyền tối thiểu (least-privilege) cho một tác nhân được xây dựng cẩn thận không còn phù hợp khi có hàng trăm tác nhân chạy trên một nền tảng dữ liệu chưa được thiết kế cho mục đích đó. Công việc khó khăn chuyển xuống một lớp, từ tác nhân sang cơ sở hạ tầng mà nó chạy trên đó.
Tin tốt là cơ sở hạ tầng để hỗ trợ quản lý các tác nhân ở quy mô lớn đang trở thành ưu tiên hàng đầu của các công ty đang xây dựng tác nhân.
Nguồn tin: Towards Data Science — Tác giả: Amber Roberts. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.