
Polymorphic Inference: Suy luận tự tinh chỉnh cho các mô hình mở
Các mô hình, lưu lượng truy cập và chip liên tục biến đổi. Giải pháp Polymorphic Inference có khả năng thích ứng với từng yếu tố này, trong khi Together Compiler sử dụng các tác tử AI để duy trì hiệu năng tối ưu cho quá trình suy luận trong môi trường vận hành thực tế.
Tóm tắt
Together AI tập trung vào mục tiêu phổ cập AI rộng rãi tới mọi cá nhân và tổ chức. Đội ngũ nghiên cứu của công ty – các tác giả đứng sau FlashAttention, ThunderKittens, ThunderAgent cùng nhiều dự án khác – là động lực then chốt thúc đẩy năng lực suy luận vượt trội. Trong bối cảnh thị trường suy luận tăng trưởng theo cấp số nhân, Together AI chú trọng mở rộng năng lực nghiên cứu nhằm hiện thực hóa mục tiêu phổ cập trí tuệ nhân tạo đến toàn xã hội.
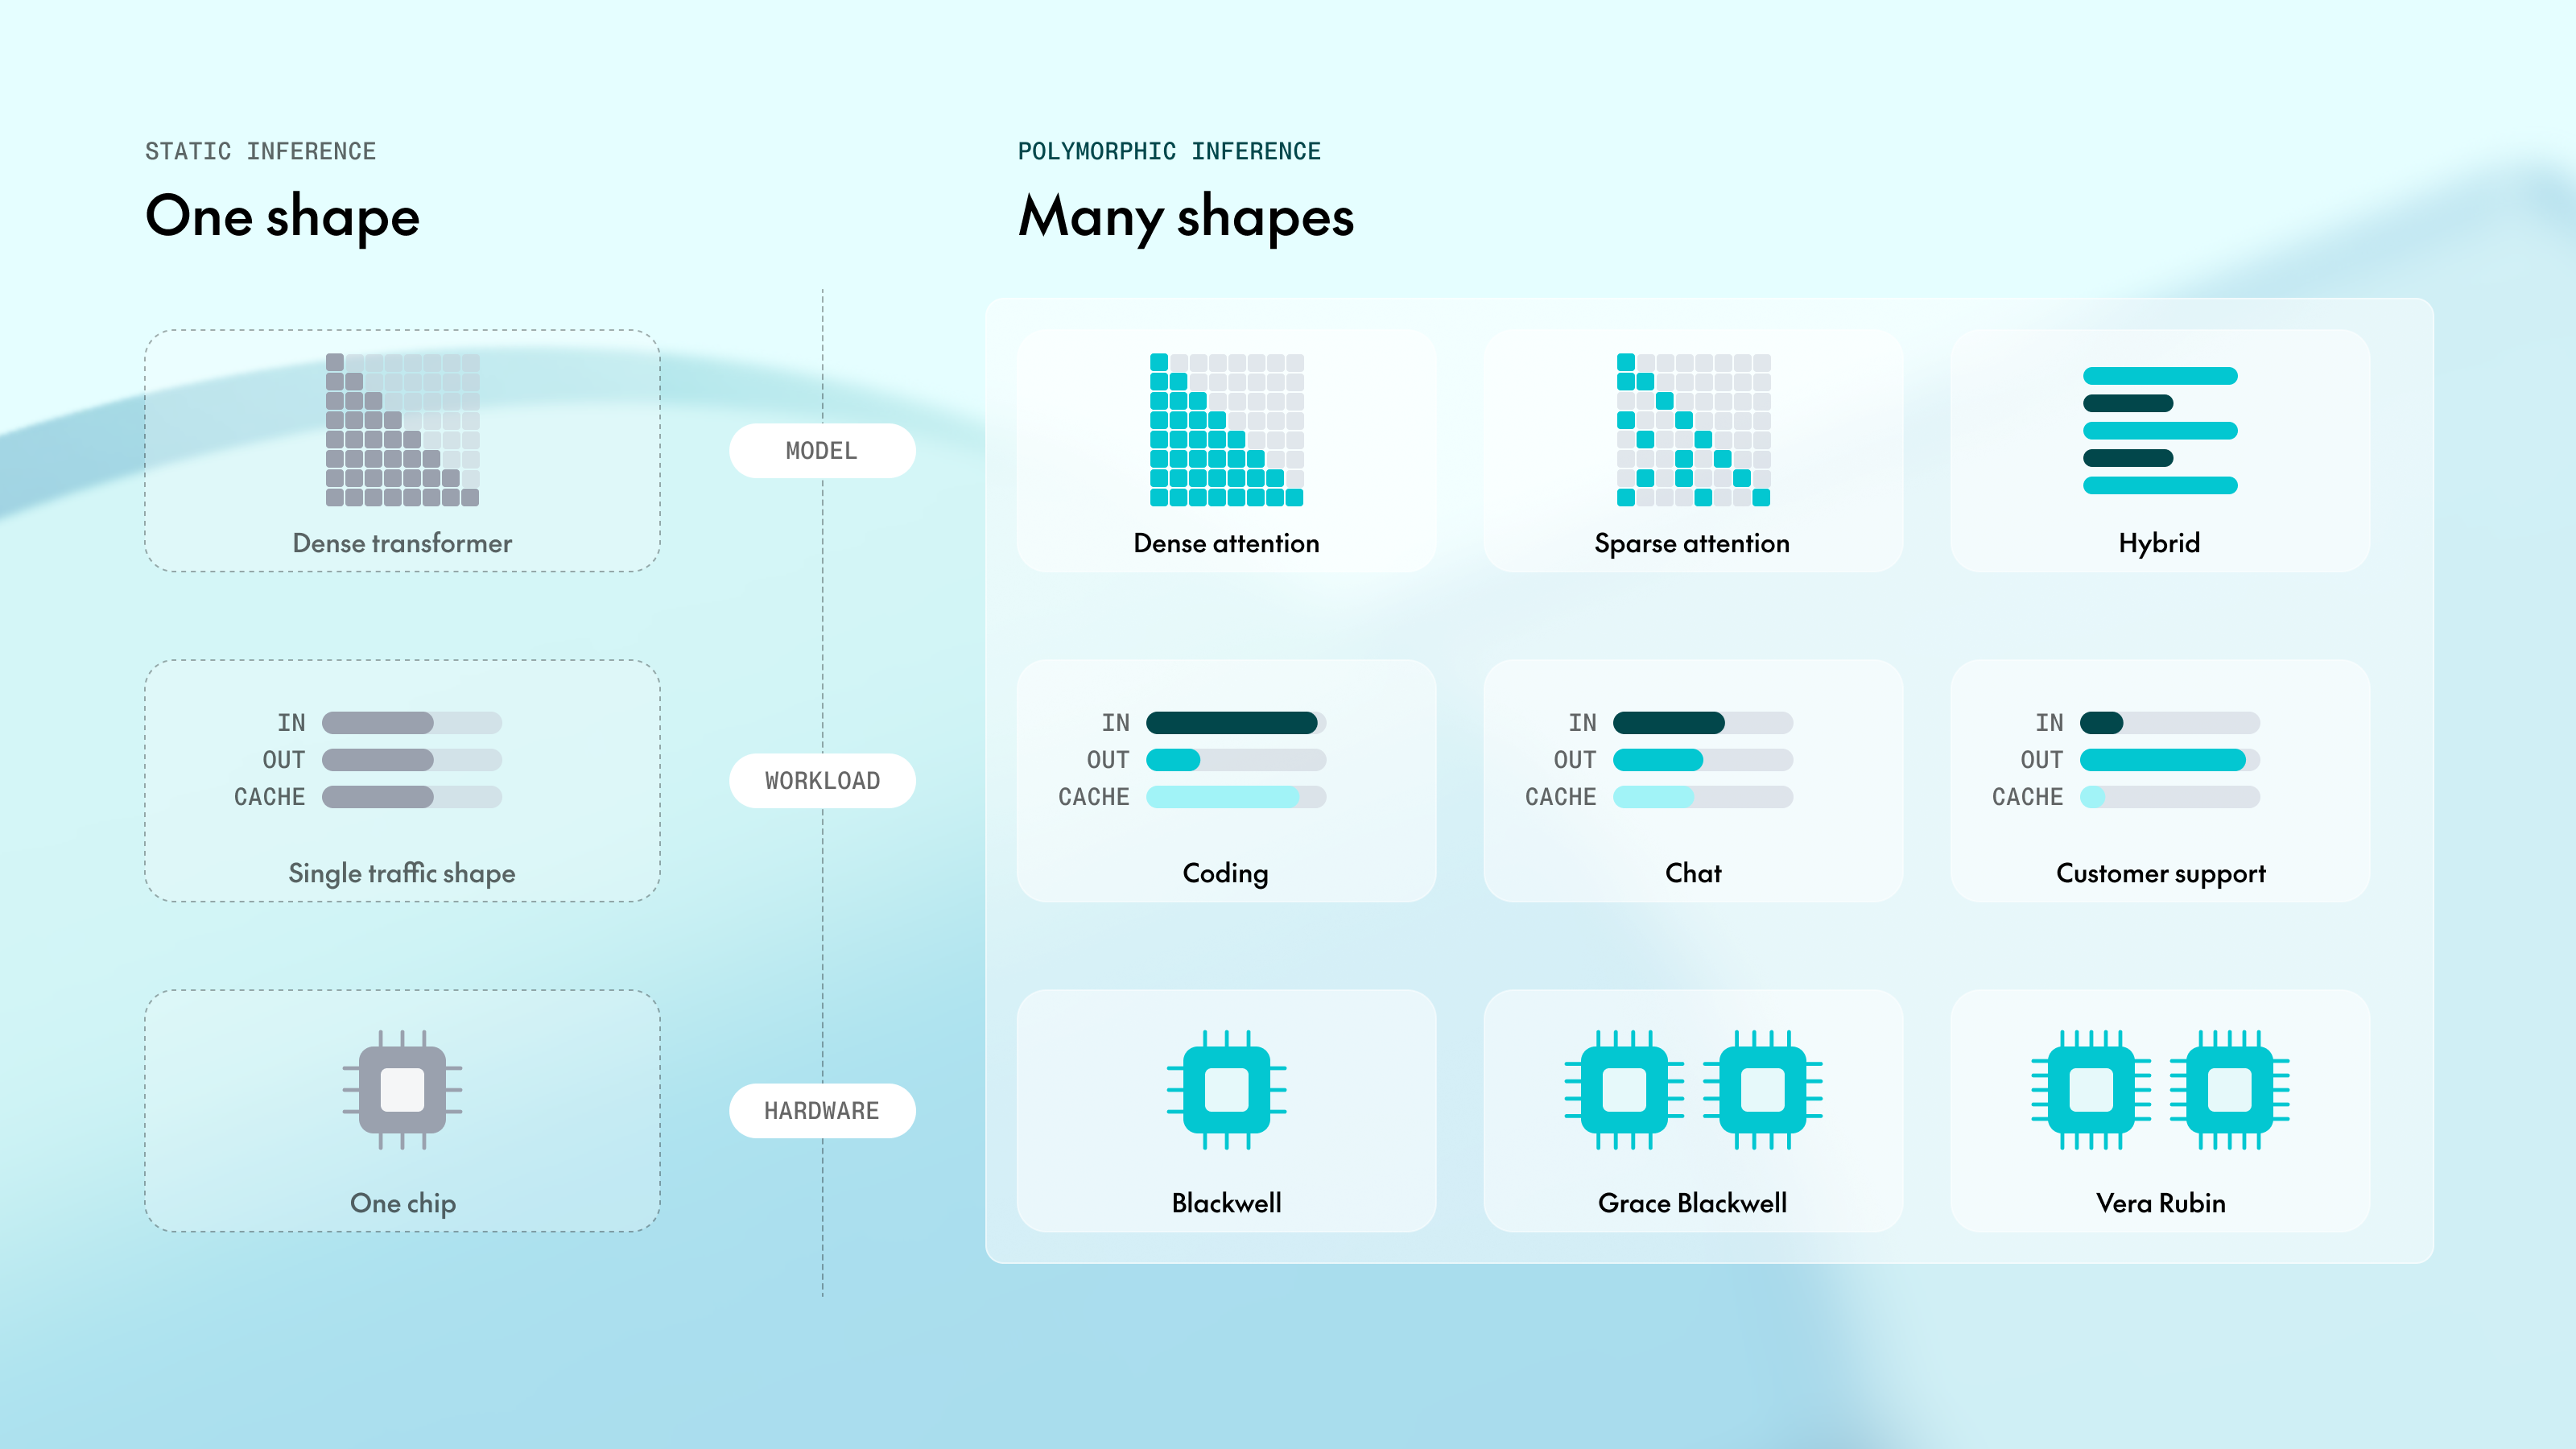
Thực tế này đòi hỏi sự chuyển dịch tư duy từ Suy luận Tĩnh (Static Inference) sang Suy luận Đa hình (Polymorphic Inference). Đây là giải pháp ứng phó với tốc độ phát hành dồn dập của các mô hình mới, sự đa dạng trong cấu trúc mô hình, cũng như sự biến đổi nhanh chóng của khối lượng công việc và các nền tảng phần cứng. Bài viết này giới thiệu định hướng nghiên cứu cho kỷ nguyên Suy luận Đa hình, đồng thời nêu bật phương thức ứng dụng liên tục các AI agent nhằm tự tối ưu hóa quá trình suy luận thông qua kỹ thuật Biên dịch Liên tục (Continuous Compilation).
Khái niệm suy luận đa hình (Polymorphic Inference) là gì?
Trong năm qua, đã có bước chuyển biến rõ rệt về tính đa dạng của các mô hình nguồn mở cũng như phương thức triển khai các mô hình này trong môi trường sản xuất (production). Bước chuyển biến này đòi hỏi một phương pháp tiếp cận mới, được gọi là Suy luận đa hình (Polymorphic Inference).
Suy luận đa hình (thuật ngữ bắt nguồn từ tiếng Hy Lạp mang nghĩa suy luận ở “nhiều hình thái”) là lời giải cho hàng loạt thay đổi đang diễn ra trên toàn ngành, được định hình chủ yếu bởi sự hội tụ của một số xu hướng:
Tốc độ phát hành mô hình ngày càng gia tăng. Các mô hình nguồn mở đang ra mắt với tốc độ nhanh hơn và đa dạng hơn bao giờ hết. Khoảng 80% lưu lượng trên OpenRouter hiện thuộc về các mô hình được phát hành trong vòng ba tháng qua.
Kiến trúc mô hình ngày càng đa dạng. Toàn bộ 10 mô hình nguồn mở (OSS) phổ biến nhất hiện nay đều sử dụng các kiến trúc khác nhau (chưa kể đến nhiều kiến trúc nguồn đóng do các đối tác cung cấp).
Đặc tính lưu lượng liên tục biến đổi. Hệ thống phục vụ người dùng, tổ chức và các khu vực địa lý mới mỗi ngày với nhiều dạng khối lượng công việc và cam kết chất lượng dịch vụ (SLA) khác nhau. Những thay đổi về sản phẩm hoặc thuật toán trong bộ khung kiểm thử (harness), cùng quá trình hậu huấn luyện (post-training) của các mô hình nguồn mở đều có thể dẫn đến sự thay đổi về đặc tính lưu lượng (ví dụ: giai đoạn hậu huấn luyện mới làm gia tăng lượng token mô hình sử dụng để “tư duy” nhằm đổi lấy chất lượng đầu ra cao hơn).
Phần cứng thay đổi nhanh hơn và thường xuyên hơn. Năng lực phục vụ suy luận đã ghi nhận những bước tiến lớn từ B200 đến GB300, đồng thời sắp chứng kiến các đợt triển khai kiến trúc Vera Rubin đầu tiên (chưa kể đến những tối ưu hóa ở cấp độ CPU, hệ thống lưu trữ tiên tiến và các vi mạch suy luận thay thế).
Suy luận đa hình chính là giải pháp nhằm đáp ứng các thay đổi này – một cơ chế suy luận có khả năng biến đổi và thích ứng với các môi trường chuyển động không ngừng.
Khái niệm này đặt trong sự đối chiếu với bối cảnh trước giai đoạn bùng nổ của suy luận trên mô hình nguồn mở – thời kỳ được gọi là kỷ nguyên “Suy luận tĩnh” (Static Inference). Trong khi Suy luận đa hình hiện đại có thể mang vô số hình thái khác nhau, Suy luận tĩnh lại được định hình bởi các mô hình nguồn đóng, kiến trúc Transformer truyền thống, mô hình một người dùng và suy luận trên một nền tảng phần cứng duy nhất.
Từ Suy luận tĩnh đến Suy luận đa hình
Động lực thúc đẩy bài viết này xuất phát từ thực tế là phần lớn các cuộc thảo luận xung quanh các hệ thống suy luận hiện nay vẫn tập trung chủ yếu vào mô hình Suy luận tĩnh truyền thống.
Ví dụ, các công thức phổ biến trên môi trường mạng như vLLM, SGLang hay InferenceX / AgentX thường được khởi chạy với một cấu hình công cụ suy luận đã được tinh chỉnh siêu tham số tĩnh. Một cấu hình được tối ưu hóa cho thiết lập này chưa chắc đã mang lại hiệu quả tốt nhất cho một thiết lập khác.
Các nhân tính toán (kernel) nguồn mở thường được phát hành dựa trên giả định về một số đặc tính lưu lượng và quyết định thiết kế mang tính cố định, vốn có thể không khớp với lưu lượng thực tế trong môi trường sản xuất. Một ví dụ điển hình là các kernel MoE; một kernel MoE hoạt động tốt với các token ngẫu nhiên chưa chắc đã mang lại hiệu quả tương tự trong môi trường sản xuất thực tế.
Đây cũng là thiếu sót từ chính các nhà phát triển. Trong một thời gian dài, giới kỹ thuật hoàn toàn có thể viết các kernel tối ưu cho nhiều thiết lập khác nhau. Điển hình như FlashAttention, giải pháp này vẫn là một trong những phương thức tối ưu nhất để vận hành các khối lượng công việc huấn luyện và tiền điền (prefill).
Cách đây gần hai năm, các phân tích về megakernel trong suy luận AI đã được đưa ra, mô tả một kernel duy nhất được thiết kế công phu xoay quanh một hình thái tĩnh (chẳng hạn như kích thước lô bằng một đối với mô hình Llama 1B). Tuy nhiên, thông qua quá trình đưa những megakernel đầu tiên vào môi trường sản xuất phục vụ khách hàng trong năm qua, một bài học quan trọng đã được rút ra: kỹ thuật dung hợp megakernel (megakernel fusion) trên thực tế không phải là mục tiêu thiết kế phù hợp cho mô hình Suy luận đa hình hiện đại.
Trong kỷ nguyên của Suy luận Đa hình (Polymorphic Inference), mọi biến thể – từ kiến trúc mô hình (ví dụ: MoE) đến khối lượng công việc (các khối lượng công việc động có kích thước lô lớn hơn 1) – đều đòi hỏi các phương pháp tiếp cận kỹ thuật khác nhau.
Tối ưu hóa Suy luận Đa hình cho các điều kiện đa dạng và thay đổi nhanh chóng
Tại Together, với tư cách là những nhà nghiên cứu hệ thống và AI, đội ngũ phát triển nhận định đây là thời điểm mang tính bước ngoặt để tái định hình định hướng nghiên cứu trong tương lai.
Giải pháp đặt ra khi lưu lượng vận hành thực tế ngày càng đa dạng là để các tác tử AI (AI agents) tự tối ưu hóa. Đây là thời điểm ghi nhận bước chuyển mình về tự cải tiến đệ quy (RSI) cho các mô hình mã nguồn mở (OSS).
Việc đạt được năng lực Suy luận Đa hình đòi hỏi phải giải quyết hàng loạt thách thức kỹ thuật trong quy trình cung cấp dịch vụ mô hình. Một trải nghiệm Suy luận Đa hình lý tưởng là khả năng thích ứng kịp thời với sự biến đổi nhanh chóng của các kiến trúc mô hình và khối lượng công việc.
Ví dụ:
Khi đặc điểm lưu lượng truy cập thay đổi – do điều chỉnh sản phẩm hoặc thay đổi trong hành vi người dùng – hệ thống suy luận cần có khả năng thích ứng nhanh chóng.
Khi triển khai khối lượng công việc trên một mô hình mới, đơn vị cung cấp giải pháp suy luận cần nhanh chóng tiệm cận các mốc chuẩn tối ưu tương đương với quá trình tinh chỉnh thủ công.
Khi một sản phẩm sẵn có với lưu lượng người dùng ổn định được triển khai trên nền tảng phần cứng mới, hiệu năng cần sớm đạt đến giới hạn tối đa của phần cứng đó.
Đây là những mục tiêu lớn và có giá trị thực tiễn cao. Một trong những yếu tố then chốt để đạt được các mục tiêu này là thúc đẩy các tác tử AI tự tối ưu hóa. Vòng lặp RSI hiện đã sẵn sàng cho các mô hình OSS.
Biên dịch liên tục với Together Compiler
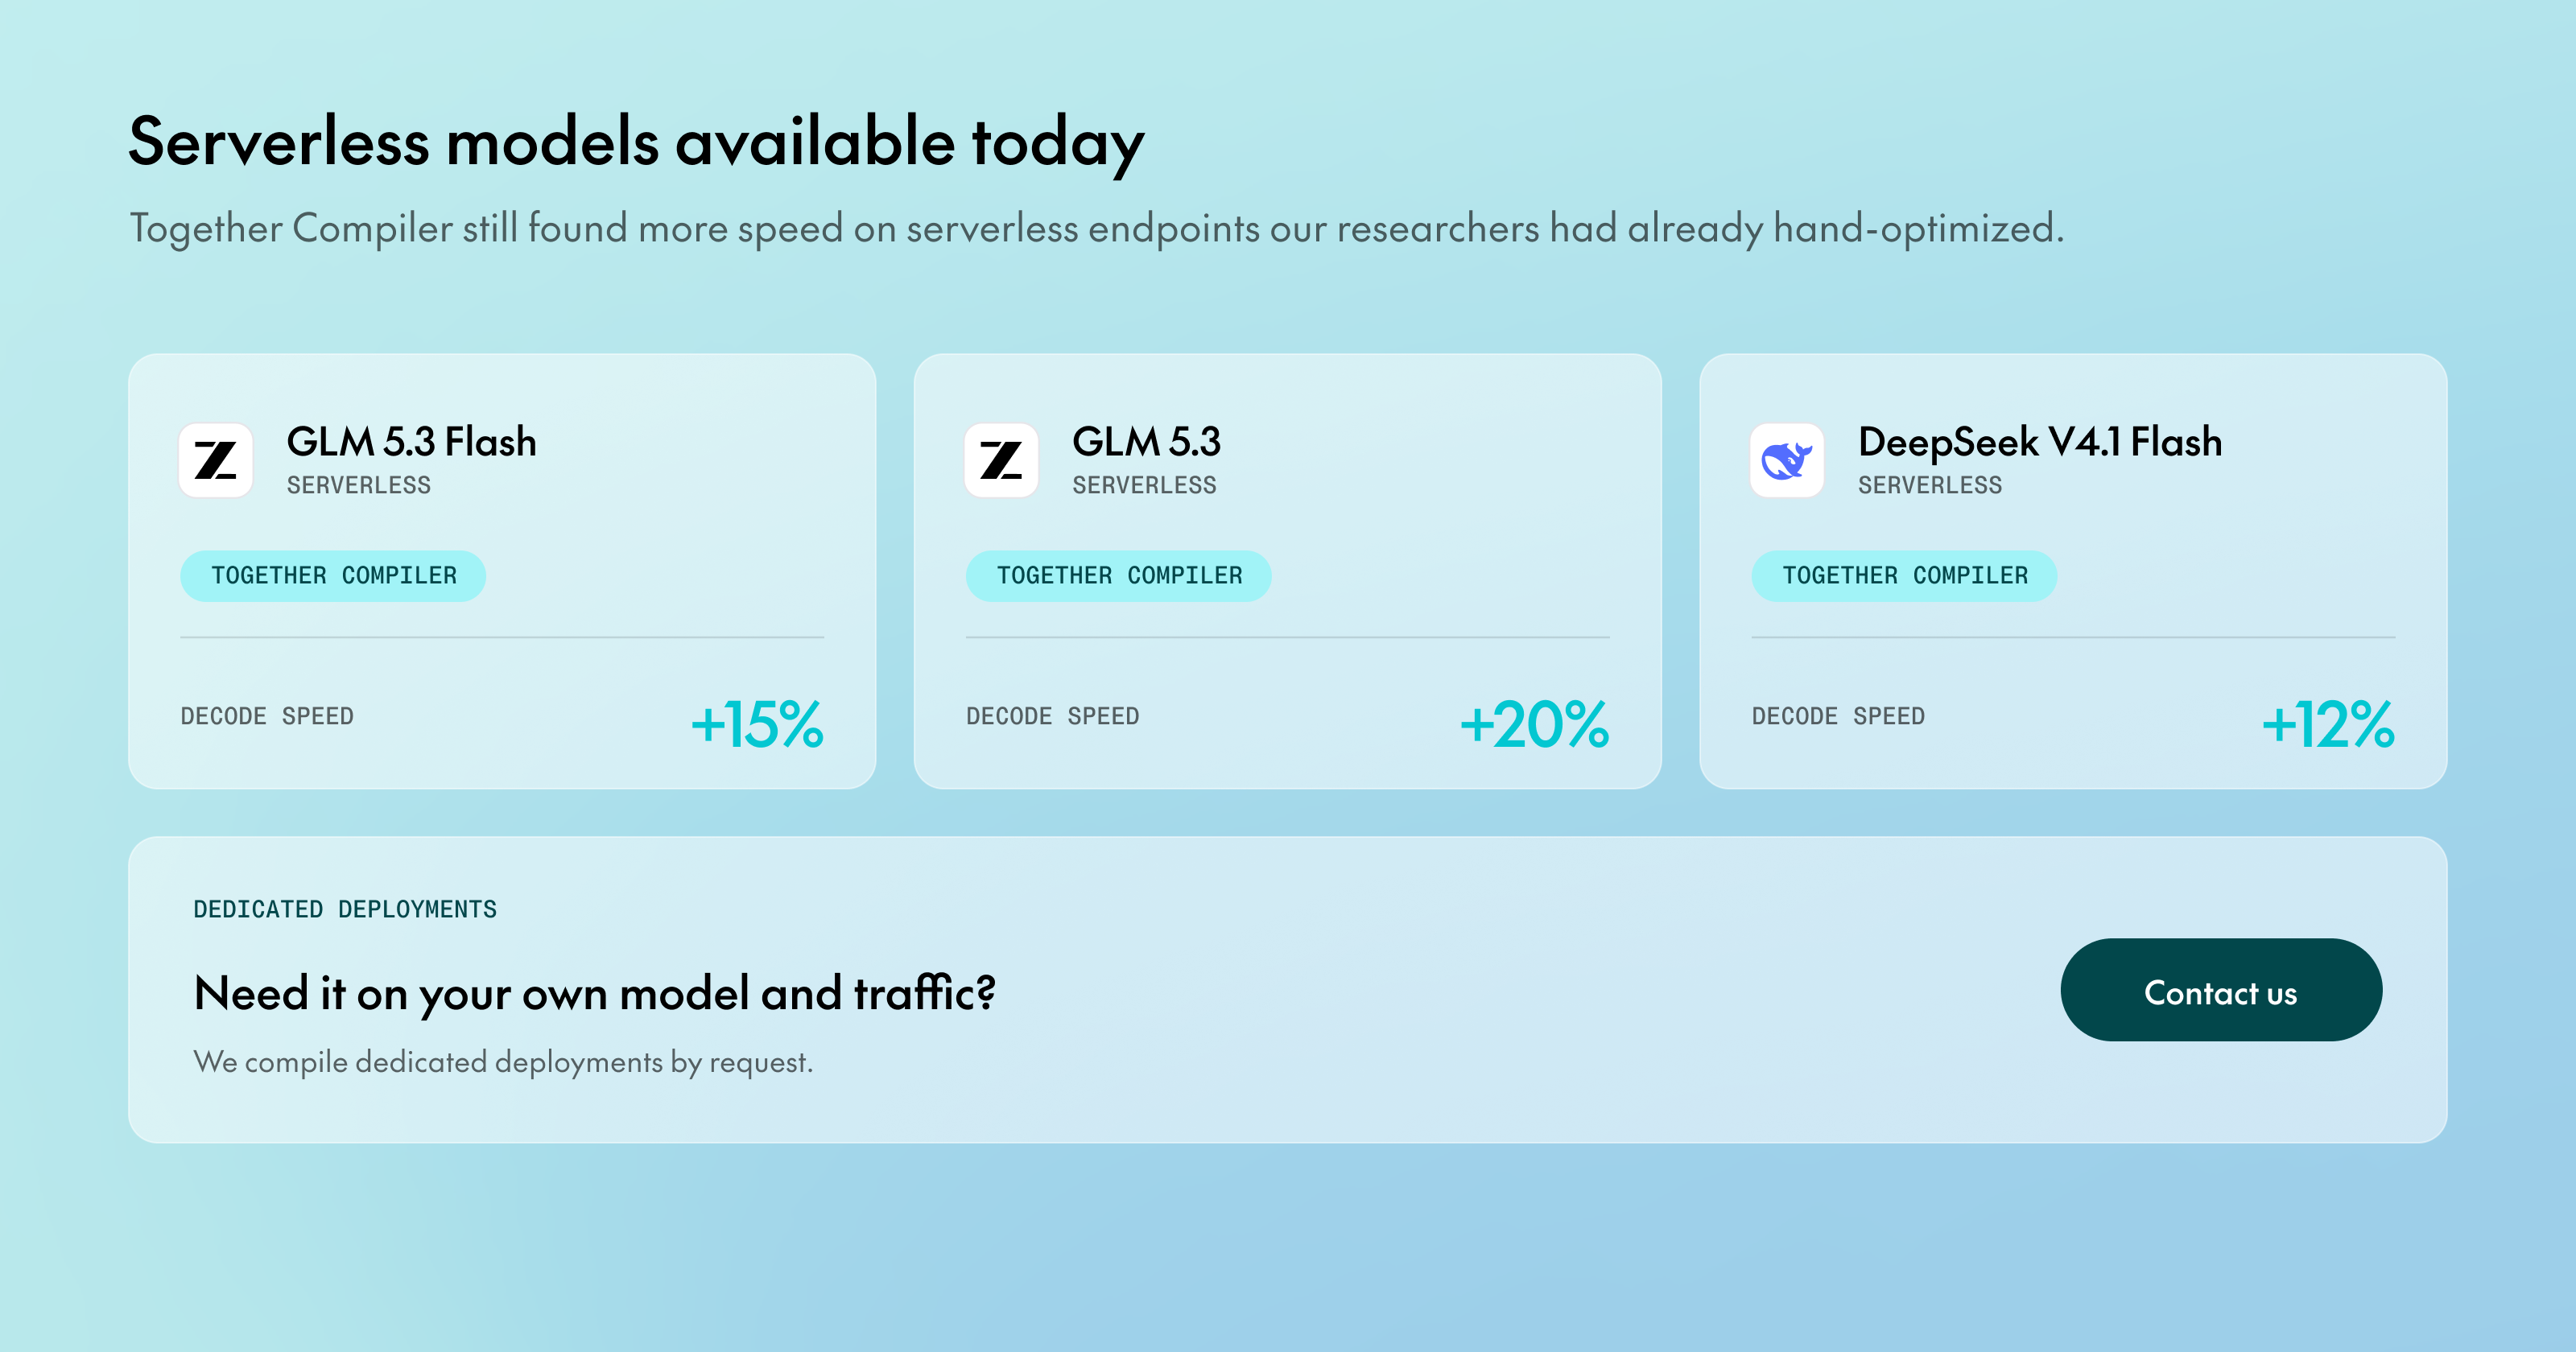
Một trong những dự án vừa được công bố là
Nguồn tin: Together AI Blog. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.