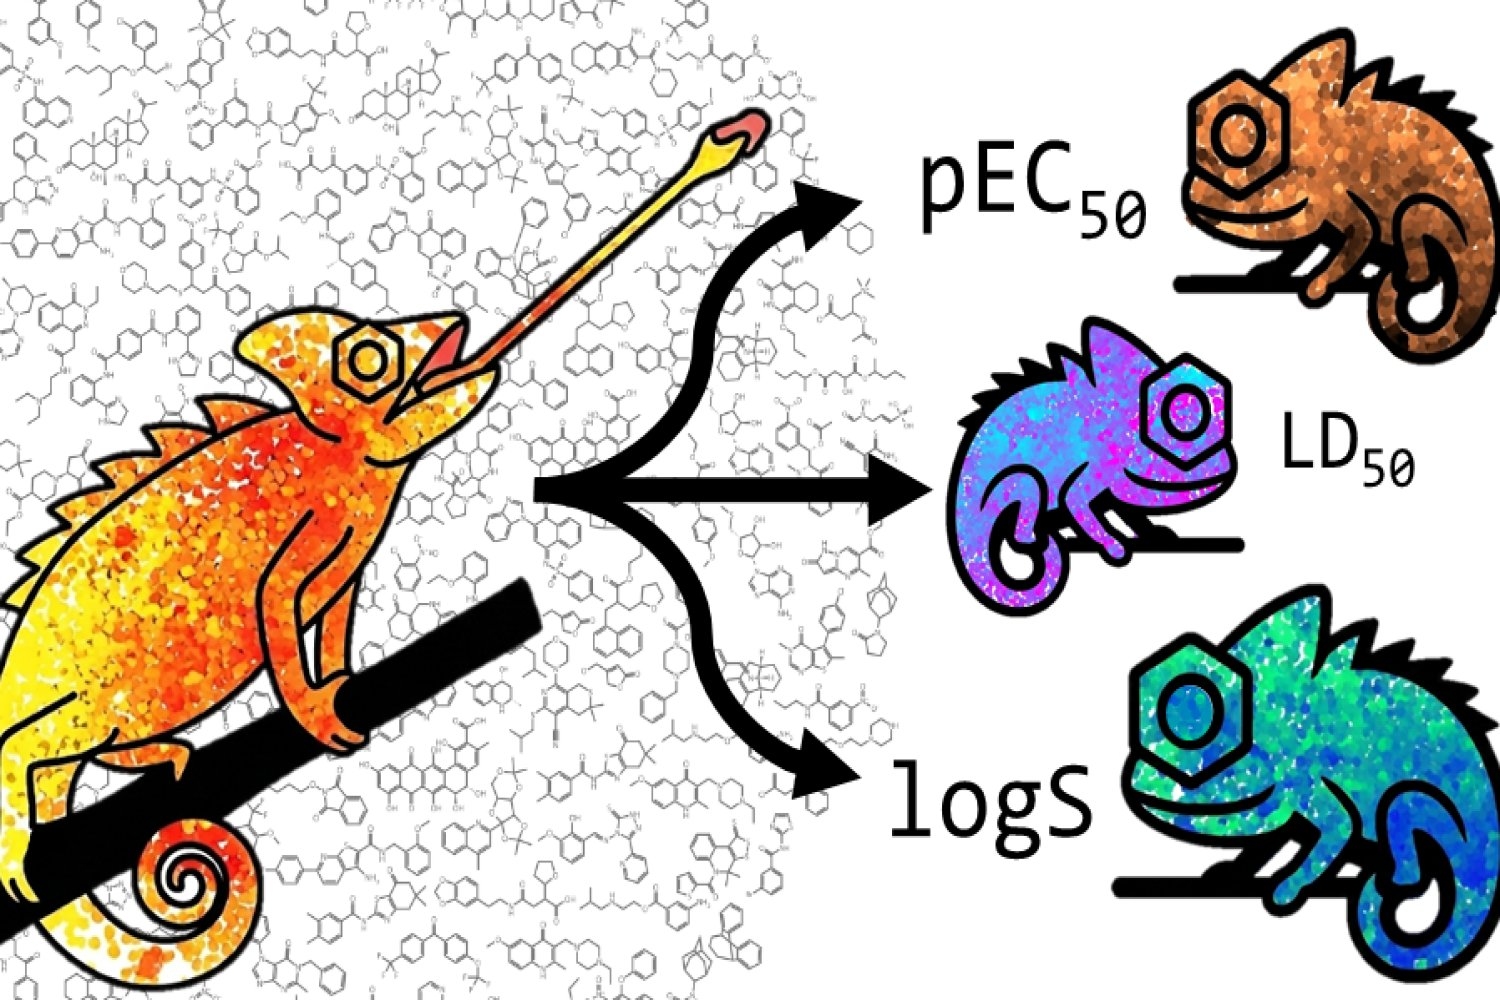
Phương pháp dự đoán hành vi của phân tử từ nguồn dữ liệu khan hiếm
MIT News AI· David L. Chandler | Department of Chemical Engineering· 6/11/2026general
Việc tìm ra các phân tử mới phục vụ những mục đích chuyên biệt là động lực then chốt thúc đẩy tiến bộ trong nhiều ngành công nghiệp, từ các doanh nghiệp dược phẩm nghiên cứu thuốc mới, đến các công ty điện tử hay năng lượng tìm kiếm vật liệu mới có những đặc tính riêng biệt. Tuy nhiên, đây phần lớn vẫn là quá trình thử - sai, do hiện chưa có phương pháp nào dự đoán chính xác tuyệt đối cách một hợp chất hóa học vận hành trước vô số đặc tính và phản ứng mà vật liệu có thể biểu hiện.
Thời gian gần đây, nhiều bước tiến đã được ghi nhận trong việc ứng dụng trí tuệ nhân tạo và học máy nhằm bổ trợ hoặc đẩy nhanh các công đoạn tốn nhiều công sức
Việc phát hiện các phân tử mới phục vụ mục đích chuyên biệt là động lực then chốt thúc đẩy tiến bộ trong nhiều ngành công nghiệp, từ các công ty dược phẩm nghiên cứu thuốc mới đến các doanh nghiệp điện tử hay năng lượng tìm kiếm vật liệu mới có đặc tính riêng biệt. Tuy nhiên, quá trình này phần lớn vẫn mang tính chất thử nghiệm và điều chỉnh (trial-and-error), do hiện nay chưa có phương pháp nào dự đoán chính xác tuyệt đối cách thức một hợp chất hóa học nhất định sẽ phản ứng dựa trên vô số đặc tính và phản hồi khác nhau của vật liệu.
Thời gian gần đây, việc ứng dụng trí tuệ nhân tạo (AI) và học máy (machine learning) đã đạt được những bước tiến nhằm bổ trợ hoặc đẩy nhanh quá trình tính toán phức tạp dựa trên các nguyên lý vật lý, từ đó bước đầu định hướng những hợp chất tiềm năng đáng để tổng hợp và thử nghiệm. Mới đây, một phương pháp mới do Viện Công nghệ Massachusetts (MIT) phát triển cho thấy, trong điều kiện khan hiếm dữ liệu về một đặc tính công nghệ liên quan – chẳng hạn như ái lực phối tử đối với một mục tiêu tế bào mới được phát hiện trong nghiên cứu thuốc tiềm năng –, phương pháp tiếp cận này có thể vượt trội hơn các phương pháp hiện hành trong việc sàng lọc và thu hẹp danh sách các phân tử triển vọng cần nghiên cứu.
Kết quả nghiên cứu đã được công bố trên số ra ngày 14/9 của tạp chí Journal of Chemical Information and Modeling, trong bài báo do học viên cao học Akshat Shirish Zalte, tân tiến sĩ Jackson Burns, nhà khoa học nghiên cứu Charlles Abreu, Giáo sư William Green (đều thuộc MIT) cùng ba nhà nghiên cứu thuộc tập đoàn hóa chất BASF đồng tác giả.
Bản tiền ấn phẩm của bài báo đã được đăng tải trực tuyến từ năm ngoái, và mô hình mã nguồn mở mang tên CheMeleon do nhóm nghiên cứu phát triển hiện đã được một số công ty dược phẩm đưa vào sử dụng thường xuyên. CheMeleon được xây dựng dựa trên ChemProp – một gói học máy mã nguồn mở cũng do nhóm nghiên cứu của Giáo sư Green tại MIT phát triển và duy trì; bất kỳ ai cũng có thể tải CheMeleon thông qua ChemProp và tinh chỉnh (fine-tune) theo mục đích riêng.
Đầu năm nay, một cuộc thi do OpenADMET tổ chức nhằm dự đoán đặc tính của nhiều phân tử mới chưa từng được tổng hợp trước đó, theo Giáo sư Kỹ thuật Hóa học William Green (giữ chức danh Giáo sư Hoyt Hottel). “Đó là một cuộc thi quy mô lớn với đông đảo người tham gia”, ông cho biết. Khi kết quả được công bố, 9 trong số 20 giải pháp dẫn đầu đã ứng dụng CheMeleon vào quy trình thực hiện. “Sau đó, chúng tôi bắt đầu nhận được rất nhiều câu hỏi từ các công ty dược phẩm về mô hình này, dù bài báo của chúng tôi lúc đó mới chỉ được nộp và thậm chí còn chưa trải qua bình duyệt”.
Trong thời gian bài báo trải qua quy trình bình duyệt, tầm ảnh hưởng của nghiên cứu đã nhanh chóng lan rộng. Giáo sư Green cho biết, có ít nhất một công ty dược phẩm đã “gửi thông báo đến toàn thể nhân viên với yêu cầu: ‘Bất cứ khi nào mô hình hóa một đặc tính, hãy bắt đầu bằng CheMeleon, đó là chính sách mới của công ty’” khi đưa ra quyết định ban đầu về việc lựa chọn phân tử cần nghiên cứu.
Yếu tố cốt lõi của CheMeleon là việc tiền huấn luyện mô hình học máy với dữ liệu chi tiết của khoảng 1 triệu phân tử khác nhau, giúp mô hình nắm bắt được mối tương quan giữa cấu trúc phân tử và hành vi của phân tử đó dựa trên danh mục khoảng 1.600 chỉ số mô tả (descriptors) được các nhà hóa học phát triển qua nhiều thập kỷ. Sau đó, CheMeleon có thể được tinh chỉnh để dự đoán từ các đặc tính quen thuộc như độ tan và độ nhớt, cho đến các đặc tính chuyên biệt hơn như hoạt tính sinh học hoặc khả năng phản ứng với một loại protein hoặc enzyme nhất định.
Con số 1 triệu phân tử này chỉ chiếm một phần rất nhỏ trong vô số cách liên kết giữa các nguyên tử, nhưng đã cung cấp đủ dữ liệu mẫu để hệ thống AI sau khi được huấn luyện có thể tự nhận diện được nhiều quy luật tiềm ẩn.
các quy luật và mối quan hệ, sau đó áp dụng các yếu tố này vào một phân tử mới chưa từng được xác định khi đưa vào hệ thống.
Chuyên gia Zalte cho biết: “Hầu hết các mô hình học sâu hiện nay đòi hỏi lượng dữ liệu lớn hơn nhiều so với các phương pháp truyền thống”. Ông cho biết thêm, một số mô hình thành công sử dụng khối lượng lớn dữ liệu từ các tài liệu được công bố trên các tạp chí hóa học. “Chúng tôi hoàn toàn không dựa vào các tài liệu này, mà chỉ tính toán một nhóm các chỉ số mô tả phân tử, chẳng hạn như khối lượng phân tử hoặc số lượng nguyên tử oxy, cùng nhiều thông số khác”. Việc dự đoán các chỉ số mô tả này sau đó sẽ tạo nền tảng cho nhiệm vụ tiền huấn luyện của mô hình.
CheMeleon là một mô hình nền tảng được tiền huấn luyện. Lấy cảm hứng từ các mô hình ngôn ngữ nền tảng nổi tiếng như ChatGPT và Claide — vốn được phát triển bằng cách nạp khối lượng thông tin khổng lồ từ mạng internet — CheMeleon sử dụng các chỉ số mô tả phân tử của 1 triệu phân tử từ PubChem, một cơ sở dữ liệu mở quy mô lớn về thông tin hóa học do Viện Y tế Quốc gia Hoa Kỳ duy trì.
Mặt khác, đối với các mô hình cổ điển dựa trên chuyên gia, các chuyên gia trong ngành phải nhập thủ công những kiến thức chuyên sâu về lĩnh vực nghiên cứu. Ông cho biết, trong quá trình phát triển các mô hình cổ điển này, các nhà nghiên cứu nhận biết từ thực nghiệm rằng một đặc tính cần quan tâm, ví dụ như độ hòa tan, có thể liên quan đến các chỉ số mô tả cụ thể của chính phân tử đó, “như khối lượng phân tử, số lượng nguyên tử oxy hiện diện, hoặc mức độ phân nhánh và kích thước của phân tử”.
Với phương pháp tiếp cận của nhóm nghiên cứu, các chuyên gia có thể bắt đầu từ một cấu trúc mạng nơ-ron sẵn có và huấn luyện để hệ thống tiếp thu các nguyên lý nền tảng. Ông cho biết: “Chúng tôi không huấn luyện mô hình cho một đặc tính cụ thể, mà phát triển như một mô hình tổng quát có mức độ hiểu biết nhất định về hóa học. Nhờ đó, ngay cả khi chỉ tinh chỉnh với một vài điểm dữ liệu cho nhiệm vụ được quan tâm, hệ thống vẫn có thể đạt hiệu quả cao”. Điều này đạt được là nhờ mô hình “không phải học lại mọi thứ từ đầu”.
Để kiểm chứng tính hữu dụng, chuyên gia Zalte cho biết: “Chúng tôi đã so sánh mô hình của mình không chỉ với các mô hình nền tảng hiện có khác, mà còn với các mô hình cổ điển ứng dụng các nguyên lý do chuyên gia thiết lập”. Khi đối chiếu hiệu suất qua 58 trường hợp thử nghiệm, “kết quả cho thấy mô hình của chúng tôi đạt vị trí dẫn đầu”.
Chuyên gia Green cho biết thêm: “Mô hình nền tảng CheMeleon làm giảm đáng kể số lượng phân tử cần phải thử nghiệm thực tế để dự đoán chính xác các đặc tính của phân tử mới. Đây là một lợi thế rất lớn, bởi việc tổng hợp và kiểm tra một lượng lớn phân tử thường tốn nhiều thời gian và chi phí”.
Ngoài các thành viên thuộc MIT, nhóm nghiên cứu còn bao gồm Jochen Sieg, Chri
Nguồn tin: MIT News AI — Tác giả: David L. Chandler | Department of Chemical Engineering. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.