
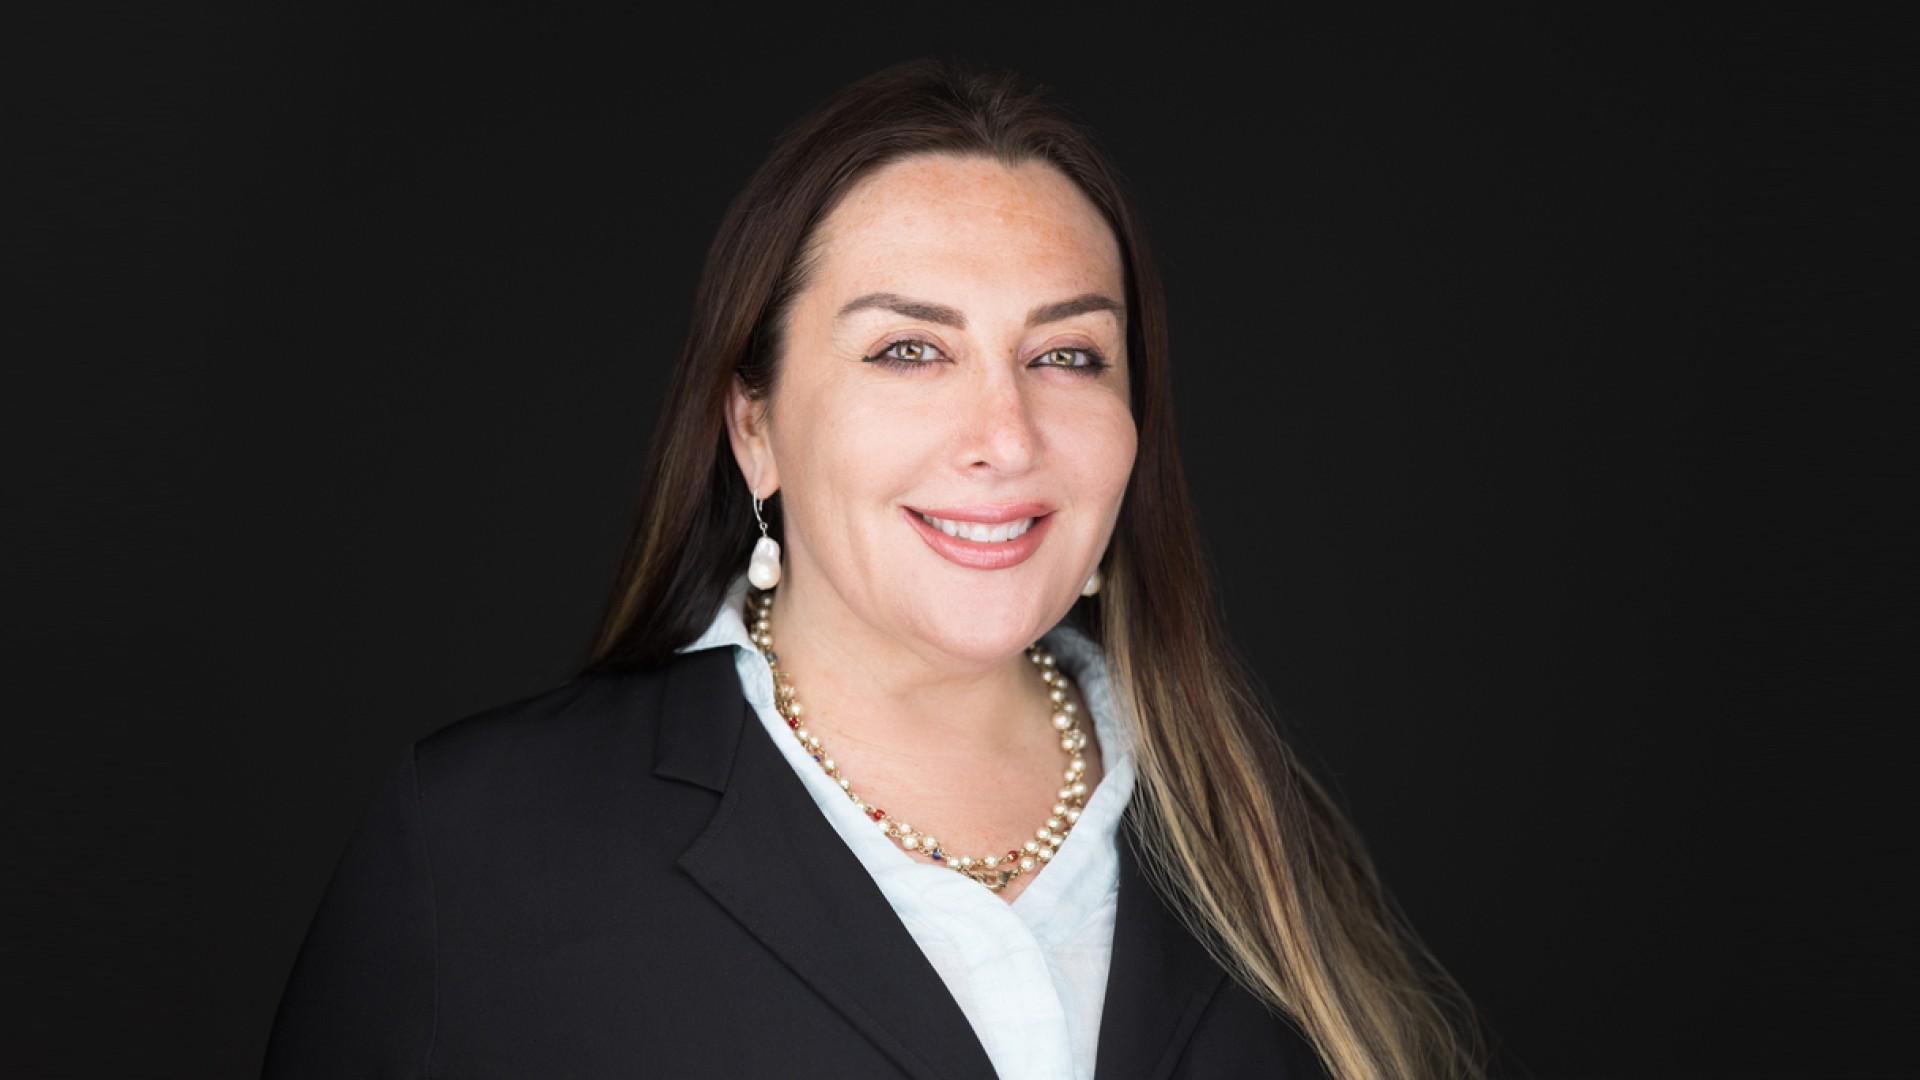
Olga Beregovaya, Phó Chủ tịch phụ trách AI tại Smartling – Loạt bài phỏng vấn
Bà Olga Beregovaya là Phó Chủ tịch phụ trách AI tại Smartling, nơi bà lãnh đạo chiến lược AI trên các mảng dịch thuật, dữ liệu, chất lượng và an toàn. Bà hoạt động trong lĩnh vực xử lý ngôn ngữ tự nhiên từ năm 1997, trải qua các giai đoạn phát triển từ hệ thống dựa trên luật, mô hình thống kê, mạng nơ-ron đến các mô hình ngôn ngữ lớn (LLM). Trước khi gia nhập Smartling, bà từng giữ chức Phó Chủ tịch phụ trách Đổi mới AI tại Welocalize và Giám đốc điều hành (CEO) của PROMT Americas. Smartling cung cấp phần mềm và dịch vụ dịch thuật, bản địa hóa cho doanh nghiệp, kết hợp giữa AI và dịch máy…
Phỏng vấn
Olga Beregovaya, Phó Chủ tịch phụ trách AI tại Smartling – Loạt bài phỏng vấn
Đăng ngày
Ngày 27/10/2026
Tác giả
Antoine Tardif, CEO và Nhà sáng lập của Unite.AI
Thêm Unite.AI vào danh sách nguồn tin ưu tiên trên Google
Bà Olga Beregovaya hiện là Phó Chủ tịch phụ trách AI tại Smartling, nơi bà chỉ đạo chiến lược AI trên các mảng dịch thuật, dữ liệu, chất lượng và an toàn. Bà làm việc trong lĩnh vực xử lý ngôn ngữ tự nhiên từ năm 1997, trải qua các giai đoạn phát triển từ hệ thống dựa trên quy tắc, mô hình thống kê, mạng nơ-ron đến các mô hình ngôn ngữ lớn (LLM). Trước khi gia nhập Smartling, bà từng giữ chức Phó Chủ tịch Đổi mới AI tại Welocalize và Giám đốc điều hành của PROMT Americas.
Smartling cung cấp phần mềm và dịch vụ dịch thuật, bản địa hóa cho doanh nghiệp, kết hợp AI và dịch máy với chuyên môn của con người. Nền tảng của công ty hỗ trợ quy trình làm việc đa ngôn ngữ cho các trang web, ứng dụng, hoạt động tiếp thị, tài liệu và đa phương tiện, với khả năng tiếp cận hơn 20 LLM và công cụ dịch máy. Trong cuộc phỏng vấn này, bà Beregovaya thảo luận về khoảng cách AI đa ngôn ngữ, chất lượng dịch thuật, việc lựa chọn mô hình và vai trò giám sát của con người trong quá trình bản địa hóa tự động.
Hành trình đó đã định hình tư duy về vai trò của AI đối với ngôn ngữ ra sao, và điều gì đã thúc đẩy quyết định đảm nhiệm vai trò lãnh đạo chiến lược AI tại Smartling?
Việc nghiên cứu cấu trúc ngôn ngữ và cơ chế vận hành của các ngữ hệ cho thấy dịch thuật là vấn đề về cấu trúc và ngữ nghĩa, không đơn thuần là sự thay thế từng từ ngữ. Cách tiếp cận đối với AI cũng theo định hướng tương tự.
Công việc trong lĩnh vực xử lý ngôn ngữ tự nhiên được bắt đầu từ năm 1997, thời điểm các hệ thống còn được xây dựng dựa trên các quy tắc thủ công. Kể từ đó, tiến trình công việc đã trải qua các mô hình thống kê, mạng nơ-ron và hiện nay là các mô hình ngôn ngữ lớn. Mỗi mô hình giải quyết được một số vấn đề nhưng cũng làm phát sinh những thách thức khác. Không có mô hình đơn lẻ nào là lời giải toàn diện.
Quyết định gia nhập Smartling xuất phát từ việc nền tảng này được xây dựng nhằm dịch thuật mọi loại nội dung doanh nghiệp, từ trang web, ứng dụng đến tài liệu pháp lý, tiếp thị và video. Khởi đầu với vị trí Phó Chủ tịch Dịch máy, vai trò này nhanh chóng mở rộng ngoài phạm vi dịch thuật sang lĩnh vực câu lệnh (prompting), dữ liệu, chất lượng và an toàn. Do đó, chức danh đã được chuyển đổi thành Phó Chủ tịch phụ trách AI.
Khoảng cách đó biểu hiện trên thực tế như thế nào, và vì sao vấn đề này có thể dẫn đến nhiều hệ quả hơn khi AI tạo sinh trở thành giao diện tương tác chủ đạo?
Khoảng cách này trước đây rất rõ ràng: một hệ thống AI hoặc hỗ trợ, hoặc không hỗ trợ một ngôn ngữ nhất định. Vấn đề đó hiện cơ bản đã được giải quyết, nhưng khoảng cách lại biến chuyển sang hình thái khác. Điểm mấu chốt hiện nay là mức độ dữ liệu huấn luyện của mô hình phản ánh chuẩn xác ngôn ngữ, cộng đồng người sử dụng và nền văn hóa của ngôn ngữ đó. Phần lớn dữ liệu huấn luyện mô hình bằng tiếng Anh, do đó mang theo các giả định của thế giới nói tiếng Anh. Một bản dịch có thể chuẩn xác về mặt kỹ thuật nhưng vẫn áp đặt góc nhìn của văn hóa Anh ngữ lên một ngôn ngữ khác.
AI đang dần trở thành phương thức tương tác giữa người dân với ngân hàng, y tế, trường học và các dịch vụ thiết yếu khác. Một ngôn ngữ được AI xử lý tốt sẽ tạo ra lợi thế, trong khi một ngôn ngữ bị xử lý kém sẽ đẩy người sử dụng vào thế bất lợi.
Điểm bất ngờ nhất là gì, và điều gì lý giải cho các trường hợp tiếng Thụy Điển cho kết quả vượt trội hơn tiếng Hindi dù có lượng người nói ít hơn nhiều?
Số lượng người nói thực tế lại là một chỉ số rất thiếu tin cậy về chất lượng dịch thuật. Tiếng Thụy Điển, với khoảng 10 triệu người nói, lại cho ra một số kết quả tốt nhất. Tiếng Hindi, với khoảng 600 triệu người nói, lại thuộc nhóm kết quả kém nhất, cùng với tiếng Estonia và tiếng Thái.
Cấu trúc ngôn ngữ và chất lượng dữ liệu có vai trò quyết định hơn nhiều. Tiếng Thụy Điển có ngữ pháp tương đối đơn giản và nguồn dữ liệu huấn luyện sạch dồi dào. Tiếng Estonia liên tục biến đổi hậu tố của từ để truyền tải ngữ nghĩa, tạo ra sự phức tạp lớn hơn cho việc xử lý của AI. Tiếng Hindi có hàng trăm triệu người nói, nhưng lượng dữ liệu huấn luyện chất lượng cao và đa dạng lại ít hơn nhiều so với con số kỳ vọng dựa trên quy mô dân tộc.
Một điều bất ngờ khác là tiến bộ không đồng đều giữa các đơn vị nghiên cứu. Những ngôn ngữ ban đầu ở mức kém hơn thường đạt mức cải thiện lớn nhất qua từng thế hệ mô hình n
từ thế hệ này sang thế hệ tiếp theo, song quy luật đó không phải lúc nào cũng đúng.
Ngoài khối lượng dữ liệu huấn luyện, những yếu tố nào ảnh hưởng nhiều nhất đến hiệu năng của mô hình?
Tokenization là một trong những yếu tố lớn nhất. Đây là phương thức mô hình phân tách văn bản thành các đơn vị nhỏ trước khi xử lý, có vai trò đặc biệt quan trọng đối với các ngôn ngữ không sử dụng bảng chữ cái Latinh. Quá trình tokenization kém sẽ làm hạn chế mọi khâu xử lý sau đó.
Cấu trúc ngôn ngữ cũng đóng vai trò quan trọng. Những ngôn ngữ có cấu trúc biến tố đuôi từ phức tạp thường gây khó khăn hơn cho các mô hình xử lý. Đơn cử như tiếng Đức ghép các từ lại với nhau khiến một từ đơn lẻ có thể dài tới 40 ký tự, đòi hỏi năng lực xử lý của mô hình cao hơn so với các ngôn ngữ như tiếng Tây Ban Nha hay tiếng Pháp.
Yếu tố tiếp theo là chất lượng dữ liệu. Dữ liệu kém chất lượng sẽ tạo ra kết quả kém. Độ chính xác, tính biến thiên và tính đại diện của dữ liệu giữ vai trò mang tính quyết định đối với hiệu năng dịch thuật của AI.
Cuối cùng là công tác đo lường. Các thước đo TER, BLEU, CHRF3 và MetricX được sử dụng để đối chiếu kết quả với các bản dịch đáng tin cậy của con người. Một mô hình có thể tạo ra câu văn tự nhiên nhưng vẫn truyền tải sai lệch ý nghĩa.
Các phòng thí nghiệm tiên phong có trách nhiệm gì, và tiến bộ mang tính thực chất sẽ diễn ra như thế nào?
Các phòng thí nghiệm tiên phong mang trọng trách lớn nhất vì nắm quyền kiểm soát những mô hình ngôn ngữ tiên tiến nhất. Các quyết định của những đơn vị này có thể nới rộng khoảng cách hoặc góp phần thu hẹp sự chênh lệch đó. Dù vậy, mảng dịch thuật thường phải cạnh tranh mức độ ưu tiên với năng lực suy luận, lập trình và tính an toàn, do đó rất ít phòng thí nghiệm có các nhóm chuyên trách tập trung vào lĩnh vực này.
Có ba yếu tố sẽ tạo ra sự thay đổi mang tính thực chất:
Xây dựng nguồn dữ liệu chất lượng cao trên nhiều ngôn ngữ và lĩnh vực hơn.
Cải thiện quá trình phân tách từ (tokenization) đối với những ngôn ngữ mà các phương pháp hiện tại chưa đáp ứng hiệu quả.
Đồng thời, đánh giá từng mô hình mới dựa trên các ngôn ngữ có ít dữ liệu huấn luyện, thay vì chỉ tập trung vào những ngôn ngữ phổ biến nhất.
Một cơ hội lớn hiện nay là xây dựng dữ liệu huấn luyện cho các ngôn ngữ có mức độ hiện diện rất thấp trên mạng internet. Phần lớn công việc này được triển khai bên ngoài các phòng nghiên cứu lớn. Đơn vị hợp tác với các tổ chức như African Language Lab để xây dựng cơ sở dữ liệu cho các ngôn ngữ châu Phi.
Làm thế nào để Smartling xác định được công cụ phù hợp trong số hơn 20 công cụ hiện có đối với một ngôn ngữ, loại nội dung hoặc trường hợp sử dụng cụ thể?
Các công cụ đều được đưa vào thử nghiệm thay vì mặc định một mô hình là tối ưu nhất. Mỗi mô hình được đánh giá dựa trên các bản dịch chuẩn của con người thông qua các chỉ số TER, BLEU, CHRF3 và MetricX. Khách hàng có thể cung cấp nội dung tiếp thị, và trong vòng khoảng một tuần...


Nguồn tin: Unite AI — Tác giả: Antoine Tardif, CEO & Founder of Unite.AI. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.