
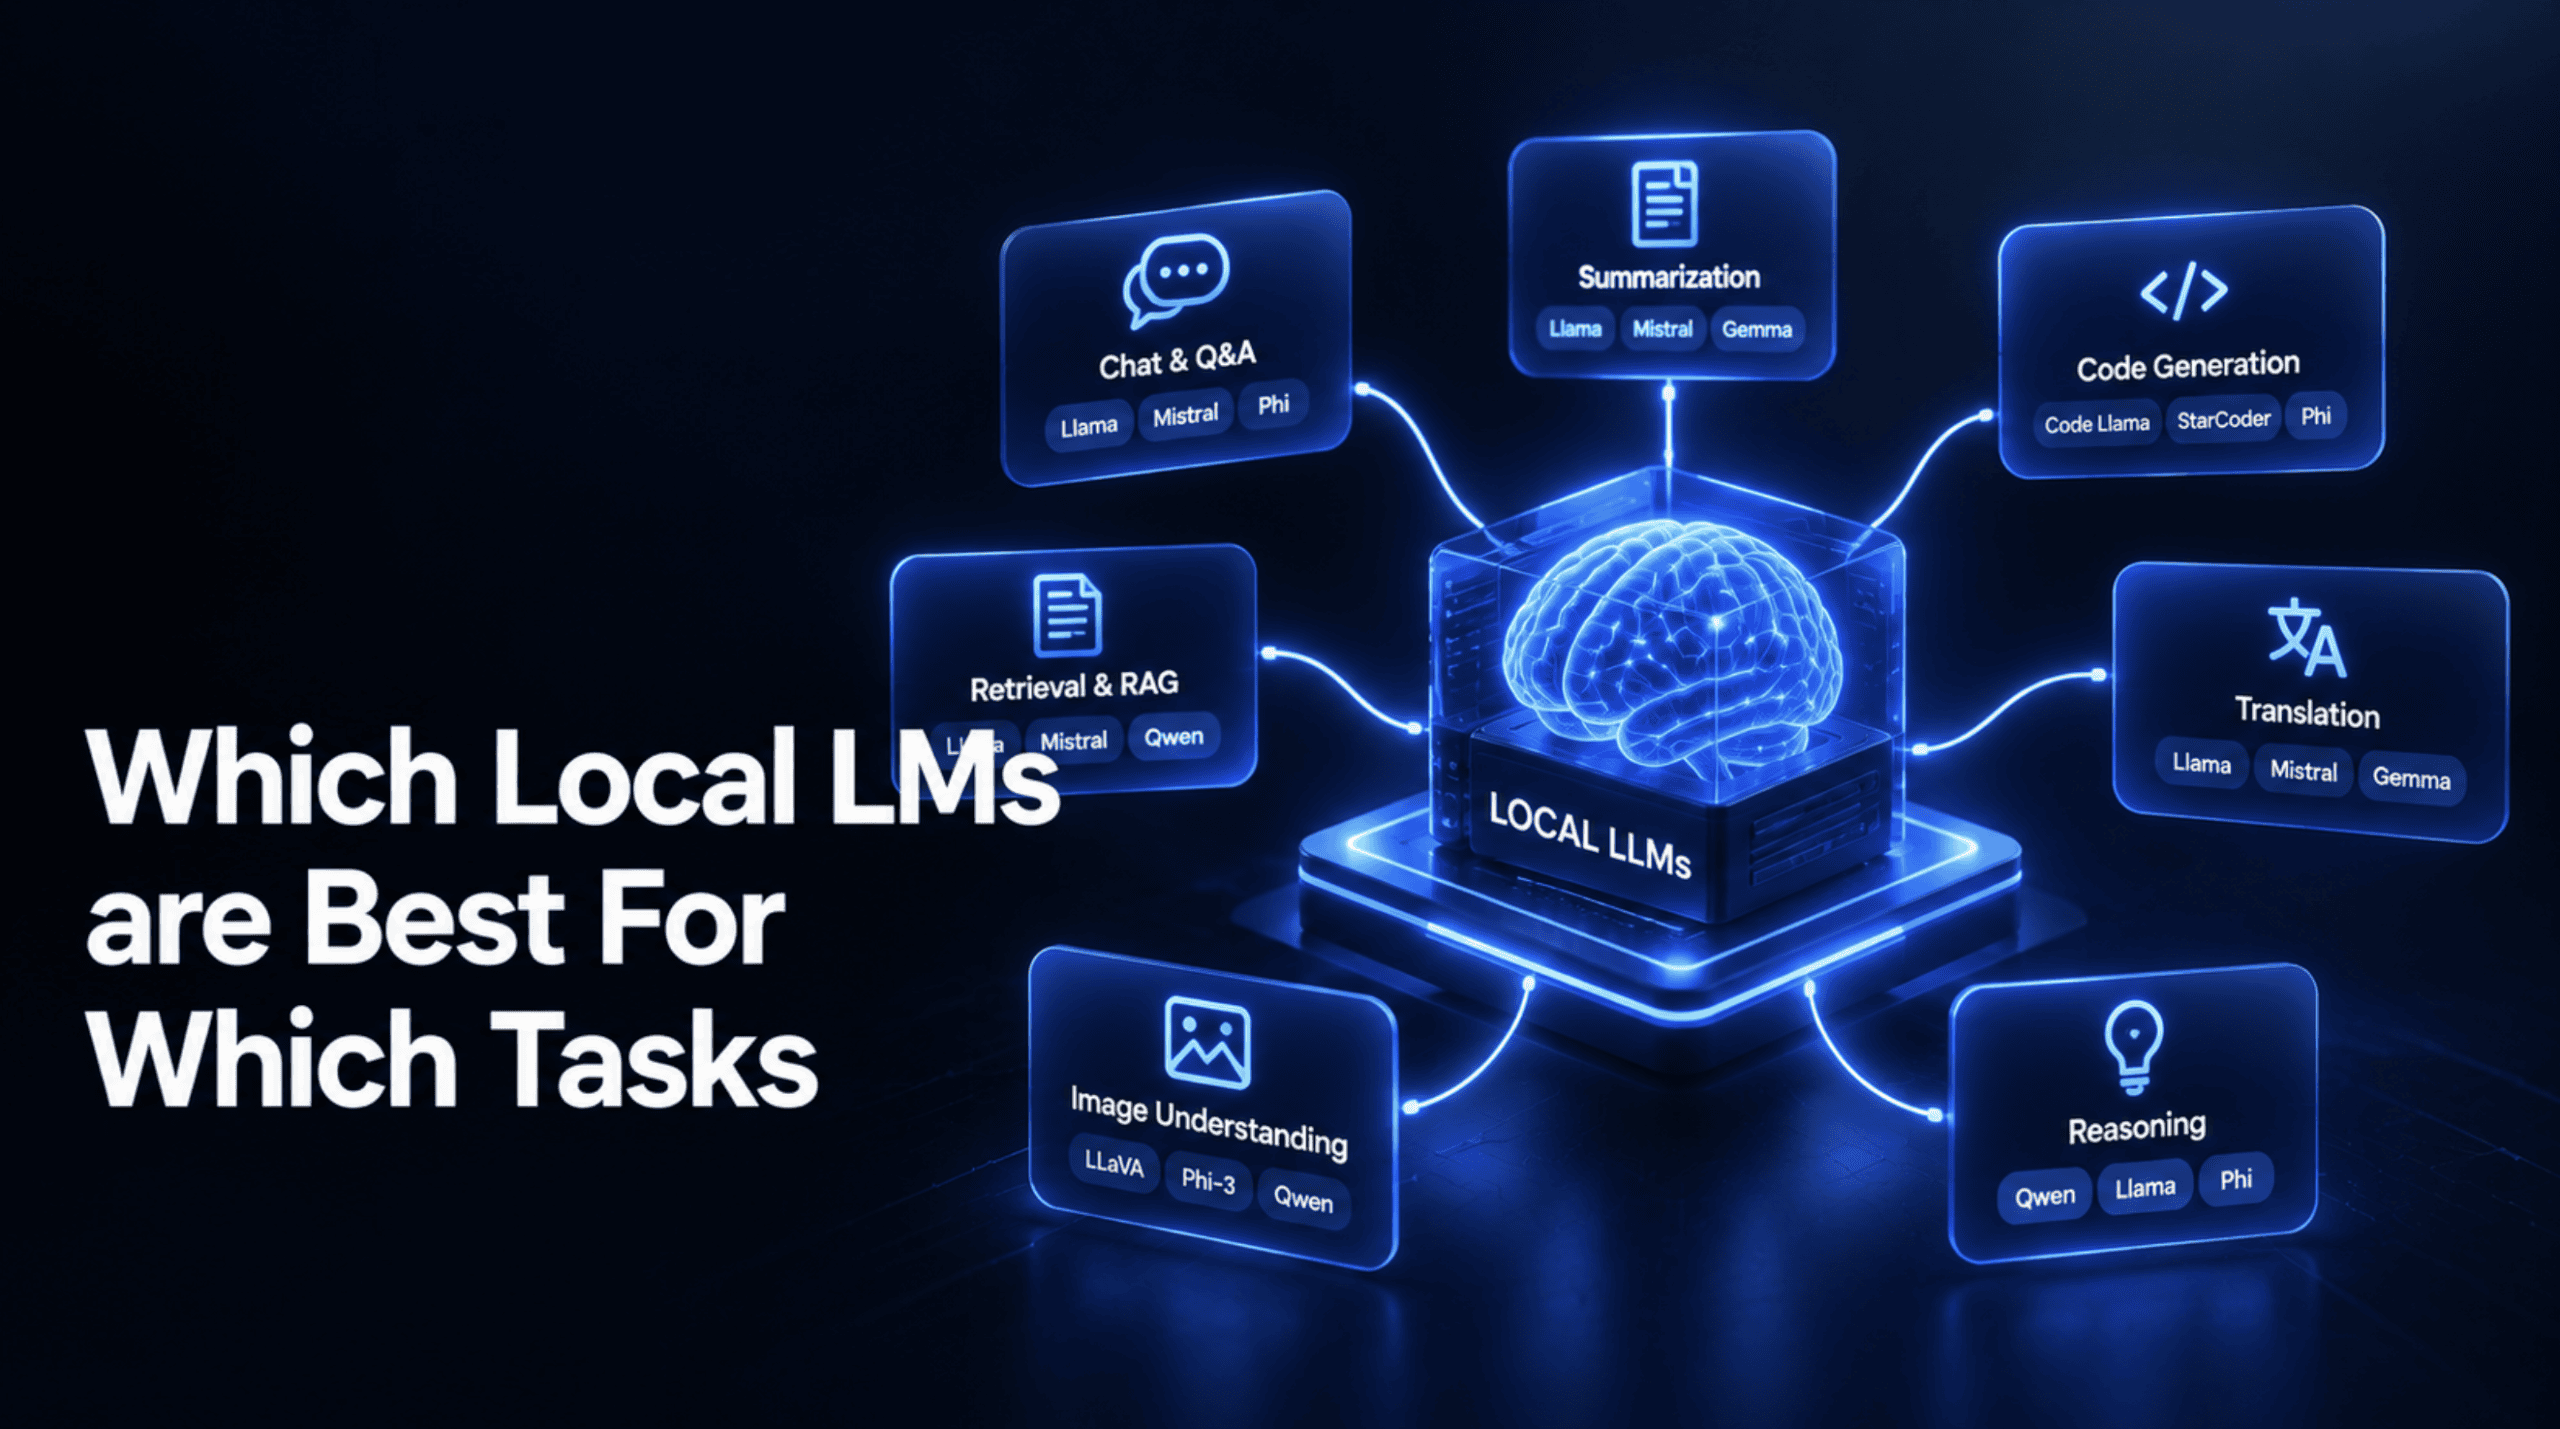
Những mô hình ngôn ngữ cục bộ (Local LM) nào tối ưu nhất cho từng tác vụ
Mô hình ngôn ngữ cục bộ là mô hình mà toàn bộ trọng số thực tế—tệp dữ liệu khổng lồ gồm các tham số số học cấu thành mô hình đã qua huấn luyện—được tải về và vận hành hoàn toàn trên hệ thống phần cứng riêng của người sử dụng.
Những mô hình ngôn ngữ cục bộ tối ưu cho từng tác vụ - KDnuggets
Chuyên mục
Bài viết nổi bật
Giới thiệu
Chủ đề
AI
Lời khuyên nghề nghiệp
Thị giác máy tính
Kỹ thuật dữ liệu
Khoa học dữ liệu
Mô hình ngôn ngữ
Học máy
MLOps
NLP
Lập trình
Python
SQL
Tập dữ liệu
Sự kiện
Tài nguyên
Tài liệu tóm tắt
Đề xuất
Tóm tắt công nghệ
Quảng cáo
Đăng ký nhận bản tin
Những mô hình ngôn ngữ cục bộ tối ưu cho từng tác vụ
Mô hình ngôn ngữ cục bộ là mô hình cho phép tải toàn bộ trọng số thực tế—tệp dữ liệu quy mô lớn chứa các tham số được tạo ra sau quá trình huấn luyện—để vận hành hoàn toàn trên phần cứng của người dùng.
Tác giả: Shittu Olumide, Chuyên viên Nội dung Kỹ thuật, ngày 28/10/2026, chuyên mục Mô hình ngôn ngữ
Nhiều người dành cả buổi tối để đọc các bài tổng hợp về "LLM cục bộ tốt nhất", chọn cái tên xuất hiện nhiều nhất ở các vị trí đầu bảng, tải về máy và ứng dụng vào công việc cụ thể cần xử lý trong tuần, ví dụ như hoàn thiện một đoạn mã Python. Tuy nhiên, kết quả đạt được chỉ ở mức trung bình. Mô hình không gặp lỗi kỹ thuật nhưng không đem lại hiệu quả ấn tượng, tương tự như việc một nhân sự tổng quát xử lý công việc đòi hỏi chuyên môn sâu. Bản thân mô hình không kém, song vốn không được thiết kế chuyên biệt cho lập trình, trong khi các bài viết đề xuất lại không nêu rõ điểm này.
Sự thiếu tương thích này chính là lý do bài hướng dẫn này được biên soạn. Khái niệm "tốt nhất" không thể gói gọn trong một bảng xếp hạng duy nhất, và việc nhìn nhận theo cách này dễ dẫn đến việc đánh giá thấp một mô hình vốn có năng lực thực sự. Bài viết tiếp cận vấn đề theo hướng ngược lại: làm rõ bản chất của mô hình ngôn ngữ cục bộ, lý do việc vận hành trên phần cứng cá nhân là cần thiết, đồng thời phân tích cụ thể thế mạnh của từng mô hình dựa trên dẫn chứng thực tế thay vì cảm tính. Phần cuối bài cung cấp bảng tổng hợp nhằm giải quyết câu hỏi trọng tâm: mô hình nào phù hợp nhất cho tác vụ cụ thể đang cần xử lý?
Khái niệm mô hình ngôn ngữ và đặc tính "cục bộ"
Về bản chất, mô hình ngôn ngữ là một hệ thống được huấn luyện để dự đoán văn bản: dựa trên toàn bộ nội dung xuất hiện trước đó trong cuộc hội thoại hoặc tài liệu, hệ thống sẽ xác định phần văn bản tiếp theo có khả năng xuất hiện cao nhất. Cơ chế hoạt động này, khi được triển khai ở quy mô lớn, cho phép mô hình trả lời câu hỏi, viết mã lập trình, tóm tắt văn bản hoặc duy trì hội thoại. Các sản phẩm trò chuyện AI phổ biến hiện nay như ChatGPT, Claude hay Gemini đều được xây dựng dựa trên nguyên lý cốt lõi này.
Thuật ngữ "cục bộ" thể hiện phương thức tiếp cận mô hình, không định nghĩa bản chất kỹ thuật của mô hình. Mô hình ngôn ngữ cục bộ yêu cầu tải toàn bộ tệp trọng số thực tế về thiết bị và vận hành hoàn toàn trên hạ tầng phần cứng của người dùng. Quá trình này không phát sinh lệnh gọi API rời khỏi thiết bị, không yêu cầu tài khoản sử dụng và không gửi dữ liệu đầu vào (prompt) tới máy chủ của bất kỳ tổ chức nào. Đây là điểm khác biệt căn bản so với việc sử dụng mô hình trên máy chủ đám mây qua trang web hoặc mã khóa API, nơi mọi yêu cầu xử lý đều chuyển về hạ tầng của bên thứ ba và người dùng chỉ có quyền truy vấn thay vì sở hữu mô hình.
Giá trị thực tiễn của mô hình ngôn ngữ cục bộ
Quyền riêng tư là lợi ích rõ ràng nhất: khi dữ liệu đầu vào không rời khỏi thiết bị, các bên thứ ba không thể ghi lại nhật ký, sử dụng dữ liệu để huấn luyện hay làm rò rỉ thông tin. Yếu tố này mang tính quyết định đối với dữ liệu khách hàng, hồ sơ y tế, các công trình chưa công bố hoặc tài liệu nội bộ của doanh nghiệp.
Chi phí là yếu tố thứ hai. Khi các trọng số đã được lưu trữ trên ổ đĩa, hệ thống sẽ không phát sinh cước phí tính theo từng token đối với mỗi yêu cầu. Điều này làm thay đổi hoàn toàn bài toán chi phí đối với các tác vụ có quy mô lớn hoặc mang tính thử nghiệm.
Khả năng vận hành ngoại tuyến (offline) là yếu tố thứ ba, mang lại hiệu quả thiết thực cho công tác thực địa, các môi trường cách ly mạng (air-gapped) hoặc những khu vực có kết nối mạng không ổn định.
Quyền kiểm soát là yếu tố thứ tư và thường bị đánh giá thấp nhất: mô hình cục bộ không bị âm thầm thay thế, khai tử hay thay đổi hành vi do các bản cập nhật từ nhà cung cấp; mô hình duy trì hiệu suất đồng nhất theo thời gian nhờ quyền kiểm soát hoàn toàn các trọng số từ phía người dùng.
Ollama, công cụ đã trở thành tiêu chuẩn thực tế để vận hành các mô hình cục bộ, hiện cung cấp một thư viện công khai gồm các bản dựng định dạng GGUF sẵn sàng triển khai cho toàn bộ các mô hình được đề cập trong bài viết. Số lượt tải thực tế của một số mô hình, được phân tích chi tiết ở phần sau, đã lên tới hàng chục triệu.
Khái niệm "tốt nhất" phụ thuộc vào tác vụ cụ thể, không phụ thuộc vào bảng xếp hạng
Đây là luận điểm cốt lõi xuyên suốt bài viết và cần được làm rõ. Điểm số tiêu chuẩn tổng hợp duy nhất hoặc số lượng tham số thuần túy phản ánh rất ít về khả năng đáp ứng thực tế của một mô hình đối với một tác vụ cụ thể. Một mô hình có thể đạt điểm cao về kiến thức đại cương nhưng chỉ viết mã nguồn ở mức trung bình. Một mô hình nhỏ, tối ưu có thể dẫn đầu phân khúc về khả năng gọi công cụ (tool calling) nhưng lại tụt hậu đáng kể ở tác vụ viết sáng tạo. Việc chỉ dựa vào một chỉ số đơn lẻ để xếp hạng dễ dẫn đến sự đánh giá sai lệch đối với những mô hình vốn có chất lượng tốt nhưng bị sử dụng không đúng mục đích.
Việc nắm rõ bản chất các chỉ số đo lường trong bài viết là điều cần thiết, do các tiêu chí này không thể thay thế cho nhau. Tiêu chuẩn MMLU (Massive Multitask Language Understanding) kiểm tra kiến thức tổng quát trên hàng chục lĩnh vực học thuật, phản ánh mức độ hiểu biết chung của một mô hình.
HumanEval đánh giá cụ thể khả năng viết mã chính xác và vận hành được đối với một bài toán cụ thể, phản ánh trực tiếp năng lực lập trình thay vì trí tuệ tổng quát. MT-Bench đo lường mức độ tuân thủ chỉ dẫn và khả năng duy trì hội thoại nhiều lượt một cách mạch lạc. Những khác biệt này cần được lưu ý khi đối chiếu số liệu của từng mô hình dưới đây, bởi việc dẫn đầu ở một tiêu chí không bảo đảm kết quả tương tự ở các tiêu chí còn lại.
Đánh giá chi tiết từng mô hình
Bài viết phân tích bảy mô hình: sáu mô hình trò chuyện đa năng cùng một mô hình nhúng (embedding model) đóng vai trò thiết yếu trong các hệ thống tạo sinh tăng cường truy xuất (RAG) cục bộ. Mọi nhận định dưới đây đều đ


Nguồn tin: KDnuggets — Tác giả: Shittu Olumide. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.