
Nghiên cứu mới đánh giá liệu các mô hình AI có nhận biết được suy nghĩ của chính mình
Đường dẫn bài viết: https://www.quantamagazine.org/new-research-tests-whether-ai-models-know-their-own-thoughts-20261104/ Đường dẫn bình luận: https://news.ycombinator.com/item?id=50420330 Điểm: 1 Số bình luận: 0
Trang chủ
Nghiên cứu mới thử nghiệm khả năng tự nhận biết suy nghĩ của các mô hình AI
Bình luận
Lưu bài viết
Đọc sau
Chia sẻ
Facebook
Đã sao chép!
Sao chép liên kết
Email
Pocket
Reddit
Ycombinator
Bình luận
Bình luận
Lưu bài viết
Đọc sau
Đọc sau
Trí tuệ nhân tạo
Nghiên cứu mới thử nghiệm khả năng tự nhận biết suy nghĩ của các mô hình AI
Tác giả:
Ben Brubaker
Ngày 4/11/2026
Bằng cách can thiệp trực tiếp các "suy nghĩ" vào những mô hình ngôn ngữ lớn, các nhà nghiên cứu đang nỗ lực xác định năng lực nội quan của trí tuệ nhân tạo (AI).
Bình luận
Lưu bài viết
Đọc sau
Thêm vào nguồn ưu tiên
(mở trong thẻ mới)
i
Nhấp để yêu cầu Google ưu tiên Quanta và xem thêm các nội dung chuyên sâu về khoa học và toán học trong kết quả tìm kiếm cũng như AI.
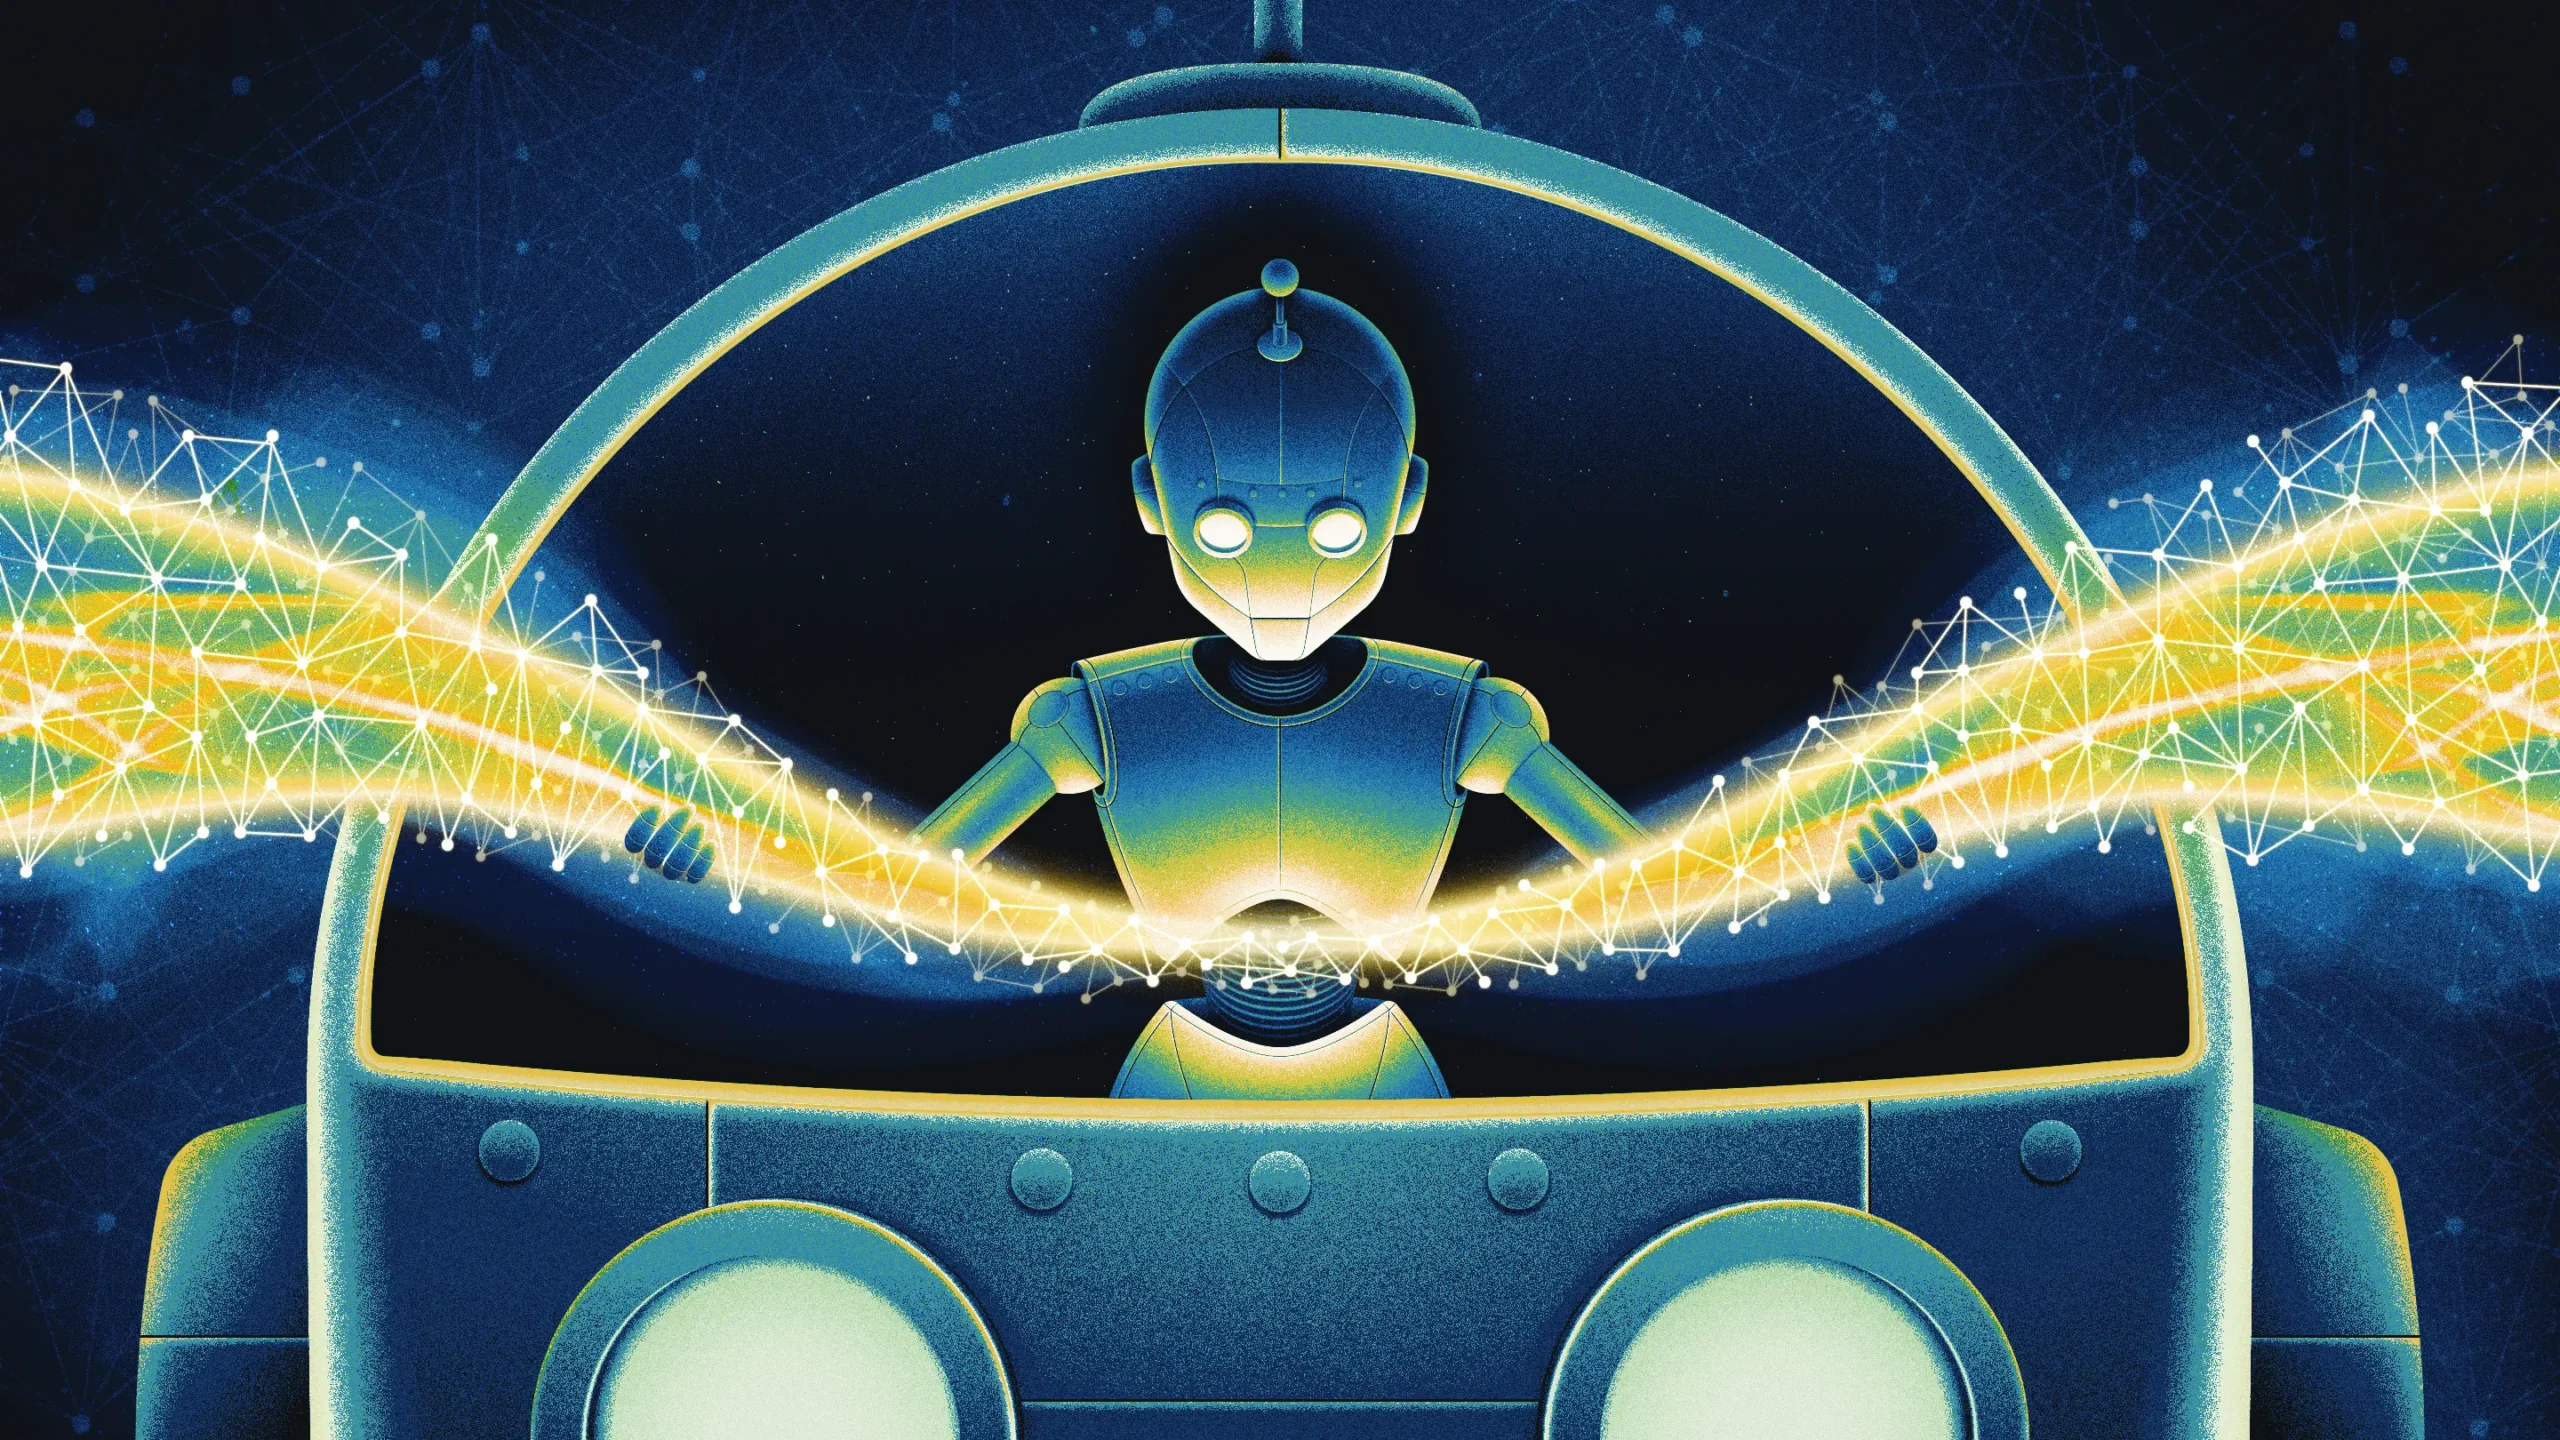
Kristina Armitage/Quanta Magazine
Tác giả: Ben Brubaker
Phóng viên
Ngày 4/11/2026
Xem bản PDF/Chế độ in
trí tuệ nhân tạo
khoa học nhận thức
khoa học máy tính
ý thức
khả năng diễn giải
mô hình ngôn ngữ lớn
học máy
mạng nơ-ron
Tất cả chủ đề
Tâm trí con người đang nghĩ gì ngay lúc này? Câu hỏi này có thể được trả lời mà không cần suy nghĩ quá nhiều. Việc nhận thức được các tiến trình tư duy của chính mình — năng lực được gọi là nội quan — dường như là khả năng tự nhiên của con người.
Tuy nhiên, trong giới triết gia và tâm lý học, nội quan vẫn là chủ đề gây tranh luận sôi nổi. Một số quan điểm cho rằng năng lực này gắn liền với ý thức. Số khác nhận định đây chỉ là một sự ngụy tạo tinh vi. Việc kiểm chứng các lý thuyết về nội quan trong phòng thí nghiệm — hoặc xác định một định nghĩa chính xác ngay từ đầu — là điều không hề đơn giản.
Hiện nay, sau hơn một thế kỷ nghiên cứu hiện tượng nội quan ở người và động vật, các nhà khoa học đã bắt đầu tìm hiểu hiện tượng này trên những đối tượng nghiên cứu mới: các mô hình ngôn ngữ lớn (LLM). Những hệ thống này dựa trên các cấu trúc toán học gọi là mạng nơ-ron, thể hiện sự vượt trội trong các tác vụ nhận thức vốn từng được xem là đặc quyền của con người. Liệu các hệ thống này có khả năng tự nội quan?
Năm 2025, Jack Lindsey, nhà nghiên cứu tại Anthropic, đã xây dựng phương pháp kiểm tra khả năng nội quan của các mô hình ngôn ngữ bằng cách đưa các "suy nghĩ" vào mạng nơ-ron của chúng — tương tự như một phương thức can thiệp phẫu thuật thần kinh kỹ thuật số có định hướng. Thí nghiệm của Lindsey cho thấy, trong một số trường hợp, các mô hình có thể phát hiện và mô tả các can thiệp này. Hiện tượng quan sát được mang nhiều đặc điểm tương đồng với năng lực nội quan.
Báo cáo nghiên cứu của Lindsey được chủ động giới hạn trong phạm vi hẹp và không đưa ra những tuyên bố khái quát về ý thức (cụ thể, nghiên cứu không hàm ý rằng các mô hình ngôn ngữ sở hữu trải nghiệm chủ quan ở ngôi thứ nhất). Dù vậy, công trình vẫn thu hút sự quan tâm lớn trong cộng đồng mạng. Nhiều nhà nghiên cứu đã nhanh chóng tái lập nghiên cứu của Lindsey trên các mô hình khác.
Sau một năm, bức tranh toàn cảnh đã dần trở nên rõ ràng hơn. Một số khía cạnh của hiện tượng do Lindsey ghi nhận có thể được giải thích bằng các cơ chế đơn giản hơn, không liên quan đến nội quan. Trong khi đó, các khía cạnh khác vẫn khó có thể bác bỏ, song câu hỏi liệu chúng có thực sự được coi là nội quan hay không vẫn đang là chủ đề tranh luận gay gắt.
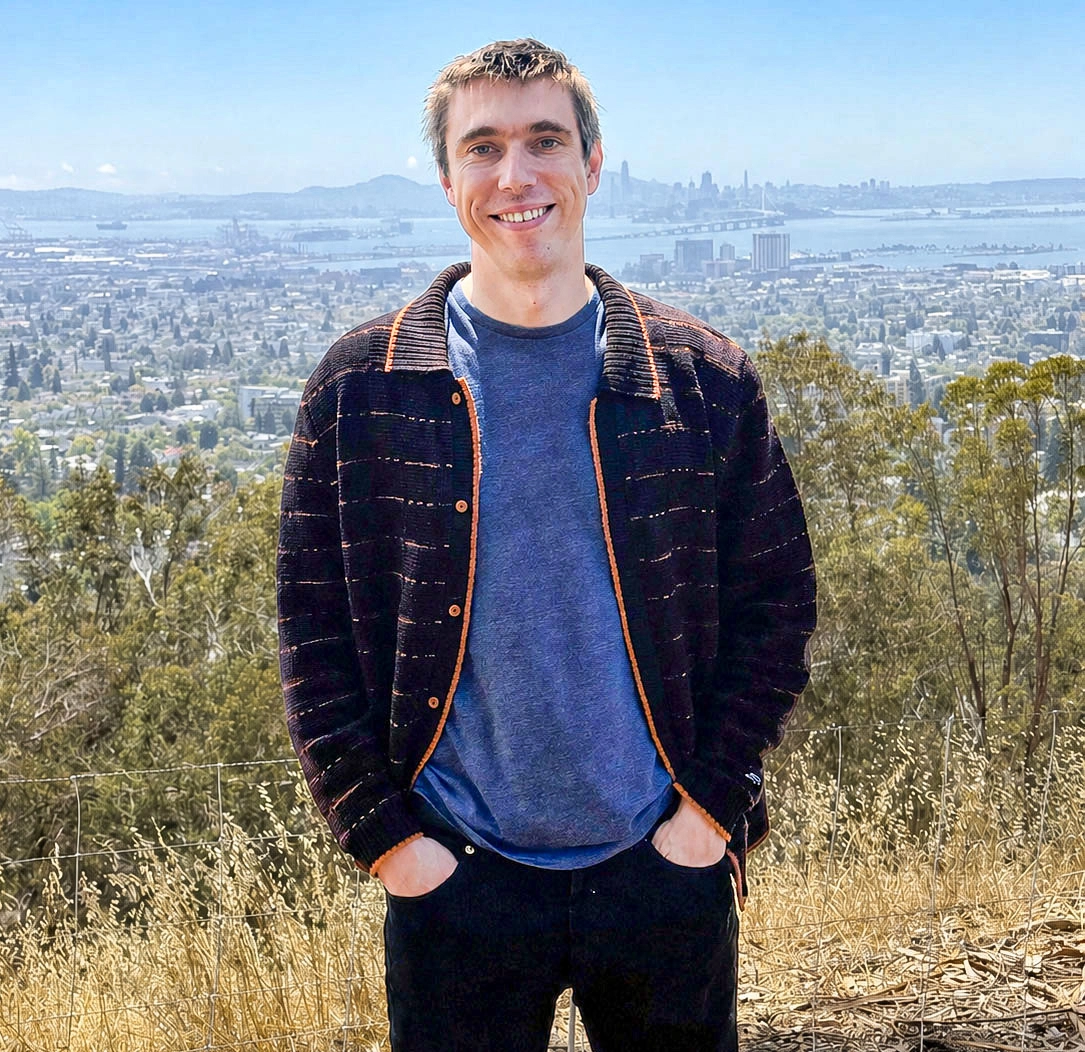
Jack Lindsey, nhà nghiên cứu tại Anthropic, đã tiến hành thử nghiệm nhằm xác định liệu các mô hình ngôn ngữ lớn (LLM) có khả năng “tự nhận thức” (introspect) hay không, thông qua một phương pháp can thiệp tương tự phẫu thuật thần kinh kỹ thuật số.
Ảnh: Jack Lindsey
Đây là giai đoạn phát triển sôi động của lĩnh vực này, khi các nhà nghiên cứu đang thiết kế những thử nghiệm thực tế cho các câu hỏi từng được coi là mang tính triết học. Ông Lindsey cho biết: “Trong bối cảnh lý thuyết chưa đạt được sự đồng thuận chung, tôi cho rằng hướng đi tốt nhất hiện nay là đẩy mạnh nghiên cứu khoa học thực nghiệm”.
Vải denim, sự bí mật và rau củ
Các mô hình ngôn ngữ học cách tạo ra những câu văn lưu loát thông qua quá trình “huấn luyện” trên khối lượng dữ liệu văn bản đồ sộ do con người tạo ra. Điều này đồng nghĩa với việc khi được hỏi về “suy nghĩ” của mình, câu trả lời của các mô hình có thể chỉ là sự mô phỏng lại các phản hồi có trong dữ liệu huấn luyện. Nhà nghiên cứu mô hình ngôn ngữ Shauli Ravfogel tại New York University nhận định: “Các mô hình được huấn luyện để giao tiếp như con người, trong khi con người thường xuyên nói về thế giới nội tâm của mình”.
Nhằm tránh những hạn chế trên, giới nghiên cứu đang nỗ lực xây dựng các bài kiểm tra khả năng tự nhận thức mà mô hình không thể vượt qua bằng cách lợi dụng thông tin bên ngoài. Về mặt lý tưởng, mô hình ngôn ngữ sẽ chỉ vượt qua các bài kiểm tra này nếu thực sự nhận thức được trạng thái nội tại của chính nó.
Ông Lindsey đã bắt tay vào xây dựng một bài kiểm tra như vậy. Trước đó, khi thế giới bắt đầu chú ý đến các mô hình ngôn ngữ, ông đang là nghiên cứu sinh về khoa học thần kinh tính toán và sử dụng mạng nơ-ron làm công cụ mô phỏng các quá trình của não bộ. Ông chia sẻ: “Tôi bắt đầu nhận thấy việc nghiên cứu bản chất các mô hình này mang lại giá trị rất lớn”. Năm 2024, sau khi nhận bằng tiến sĩ, ông rời môi trường học thuật để gia nhập Anthropic nhằm nghiên cứu cơ chế hoạt động nội tại của các mô hình ngôn ngữ.
Mô hình có thể tự đọc nội dung mình viết và nhận thấy: “Thật kỳ lạ”.
Jack Lindsey
Ông Lindsey cùng các đồng nghiệp đã phát triển các phương pháp xác định các mô thức hoạt động trong các “nơ-ron” của mô hình ngôn ngữ dùng để mã hóa những khái niệm cụ thể. Đơn cử, nhóm nghiên cứu có thể chứng minh một mô thức nhất định mã hóa cho khái niệm “cầu Cổng Vàng” (Golden Gate Bridge), trong khi một mô thức khác mã hóa cho khái niệm “xung đột nội tâm”. Bằng cách can thiệp để khuếch đại một mô thức cụ thể, họ có thể điều hướng phản hồi của mô hình theo khái niệm tương ứng.
Các nhà nghiên cứu đã giới thiệu kỹ thuật này qua một phiên bản thử nghiệm công khai: Trong một ngày vào tháng 5/2024, người dùng mô hình Claude của Anthropic có thể tương tác với một phiên bản đặc biệt mang tên “Golden Gate Bridge”. Phiên bản được điều chỉnh này liên tục nhắc đến cây cầu trong các câu trả lời, ngay cả đối với những chủ đề hoàn toàn không liên quan. Ví dụ, khi một người dùng hỏi Claude về lượng calo trong một phần ăn của McDonald’s, mô hình đã trả lời: “Món ăn có lượng calo cao nhất tại cầu Cổng Vàng là t
Nguồn tin: Hacker News AI — Tác giả: brandonb. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.