
Netflix coi độ tin cậy của GPU là bài toán hệ thống phân tán
Netflix đã công bố chi tiết về phương thức xây dựng nền tảng bảo đảm độ tin cậy cho quá trình huấn luyện (training) và suy luận (inference) trên các hệ thống GPU quy mô lớn, thông qua việc ứng dụng các lớp kiểm tra tình trạng vận hành, cơ chế tự động khắc phục sự cố và quy trình huấn luyện có khả năng chịu lỗi nhằm duy trì hoạt động liên tục của các tác vụ ngay cả khi xảy ra lỗi phần cứng. Theo Craig Risi
Trang chủ InfoQ
Tin tức
Netflix coi độ tin cậy của GPU là bài toán hệ thống phân tán
DevOps
Netflix coi độ tin cậy của GPU là bài toán hệ thống phân tán
Ngày 30/10/2026
3
phút đọc
Tác giả
Craig Risi
Theo dõi chúng tôi trên
YouTube 232.000 người theo dõi
LinkedIn 26.000 người theo dõi
Instagram Mới
RSS 19.000 độc giả
X 57.100 người theo dõi
Facebook 21.000 lượt thích
Bluesky Mới
Nghe bài viết này - 0:00
Âm thanh đã sẵn sàng phát
Trình duyệt của bạn không hỗ trợ phần tử âm thanh.
0:00
0:00
Chuẩn 1,25x 1,5x
Thích
Danh sách đọc
Netflix đã công bố chi tiết phương thức xây dựng nền tảng bảo đảm độ tin cậy cho hoạt động huấn luyện và suy luận GPU quy mô lớn, thông qua việc sử dụng các lớp kiểm tra tình trạng, khắc phục sự cố tự động và huấn luyện chịu lỗi nhằm duy trì các tác vụ vận hành liên tục trước các sự cố phần cứng.
Vấn đề này đặc biệt nghiêm trọng đối với các tác vụ huấn luyện AI quy mô lớn. Một mô hình có thể phải vận hành trong nhiều tuần trên hàng trăm GPU, trong đó toàn bộ các đơn vị xử lý đều phải hoạt động đồng bộ. Do đó, chỉ một GPU bị lỗi, một bộ điều hợp mạng bị suy giảm hiệu năng hoặc một máy chủ chạy chậm cũng có thể làm đình trệ hoặc làm chậm đáng kể toàn bộ khối lượng công việc. Netflix đã xây dựng nền tảng tính toán GPU trên Kubernetes, được thiết kế để phát hiện các lỗi này, tự động loại bỏ các tài nguyên không đạt yêu cầu và cho phép các tác vụ kéo dài phục hồi sau khi mất máy chủ.
Phương pháp tiếp cận này đã mang lại kết quả rõ rệt: Netflix ghi nhận mức độ sẵn sàng của các nút GPU đạt hơn 99,95% và tỷ lệ hoàn thành tác vụ tăng từ khoảng 98% lên hơn 99,5%.
Các biện pháp kiểm tra tình trạng thông thường trên đám mây có thể xác nhận máy ảo đang hoạt động và có thể kết nối, nhưng điều đó không đồng nghĩa với việc các GPU của máy ảo có đủ khả năng thực hiện khối lượng công việc huấn luyện phân tán.
Netflix nhận thấy một GPU có thể phản hồi bình thường trước lệnh truy vấn trạng thái, nhưng lại gặp lỗi ngay khi bộ nhớ được phân bổ hoặc khi quá trình tính toán liên tục bắt đầu. Tương tự, một bộ điều hợp mạng có thể vẫn tồn tại nhưng lại có ít liên kết kết nối hơn dự kiến, khiến các hoạt động phối hợp chung tiếp tục diễn ra với băng thông bị suy giảm nghiêm trọng.
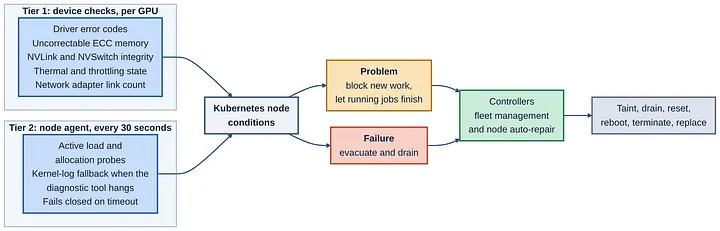
Hoạt động kiểm tra ở cấp độ thiết bị sử dụng NVIDIA DCGM để giám sát các lỗi GPU, bộ nhớ, kết nối liên thông và điều kiện nhiệt độ; trong khi các quy trình kiểm tra mạng đánh giá trạng thái và số lượng giao diện Elastic Fabric Adapter tốc độ cao. Tác tử nút (node agent) của Kubernetes sẽ chuyển đổi các kết quả này thành các điều kiện nút để các bộ điều khiển xử lý.
Các quy trình kiểm tra được thiết kế chủ đích theo cơ chế đóng khi gặp sự cố (fail closed). Trường hợp công cụ chẩn đoán bị treo, tính năng hết thời gian chờ (timeout) sẽ đánh dấu máy chủ ở trạng thái không ổn định, thay vì để một lượt kiểm tra bị lỗi báo cáo thành công. Netflix cũng duy trì các phương án dự phòng bằng cách sử dụng nhật ký nhân (kernel logs) khi chính cơ chế chẩn đoán GPU thông thường gặp sự cố.
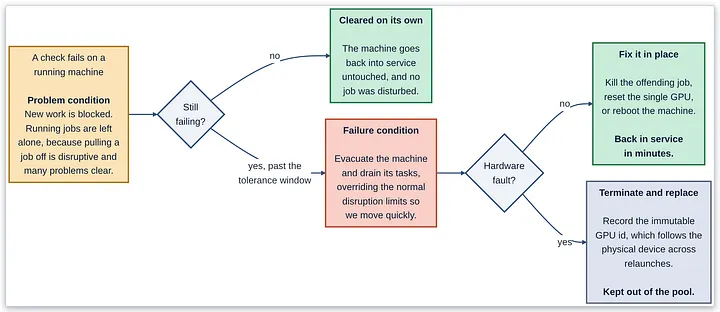
Phát hiện lỗi chỉ là một nửa vấn đề. Netflix đã phát triển các bộ điều khiển có khả năng phản ứng theo từng cấp độ đối với các sự cố, thay vì ngay lập tức thay thế toàn bộ máy chủ.
Một sự cố tạm thời ban đầu có thể ngăn tiếp nhận các tác vụ mới nhưng vẫn cho phép các khối lượng công việc hiện có tiếp tục vận hành. Nếu tình trạng này kéo dài, máy chủ sẽ bị giải phóng (drain) và các khối lượng công việc được điều chuyển. Tùy thuộc vào mức độ sự cố, biện pháp khắc phục có thể gồm việc hủy tác vụ lỗi, thiết lập lại GPU, cho đến việc khởi động lại hoặc thay thế toàn bộ máy chủ.
Phương pháp này tích hợp với tính năng tự sửa lỗi nút của Karpenter, đồng thời Netflix bổ sung các chính sách nhằm xác định thời gian chấp nhận từng loại sự cố và giới hạn tỷ lệ gián đoạn tối đa của cụm máy chủ trong cùng một thời điểm.
Netflix cũng thừa nhận không thể loại bỏ hoàn toàn các sự cố phần cứng. Thay vào đó, nền tảng huấn luyện của đơn vị này giúp giảm thiểu chi phí phục hồi.
Các tác vụ lớn áp dụng cơ chế lưu điểm kiểm tra (checkpointing) và sử dụng các tiến trình linh hoạt (elastic workers), cho phép quá trình huấn luyện tiếp tục từ điểm kiểm tra ổn định gần nhất khi một máy chủ gặp sự cố. Sau đó, nền tảng có thể tự động chạy lại các tác vụ lỗi, trong khi các sự cố từ ứng dụng được phân loại riêng nhằm tránh việc khởi động lại liên tục các tác vụ vốn có lỗi phần mềm.
Netflix cũng coi bản thân tác vụ huấn luyện là một hệ thống phân tán. Thay vì chỉ tìm kiếm các máy chủ bị hỏng, hệ thống có thể nhận diện một tiến trình đơn lẻ (rank) xử lý chậm đang cản trở tiến độ chung. Điều này có ý nghĩa quan trọng, bởi một GPU không nhất thiết phải hỏng hoàn toàn mới làm suy giảm thông lượng của một khối lượng công việc đồng bộ.
Netflix cũng đang ứng dụng các tính năng Multi-Instance GPU (MIG) của NVIDIA nhằm cho phép các khối lượng công việc suy luận quy mô nhỏ hơn chia sẻ GPU, trong khi vẫn duy trì sự cô lập ở cấp độ bộ nhớ giữa các đối tượng sử dụng.
Giải pháp này giúp cải thiện hiệu suất sử dụng so với việc phân bổ riêng toàn bộ một GPU cho từng khối lượng công việc. Netflix cũng đang hướng tới cơ chế Dynamic Resource Allocation (DRA) của Kubernetes; cơ chế này cho phép các yêu cầu tài nguyên được biểu đạt linh hoạt hơn và phân bổ vị trí tối ưu theo cấu trúc liên kết phần cứng, bao gồm việc bảo đảm GPU, bộ điều hợp mạng và CPU được định vị phù hợp bên trong máy chủ.
Meta cũng áp dụng quy trình chẩn đoán phần cứng toàn diện, khắc phục sự cố tự động, thiết lập điểm kiểm tra và phục hồi nhanh. Hoạt động gần đây của doanh nghiệp này tập trung mạnh vào việc phát hiện các lỗi phần cứng, bao gồm lỗi sai hỏng dữ liệu thầm lặng (SDC) phức tạp, trên các cụm tính toán AI quy mô đặc biệt lớn. Meta cho biết các sự cố phần cứng chiếm hơn 66% tổng số lần gián đoạn quá trình huấn luyện trong dự án Llama 3.
Kiến trúc của Netflix đặc biệt chú trọng việc khép kín chu trình vận hành: kiểm tra phần cứng trước khi điều phối, giám sát trong quá trình thực thi, xác định phạm vi xảy ra lỗi, khắc phục tự động và đo lường thông lượng hữu ích đạt được. Trong khi đó, Meta đầu tư mạnh vào phát hiện lỗi ở cấp độ phần cứng, công tác bảo trì cụm tính toán cũng như hoạt động phục hồi hệ thống.
Cả hai phương pháp tiếp cận đều phản ánh một thực tế cốt lõi: khi hệ thống đạt quy mô hàng nghìn GPU, việc bảo đảm độ tin cậy không còn đơn thuần là duy trì trạng thái sẵn sàng hoạt động của từng máy chủ riêng lẻ.
Về tác giả
Craig Risi
Xem thêmThu gọn
Nguồn tin: InfoQ AI — Tác giả: Craig Risi. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.