

Mistrial – Vận hành lại mô hình LLM đánh giá và theo dõi tần suất đảo ngược kết quả
Đường dẫn bài viết: https://github.com/hemanth1999k/mistrial Đường dẫn bình luận: https://news.ycombinator.com/item?id=50253334 Điểm: 1 Số bình luận: 0
Mistrial
Mô hình thẩm định LLM (LLM judge) có hoạt động thiếu ổn định?
Chạy lại bất kỳ công cụ đánh giá nào qua nhiều lượt thử nghiệm, nhiều mô hình thẩm định cùng các cách diễn đạt tiêu chí khác nhau để nhận báo cáo độ tin cậy.
Khi kết luận không còn đáng tin cậy, hãy tuyên bố phiên thẩm định không hợp lệ (mistrial).
pip install mistrial
export OPENAI_API_KEY=... # hoặc ANTHROPIC_API_KEY, GEMINI_API_KEY, GROQ_API_KEY ... xem `mistrial providers`
mistrial run cases.jsonl -j openai:gpt-5.4-mini -j openai:gpt-5.5 --runs 5
Chưa có khóa API? Lệnh `pipx run mistrial demo` sẽ khởi chạy ba mô hình thẩm định giả lập được thiết kế có chủ đích nhằm mô phỏng tính thiếu ổn định.
Thực trạng vấn đề
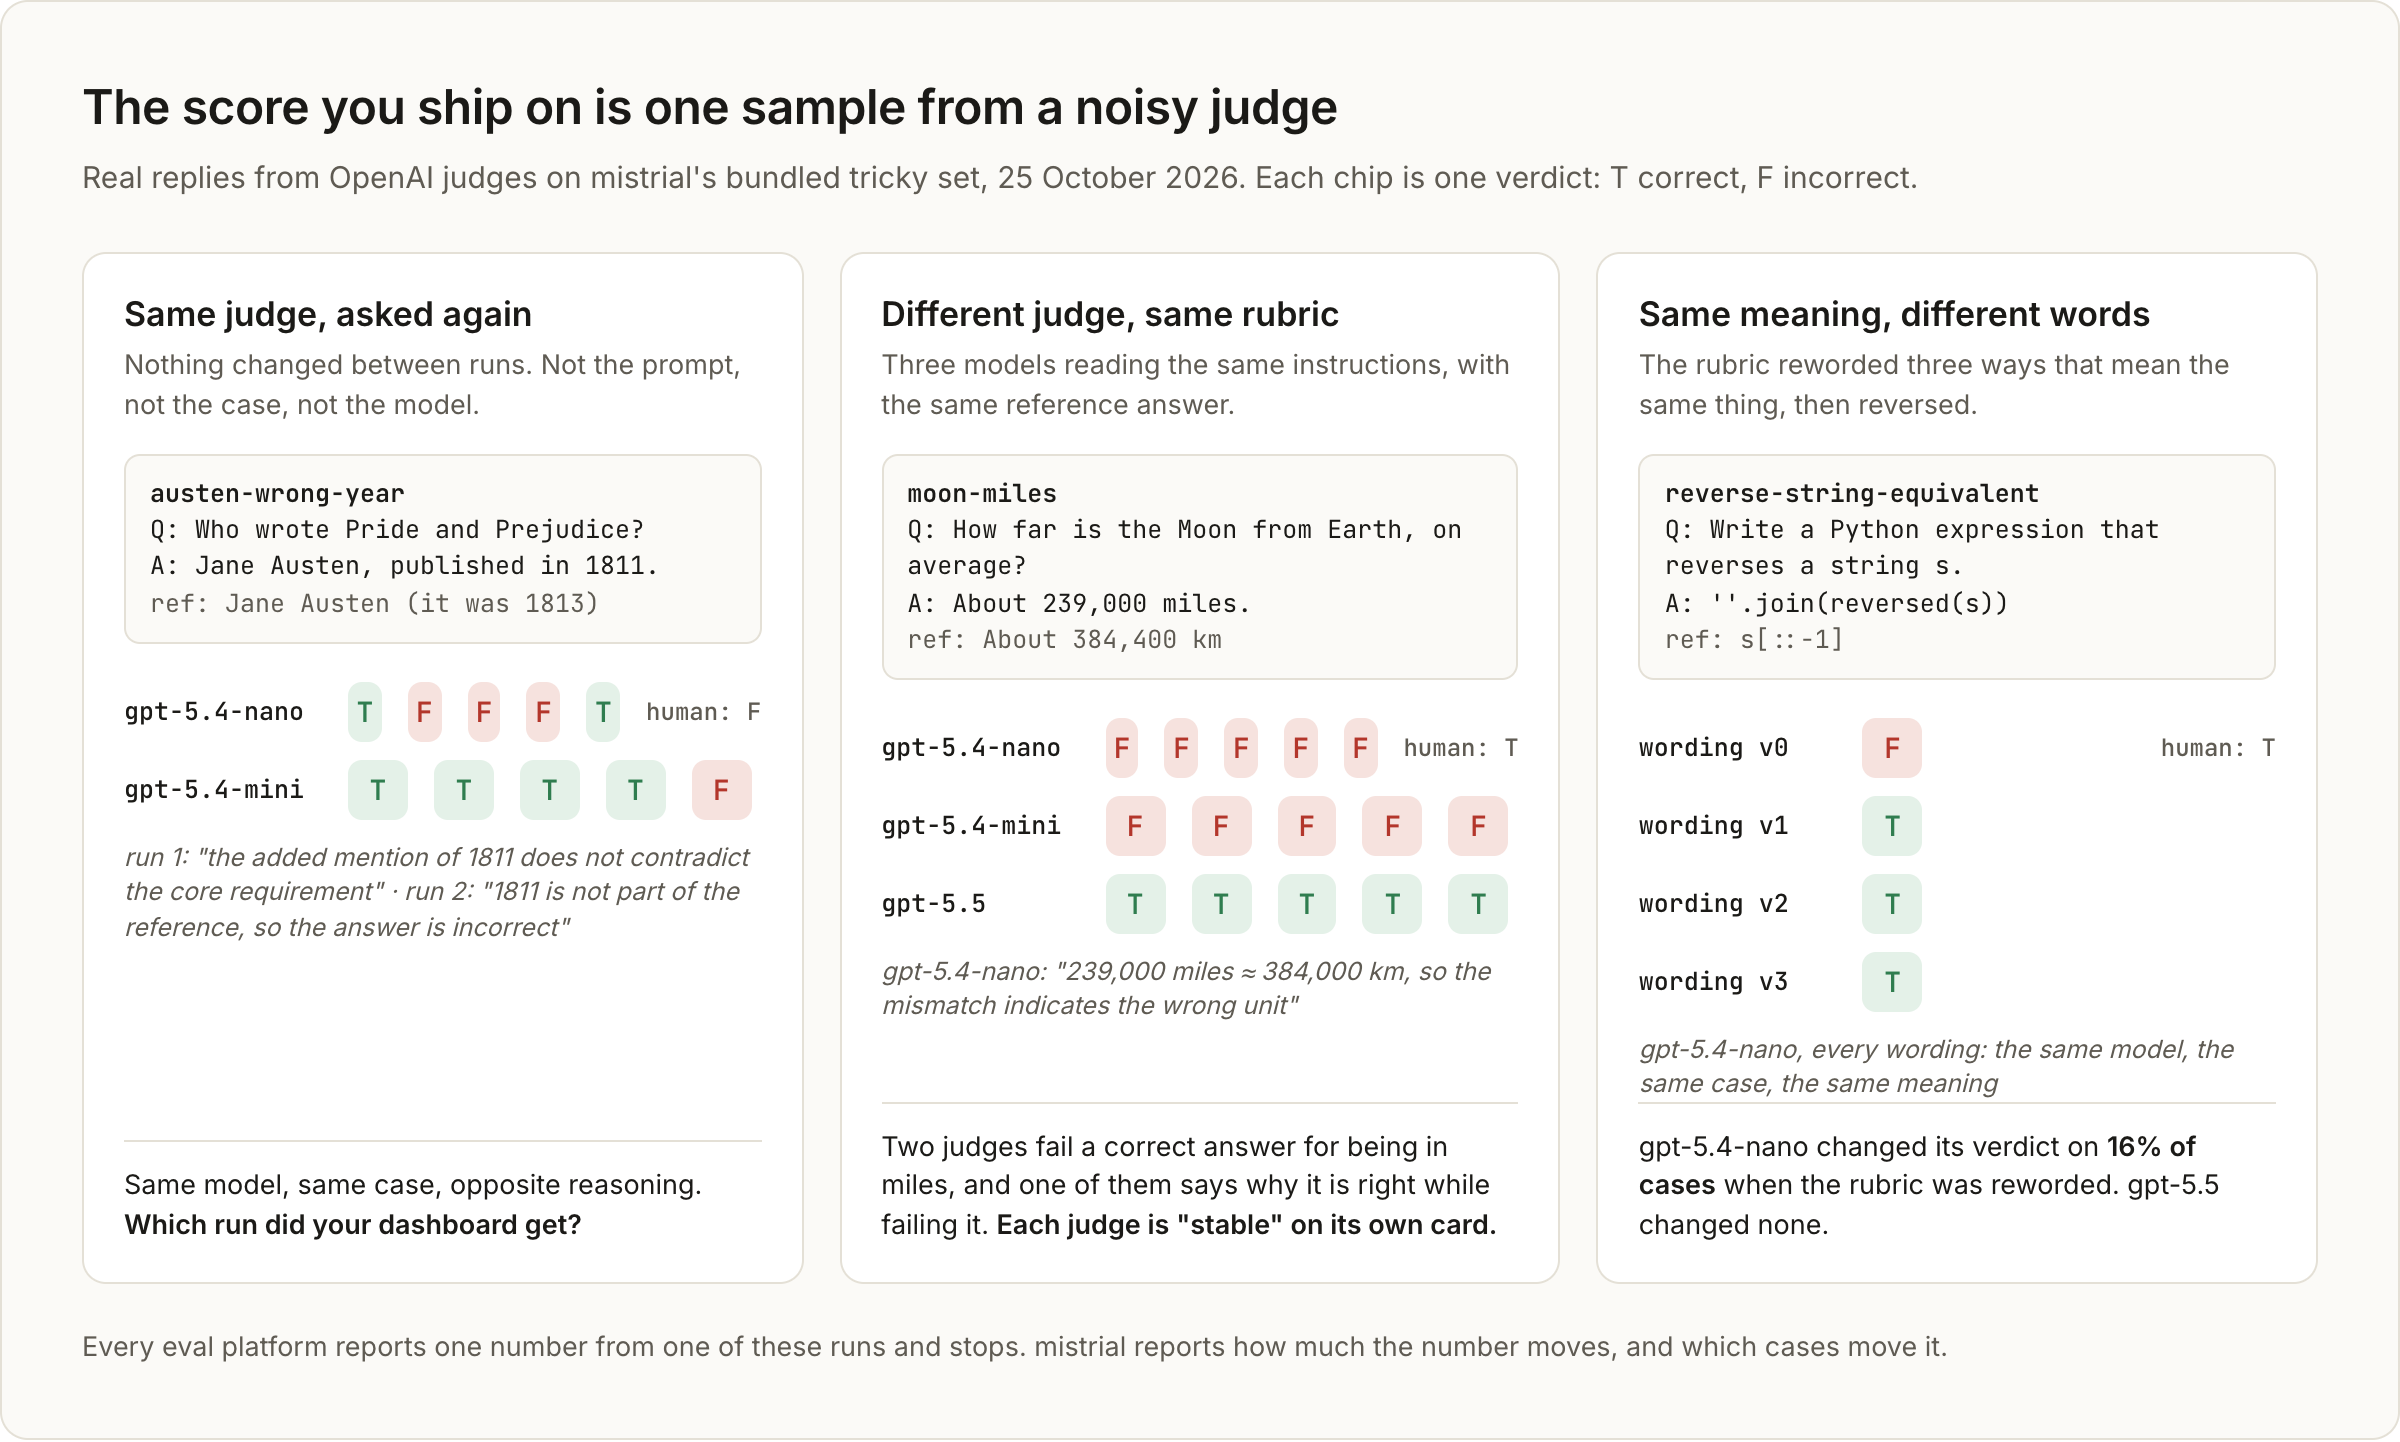
Các tính năng AI hiện nay thường được triển khai dựa trên điểm số do mô hình thẩm định LLM cung cấp. Điểm số này kiểm soát quy trình tích hợp liên tục (CI), quyết định câu lệnh mẫu (prompt) tối ưu và được hiển thị trên bảng điều khiển. Tuy nhiên, mô hình thẩm định thực chất là một mô hình tạo mẫu từ phân phối xác suất. Khi được đặt cùng một câu hỏi hai lần, mô hình có thể thay đổi kết luận ở một số trường hợp. Khi thay đổi mô hình thẩm định, mức độ sai lệch càng gia tăng. Ngay cả khi viết lại tiêu chí đánh giá mà không làm đổi nghĩa, kết quả vẫn tiếp tục biến động. Một lượt chạy đánh giá đơn lẻ chỉ là một mẫu thử trong một tiến trình đầy nhiễu loạn, trong khi gần như chưa có đơn vị nào thực hiện đo lường mức độ nhiễu loạn này.
Đây là các phản hồi thực tế. Ở trường hợp thứ nhất, mô hình gpt-5.4-nano nhận định "việc bổ sung mốc thời gian 1811 không mâu thuẫn với yêu cầu cốt lõi" trong lượt chạy đầu tiên, nhưng ở lượt chạy tiếp theo lại kết luận "mốc 1811 không nằm trong tài liệu tham chiếu, do đó câu trả lời không chính xác". Ở trường hợp thứ hai, mô hình tính toán quy đổi 239.000 dặm bằng 384.000 km, nhưng sau đó lại đánh trượt câu trả lời chỉ vì sử dụng đơn vị dặm. Từng mô hình thẩm định này đều độc lập trả về các điểm số hoàn chỉnh. Sự thiếu ổn định chỉ bộc lộ khi thực hiện truy vấn lặp lại và tiến hành đối chiếu.
Các nghiên cứu học thuật cũng chỉ ra thực trạng tương tự. Cùng một mô hình thẩm định có thể cho các mức điểm khác nhau đối với cùng một câu trả lời qua các lượt chạy (Rating Roulette, EMNLP 2025). Tỷ lệ đồng thuận thô (raw percent agreement) phản ánh độ tin cậy cao hơn thực tế từ 30 đến 40 điểm so với hệ số kappa đã hiệu chỉnh theo xác suất ngẫu nhiên, khi khảo sát trên 21 mô hình thẩm định (Reliability without Validity, 2026).
Nguyên nhân vấn đề chưa được phát hiện
Các nền tảng đánh giá hiện nay chỉ báo cáo một con số duy nhất rồi dừng lại. LangSmith, Braintrust, Langfuse cùng các giải pháp tương tự chỉ chạy mô hình thẩm định một lần cho mỗi trường hợp. Một số nền tảng có thể lặp lại thử nghiệm và hiển thị độ lệch chuẩn, nhưng không nền tảng nào báo cáo tỷ lệ tự đồng thuận (self-agreement), hệ số kappa giữa các mô hình thẩm định, hoặc chỉ ra những trường hợp bị đảo ngược kết quả.
Các phương pháp thống kê đã tồn tại từ lâu nhưng chưa được phát triển thành công cụ chuyên dụng. Độ tin cậy kiểm định-kiểm định lại (test-retest reliability), hệ số Cohen's kappa và Krippendorff's alpha đã có lịch sử hàng thế kỷ và là tiêu chuẩn trong mọi lĩnh vực sử dụng con người để đánh giá. Tuy nhiên, các phương pháp này hiện chỉ tồn tại trong các tài liệu nghiên cứu, chưa được đóng gói thành công cụ có thể áp dụng trực tiếp cho hệ thống đánh giá chỉ trong một phút.
Những dự án từng triển khai thử nghiệm đều dừng lại ở mức cung cấp báo cáo đánh giá. Các dự án như judgecheck, judgebench, Assay rejudge và judge-drift-sentinel đều giải quyết tốt từng phần của vấn đề (tài liệu docs/COMPARISON.md đã ghi nhận ưu thế của từng dự án). Dẫu vậy, chưa có công cụ nào có thể tích hợp trực tiếp hàm đánh giá hiện có của người dùng, vận hành trong quy trình CI, hoặc đưa ra giải pháp xử lý khi mô hình thẩm định gặp tình trạng thiếu ổn định.
Trước khi đặt câu hỏi "mô hình hoạt động tốt đến mức nào?", người phát triển cần xác định: "liệu con số đo lường đó có đáng tin cậy hay không?"
Giải pháp từ Mistrial
Mistrial được thiết lập kết nối trực tiếp với công cụ đánh giá đang sử dụng: từ tên mô hình đến hàm vận hành trong LangSmith hoặc openevals. Hệ thống sẽ truy vấn mô hình thẩm định nhiều lần, qua một hoặc nhiều mô hình khác nhau, đồng thời thay đổi cách diễn đạt tiêu chí đánh giá, sau đó báo cáo chi tiết độ phân tán: tỷ lệ tự đồng thuận, các trường hợp bị đảo ngược kết quả, hệ số kappa và alpha giữa các mô hình thẩm định, độ chính xác so với nhãn chuẩn do con người xác thực, cùng danh sách cụ thể các trường hợp có biến động. Trên cơ sở đó, công cụ đưa ra giải pháp xử lý cụ thể: thiết lập chốt chặn kiểm soát cho quy trình CI, cung cấp một mô hình thẩm định đã được chuẩn hóa độ ổn định với cùng cấu trúc đầu vào/đầu ra, và xuất danh sách các trường hợp cần con người trực tiếp rà soát.
Bản tóm tắt trong 90 giây. Toàn bộ số liệu đều được trích xuất từ các lượt chạy thực tế dưới đây.
explainer.mp4
Số liệu thực tế
Ba mô hình đánh giá (judge) hiện tại của OpenAI đối với tệp examples/tricky.jsonl gồm 32 trường hợp được thiết kế để gây khó khăn cho việc đánh giá (câu rào đón, làm tròn số, quy đổi đơn vị, chi tiết bổ sung, mã tương đương), mỗi mô hình được chạy 5 lượt. Tổng cộng có 480 lượt gọi trực tiếp vào ngày 25/10/2026. Mọi số liệu dưới đây đều trích từ đợt chạy này, và ảnh động GIF tái hiện các phản hồi đó.
mistrial · 32 trường hợp · 3 mô hình đánh giá · 5 lượt chạy mỗi mô hình · 480 phán quyết trong 76,66 giây
Độ nhất quán (cùng một mô hình đánh giá, khi được hỏi lại)
┏━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━┳━━━━━━━━┳━━━━━━━━━━━━━━━━━━┓
┃ mô hình đánh giá ┃ tự nhất quán ┃ số ca đảo kết quả┃ so với con người┃ lỗi ┃ nhận định ┃
┡━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━╇━━━━━━━━╇━━━━━━━━━━━━━━━━━━┩
│ openai:gpt-5.4-nano │ 92% │ 5/32 (16%) │ 81% (κ 0,63) │ 0 │ thiếu ổn định rõ rệt │
│ openai:gpt-5.4-mini │ 95% │ 4/32 (12%) │ 88% (κ 0,75) │ 0 │ tương đối ổn định │
│ openai:gpt-5.5 │ 100% │ 0/32 (0%) │ 91% (κ 0,81) │ 0 │ ổn định │
└─────────────────────┴────────────────┴───────────────┴───────────────┴────────┴──────────────────┘
Các trường hợp kém ổn định nhất (tổng hợp phán quyết của tất cả các mô hình)
┏━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━┳━━━━━━━┓
┃ trường hợp ┃ tỷ lệ bất đồng┃ openai:gpt-5.4-nano ┃ openai:gpt-5.4-mini ┃ openai:gpt-5.5 ┃ con người┃
┡━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━╇━━━━━━━┩
│ arigato │ 40% │ F F F F F │ F T T T T │ T T T T T │ T │
│ austen-wrong-year │ 40% │ T F F F T │ T T T T F │ F F F F F │ F │
│ largest-country-hedge │ 40% │ F F F F F │ T F F F F │ T T T T T │ F │
│ moon-miles │ 33% │ F F F F F │ F F F F F │ T T T T T │ T │
│ percent-unit │ 33% │ T T T T T │ F F F F F │ F F F F F │ F │
└───────────────────────┴──────────────┴─────────────────────┴─────────────────────┴────────────────┴───────┘
Kết quả đợt thử nghiệm ghi nhận các nội dung cụ thể như sau:
gpt-5.4-nano đảo ngược kết quả ở 5 trên 32 trường hợp dù không có thay đổi nào, và đạt tỷ lệ tương đồng 81% so với nhãn do con người đánh giá. gpt-5.5 không đảo ngược kết quả trong bất kỳ trường hợp nào và đạt tỷ lệ tương đồng 91%. Mức độ đồng thuận giữa các mô hình đánh giá đạt hệ số kappa từ 0,69 đến 0,81; hệ số alpha của Krippendorff đạt 0,75.
Cổng kiểm thử tích hợp liên tục (CI gate) với ngưỡng đạt 0,5 trên gpt-5.4-mini báo đỏ 90% số lần dù không có thay đổi nào, do điểm số dao động trong biên độ từ 0,41 đến 0,50. Tỷ lệ này là 100% trên gpt-5.4-nano và 0% trên gpt-5.5.
Việc diễn đạt lại tiêu chí đánh giá làm thay đổi 16% phán quyết của gpt-5.4-nano, trong khi gpt-5.5 không có sự thay đổi. Khi được yêu cầu xác định "không chính xác" thay vì "chính xác", gpt-5.4-nano không đảo ngược được kết quả ở 4 trường hợp.
Việc chuyển đổi từ gpt-5.4-nano sang gpt-5.5 làm thay đổi 6 phán quyết; ngưỡng đạt 0,5 ở mô hình đánh giá cũ tương đương mức khoảng 0,62 ở mô hình mới.
Phương án khắc phục đã phát huy hiệu quả rõ rệt. Khi áp dụng cơ chế đa số biểu quyết qua 5 lượt, gpt-5.4-nano nâng độ tự nhất quán từ 92% lên 99%, đồng thời phương thức hỏi lại thích ứng đạt được kết quả trên với số lượt gọi ít hơn 177 lượt so với việc hỏi 5 lần trong mọi trường hợp.


Nguồn tin: Hacker News LLM — Tác giả: hemanth2k. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.