
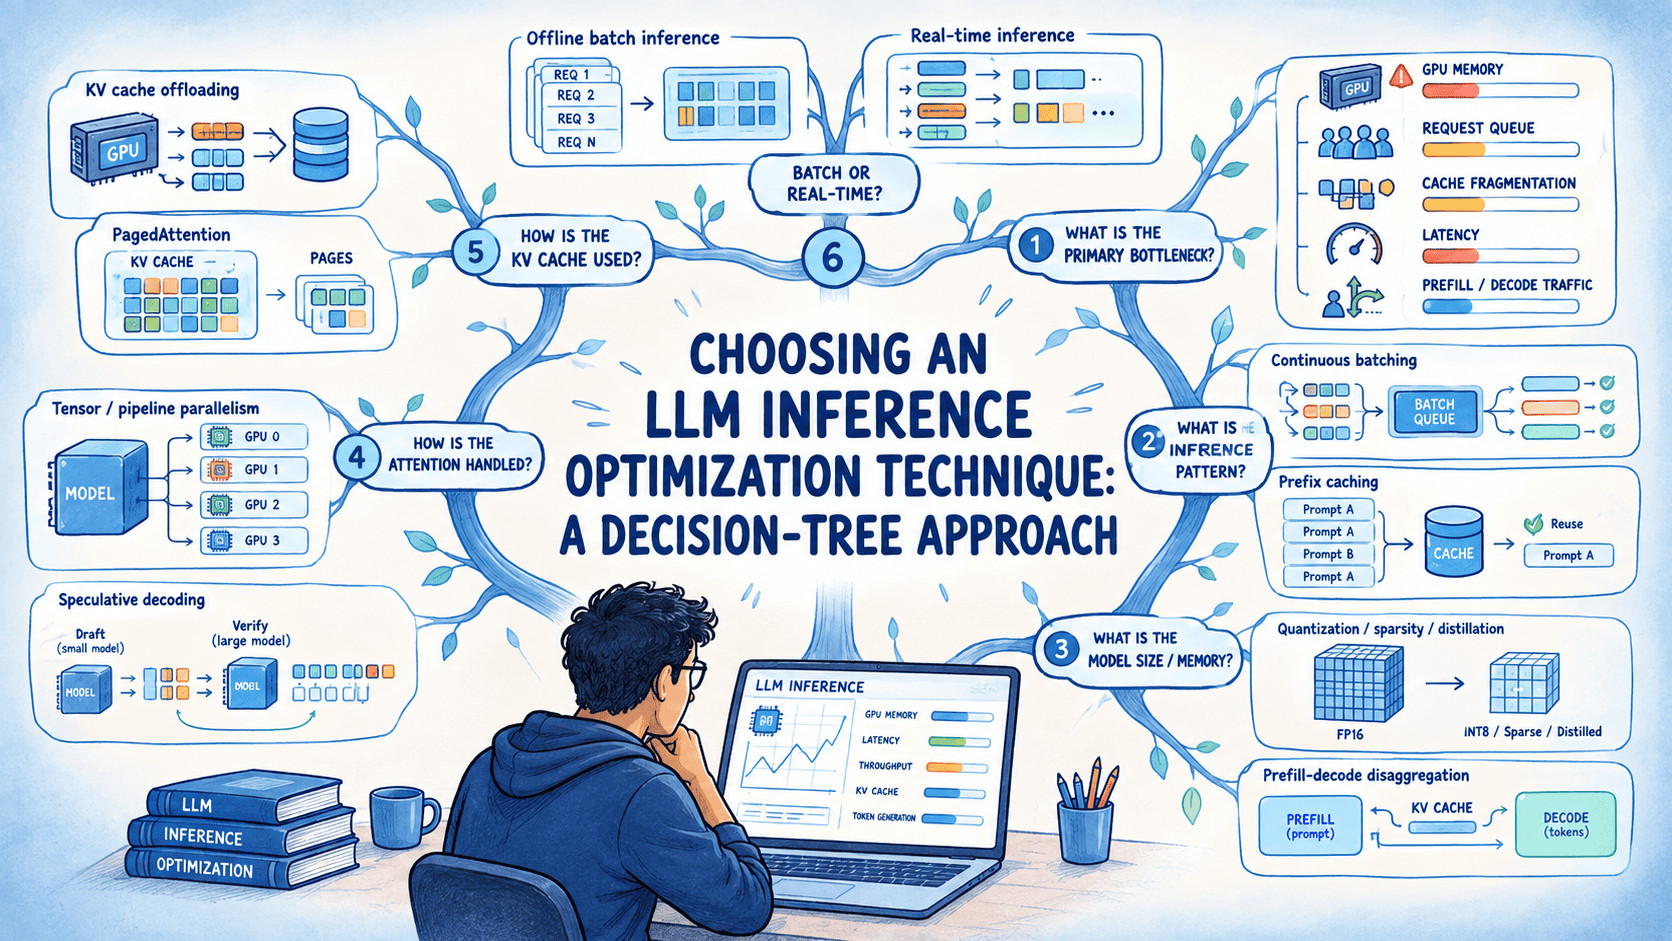
Lựa chọn kỹ thuật tối ưu hóa suy luận LLM: Phương pháp tiếp cận theo cây quyết định
Bài viết này trình bày phương pháp lựa chọn kỹ thuật tối ưu hóa suy luận LLM phù hợp với điểm nghẽn thực tế trong khối lượng công việc, thông qua việc xử lý một...
Lựa chọn kỹ thuật tối ưu hóa suy luận LLM: Phương pháp tiếp cận theo cây quyết định
Tác giả: Bala Priya C, ngày 3/11/2026, mục Language Models 0
Chia sẻ
Đăng bài
Chia sẻ
Bài viết này phân tích phương pháp đối chiếu kỹ thuật tối ưu hóa suy luận LLM với điểm nghẽn thực tế của khối lượng công việc, thông qua cây quyết định gồm sáu câu hỏi.
Các nội dung chính bao gồm:
Bản chất giả định của từng kỹ thuật tối ưu hóa suy luận chủ chốt đối với khối lượng công việc, từ lượng tử hóa (quantization) đến phân tách nạp trước - giải mã (prefill-decode disaggregation).
Phương pháp vận dụng cây quyết định nhằm định hướng tới kỹ thuật phù hợp dựa trên mô hình và lưu lượng truy cập.
So sánh các yếu tố đánh đổi giữa các kỹ thuật, cùng những dấu hiệu cho thấy kỹ thuật đã chọn không đạt hiệu quả.
Đặt vấn đề
Quá trình suy luận LLM trở nên chậm và tốn kém khi lưu lượng truy cập gia tăng. Các yêu cầu phải xếp hàng chờ đợi các lượt tạo chuỗi dài, bộ nhớ GPU bị lấp đầy bởi trạng thái attention lưu trong bộ nhớ đệm, trong khi phần cứng mất phần lớn thời gian chờ đọc dữ liệu từ bộ nhớ.
Tối ưu hóa suy luận là tập hợp các giải pháp kỹ thuật nhằm giải quyết vấn đề này. Một số kỹ thuật tập trung vào bộ nhớ, số khác nhắm vào năng lực tính toán hoặc phương thức điều phối các yêu cầu. Mỗi kỹ thuật đều dựa trên những giả định cụ thể về khối lượng công việc; do đó, quyết định chính xác phụ thuộc vào việc các giả định đó có phù hợp với thực tế hay không. Bài viết tập trung vào các nội dung:
Những giả định của từng kỹ thuật tối ưu hóa suy luận chủ chốt về khối lượng công việc
Cây quyết định định hướng lựa chọn kỹ thuật
So sánh các kỹ thuật về độ trễ, thông lượng và chi phí triển khai
Các dấu hiệu cho thấy kỹ thuật không phát huy hiệu quả
Nội dung trước hết tập trung vào các giả định của từng kỹ thuật.
Giả định của từng kỹ thuật tối ưu hóa suy luận
Quá trình suy luận LLM có nhiều kỹ thuật tối ưu hóa, nhưng mỗi kỹ thuật giải quyết một dạng điểm nghẽn khác nhau. Trước khi áp dụng, cần nắm rõ đặc thù khối lượng công việc mà kỹ thuật đó hướng tới.
Kỹ thuật
Giả định về khối lượng công việc
Lượng tử hóa / độ thưa / chưng cất (Quantization / sparsity / distillation)
Bản thân mô hình quá lớn so với phần cứng hoặc giới hạn độ trễ cho phép; việc thu nhỏ kích thước mô hình chấp nhận rủi ro suy giảm một phần độ chính xác
Lưu trữ tiền tố vào bộ nhớ đệm (Prefix caching)
Nhiều yêu cầu có chung chuỗi token khởi đầu giống nhau, do đó việc tính toán lại tiền tố này gây lãng phí tài nguyên
Xử lý theo lô liên tục (Continuous / in-flight batching)
Các yêu cầu gửi đến đồng thời với độ dài đầu ra khó dự đoán; việc chờ đợi yêu cầu chậm nhất trong một lượt xử lý sẽ gây lãng phí năng lực GPU
PagedAttention
Bộ nhớ đệm KV (KV cache) bị phân mảnh hoặc phân bổ dư thừa, khiến kích thước lô (batch size) bị giới hạn thấp hơn mức phần cứng có thể đáp ứng
Giải mã suy đoán (Speculative decoding)
Giai đoạn giải mã (decode) là điểm nghẽn, các token được tạo tuần tự từng đơn vị một, trong khi một mô hình nháp (draft model) có chi phí thấp hơn có thể dự đoán chính xác đồng thời nhiều token
Phân tách nạp trước - giải mã (Prefill-decode disaggregation)
Giai đoạn nạp trước (prefill) và giải mã (decode) cạnh tranh tài nguyên trên cùng một GPU; sự cạnh tranh này ảnh hưởng tiêu cực đến cả thời gian tạo token đầu tiên lẫn độ trễ giữa các token
Song song hóa tensor / đường ống (Tensor / pipeline parallelism)
Mô hình không vừa bộ nhớ của một thiết bị đơn lẻ, hoặc năng lực tính toán của từng thiết bị chạm ngưỡng trần về thông lượng
Giảm tải bộ nhớ đệm KV (KV cache offloading)
Các dữ liệu đệm hữu ích bị đẩy ra ngoài quá sớm do bộ nhớ GPU không đủ dung lượng lưu trữ toàn bộ dữ liệu cần giữ lại
Suy luận theo lô ngoại tuyến (Offline batch inference)
Các yêu cầu không đòi hỏi phản hồi tương tác theo thời gian thực, và tổng thông lượng được ưu tiên hơn độ trễ của từng yêu cầu
Cần lựa chọn kỹ thuật căn cứ trên điểm nghẽn thực tế của khối lượng công việc nhằm tránh sự phức tạp không cần thiết.
Vận dụng cây quyết định để lựa chọn kỹ thuật
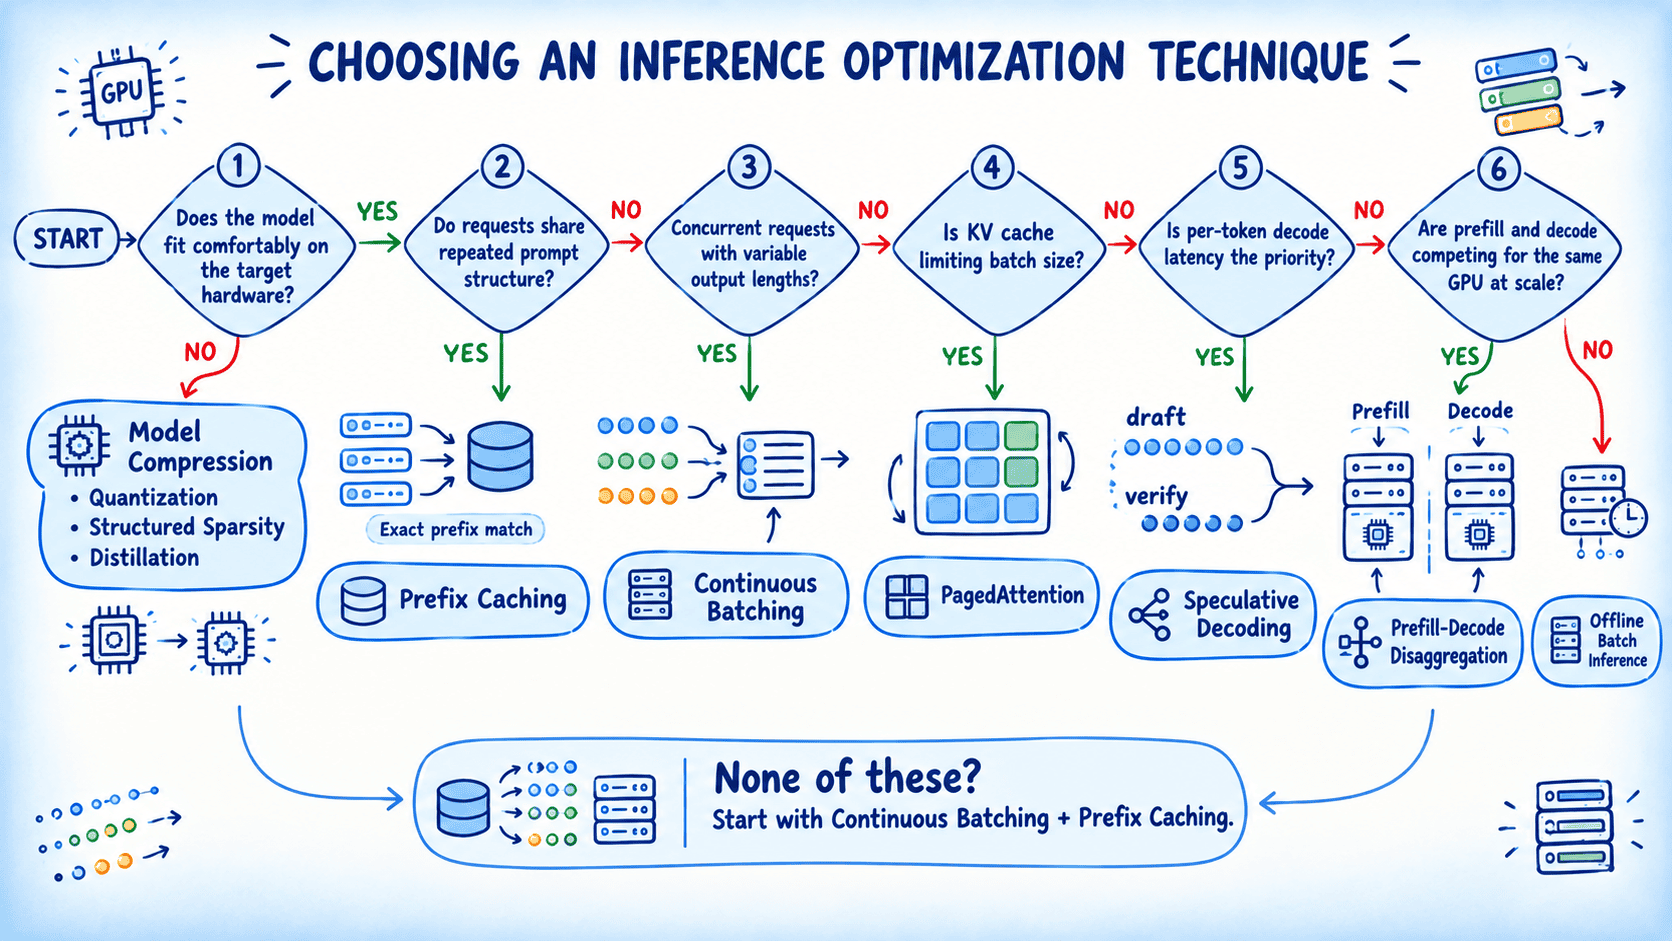
Sơ đồ hình cây dưới đây bao gồm 6 câu hỏi phân nhánh. Mỗi câu hỏi thu hẹp phạm vi lựa chọn dựa trên một đặc tính cụ thể của mô hình hoặc lưu lượng truy cập. Mỗi câu hỏi đều có chung cấu trúc kết thúc: đưa ra câu trả lời trực tiếp nếu điều kiện được thỏa mãn, hoặc dẫn đến câu hỏi tiếp theo nếu điều kiện không thỏa mãn.
Câu hỏi 1: Mô hình có vận hành vừa vặn trên phần cứng mục tiêu hay không?
Trước khi xem xét hạ tầng triển khai dịch vụ (serving stack), cần kiểm tra xem vấn đề có nằm ở chính mô hình hay không. Một mô hình vừa khít với bộ nhớ GPU sẽ gần như không còn không gian cho bộ nhớ đệm KV (KV cache), từ đó giới hạn kích thước lô xử lý (batch size), bất kể bộ lập lịch hoạt động hiệu quả đến mức nào.
Nếu mô hình quá lớn hoặc quá trình suy luận (inference) bị giới hạn bởi năng lực tính toán ngay cả ở kích thước lô bằng 1, cần bắt đầu bằng các phương pháp nén ở cấp độ mô hình:
Lượng tử hóa (Quantization) làm giảm độ chính xác của trọng số và hàm kích hoạt.
Độ thưa có cấu trúc (Structured sparsity) loại bỏ các trọng số ít quan trọng hơn nhằm giảm khối lượng tính toán.
Chưng cất tri thức (Distillation) huấn luyện một mô hình nhỏ hơn để mô phỏng mô hình lớn hơn.
Các kỹ thuật này phần lớn độc lập với hạ tầng triển khai dịch vụ và cần được ưu tiên xem xét trước do quyết định dung lượng phần cứng còn lại.
Nếu mô hình đã vận hành vừa vặn và còn dư tài nguyên, chuyển sang Câu hỏi 2.
Câu hỏi 2: Các yêu cầu gửi đến có dùng chung cấu trúc câu lệnh (prompt) lặp lại hay không?
Các ứng dụng trò chuyện gửi lại toàn bộ lịch sử hội thoại ở mỗi lượt tương tác. Các khung tác nhân (agent frameworks) tái sử dụng cùng một câu lệnh hệ thống (system prompt) qua hàng nghìn lượt gọi. Quy trình tạo sinh tăng cường truy xuất (RAG) thường gắn cùng một chỉ dẫn vào phần đầu của các ngữ cảnh truy xuất khác nhau.
Nếu một tỷ lệ đáng kể trong lưu lượng truy cập có tiền tố giống hệt nhau, dù là câu lệnh hệ thống hay lịch sử trò chuyện đang dài dần, lưu bộ nhớ đệm tiền tố (prefix caching) là kỹ thuật mang lại hiệu quả cao nhất. Phương pháp này bỏ qua việc tính toán lại bộ nhớ đệm KV đối với các token đã được mô hình xử lý, và hiệu quả sẽ tăng theo cấp số nhân khi các cuộc hội thoại kéo dài hơn.
⚠️ Lưu bộ nhớ đệm tiền tố chỉ hoạt động khi phần tiền tố dùng chung trùng khớp chính xác từng ký tự. Cần đặt nội dung ổn định, có thể tái sử dụng ở phần đầu và nội dung biến đổi ở phần cuối câu lệnh.
Nếu các câu lệnh hầu như mang tính độc bản và ít có cấu trúc chung, chuyển sang Câu hỏi 3.
Câu hỏi 3: Các yêu cầu có được gửi đến đồng thời với độ dài đầu ra khác nhau hay không?
Một chatbot hỗ trợ trả lời bằng một câu đơn và một trợ lý lập trình trả về 400 dòng mã hiếm khi hoàn thành cùng lúc, ngay cả khi được bắt đầu đồng thời. Trong cơ chế xử lý theo lô thông thường (naive batching), toàn bộ lô xử lý phải chờ đợi yêu cầu chậm nhất.
Nếu lưu lượng truy cập kết hợp cả phản hồi ngắn lẫn dài và xuất hiện theo từng đợt gối đầu nhau, kỹ thuật xử lý theo lô liên tục (continuous batching) sẽ khắc phục thời gian chờ do sự chênh lệch này gây ra. Các chuỗi đã hoàn thành sẽ rời khỏi lô ngay lập tức, cho phép các yêu cầu mới bắt đầu mà không cần chờ đến mốc hoàn tất của cả lô. Hầu hết các công cụ triển khai dịch vụ đều kích hoạt tính năng này theo mặc định.
Nếu lưu lượng truy cập đã được xử lý theo lô hiệu quả và thời gian GPU nhàn rỗi không còn là vấn đề, chuyển sang
Nguồn tin: Machine Learning Mastery — Tác giả: Bala Priya C. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.