
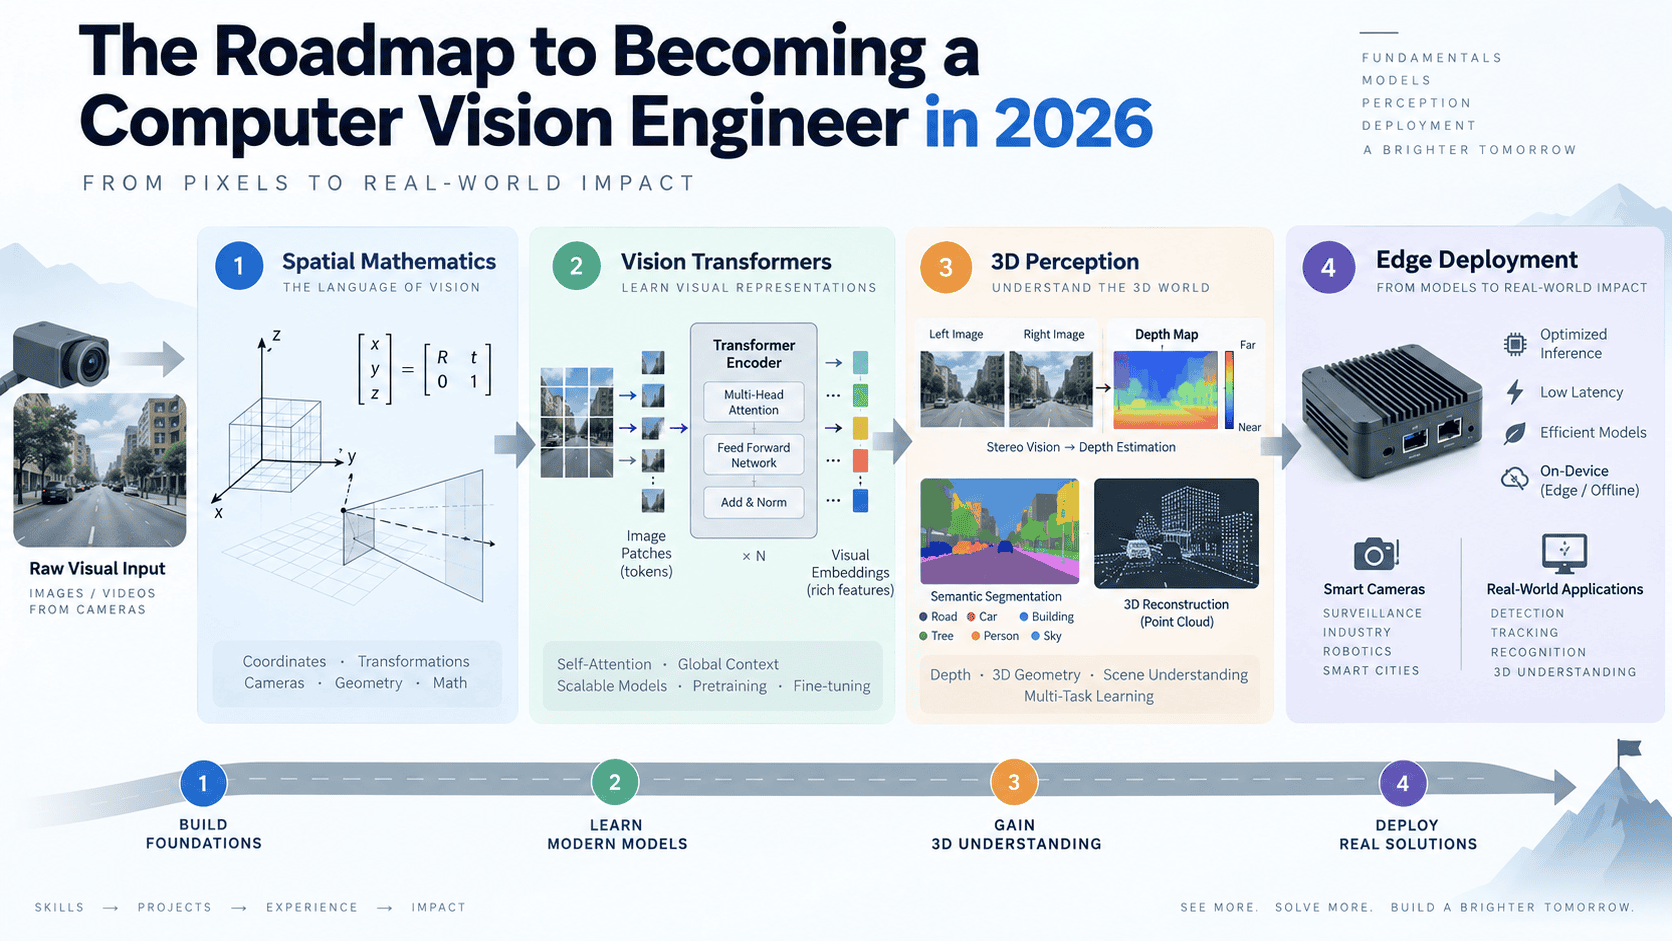
Lộ trình trở thành kỹ sư thị giác máy tính năm 2026
Lộ trình kỹ thuật bốn giai đoạn để trở thành kỹ sư thị giác máy tính, từ toán học không gian và các mô hình ViT đến kỹ thuật kết xuất nơ-ron 3D cùng tối ưu hóa triển khai trên thiết bị biên.
Lộ trình trở thành kỹ sư thị giác máy tính năm 2026 - KDnuggets
Bài viết
Bài viết tiêu biểu
Giới thiệu
Chủ đề
AI
Tư vấn nghề nghiệp
Thị giác máy tính
Kỹ thuật dữ liệu
Khoa học dữ liệu
Mô hình ngôn ngữ
Học máy
MLOps
NLP
Lập trình
Python
SQL
Tập dữ liệu
Sự kiện
Tài nguyên
Tài liệu tra cứu nhanh
Đề xuất
Bản tin công nghệ
Quảng cáo
Đăng ký nhận bản tin
Lộ trình trở thành kỹ sư thị giác máy tính vào năm 2026
Lộ trình kỹ thuật bốn giai đoạn để trở thành kỹ sư thị giác máy tính, từ toán học không gian và ViT đến kết xuất thần kinh 3D cùng tối ưu hóa triển khai tại biên.
Tác giả: Vinod Chugani, ngày 26/10/2026, chuyên mục Trí tuệ nhân tạo
Lĩnh vực thị giác máy tính (CV) đã phát triển vượt xa phạm vi phát hiện vật thể và phân loại hình ảnh. Vào năm 2026, các kỹ sư CV làm việc tại điểm giao thoa giữa các mô hình nền tảng, tính toán không gian và phần cứng nhúng, nhằm xây dựng các hệ thống có khả năng nhận thức, lập luận và tương tác với thế giới trực quan theo thời gian thực.
Nhu cầu đối với các kỹ sư có năng lực vận hành toàn diện quy trình này đang không ngừng gia tăng. Phương tiện tự hành, kho vận tự động hóa bằng robot, nền tảng chẩn đoán hình ảnh y tế và các thiết bị tính toán không gian đều có chung một đòi hỏi: đội ngũ kỹ sư không chỉ nắm vững kiến trúc mô hình, mà còn phải làm chủ toàn bộ chu trình từ cảm biến đến khâu suy luận trong môi trường vận hành thực tế.
Lộ trình này gồm bốn giai đoạn, phát triển từ toán học không gian và các thành phần thị giác nền tảng cốt lõi, tiến đến triển khai tại biên và tối ưu hóa tương thích với phần cứng. Mỗi giai đoạn đều được xây dựng trực tiếp trên nền tảng của giai đoạn trước đó.
Bước 1: Toán học không gian và các thành phần thị giác nền tảng
Bản chất của mọi hệ thống CV suy cho cùng là hệ thống suy luận về hình học. Trước khi tiếp cận các kiến trúc thị giác hiện đại, nhân sự kỹ thuật cần có hiểu biết thực tiễn về nền tảng toán học phục vụ cho việc suy luận thị giác.
Các khái niệm cốt lõi ở giai đoạn này bao gồm biến đổi ma trận, hệ tọa độ, hình học xạ ảnh và hình học đa góc nhìn. Đây không phải là các lý thuyết trừu tượng, mà là cơ sở xác định cách thức máy ảnh ánh xạ thế giới 3D lên cảm biến 2D, cách hai góc nhìn máy ảnh có thể tái tạo chiều sâu, cũng như mối liên hệ giữa các hệ tọa độ của nhiều cảm biến trong một hệ thống đa máy ảnh.
Về mặt triển khai thực tế, cần sử dụng thành thạo PyTorch để xử lý tensor, công cụ vẫn đang là khung làm việc tiêu chuẩn trong nghiên cứu và ứng dụng thị giác thực tế. Cùng với đó là việc xây dựng các quy trình tăng cường dữ liệu tổng hợp. Albumentations hiện là thư viện phổ biến nhất cho nhiệm vụ này, cung cấp các phép biến đổi nhanh chóng, có thể kết hợp linh hoạt nhằm mô phỏng sự thay đổi ánh sáng, biến dạng hình học và hiện tượng che khuất mà không cần thu thập dữ liệu mới.
Biểu diễn đặc trưng là trụ cột thứ ba trong giai đoạn này. Cần phân biệt rõ giữa kiến trúc mạng xương sống tích chập (như ResNet, EfficientNet) và kiến trúc dựa trên cơ chế chú ý (attention). Học biểu diễn tương phản — phương pháp mô hình học thông qua việc so sánh các mẫu tương đồng và khác biệt — đã trở thành kỹ thuật tiêu chuẩn để trích xuất các vectơ nhúng hữu ích trước khi tiến hành tinh chỉnh cho các tác vụ hạ nguồn.
Tài liệu tham khảo đề xuất: Sách "Multiple View Geometry in Computer Vision" của Hartley và Zisserman (tài liệu kinh điển); bài giảng môn CS231n của Đại học Stanford (miễn phí trực tuyến); chuỗi bài hướng dẫn về tensor trong tài liệu chính thức của PyTorch.
Bài tập thực hành: Triển khai quy trình ước tính độ sâu lập thể cơ bản từ hai hình ảnh đã hiệu chuẩn. Trực quan hóa bản đồ sai lệch và ghi nhận các trường hợp ước tính không chính xác cùng nguyên nhân.
Bước 2: Mô hình Vision Transformer và các mô hình nền tảng đa phương thức
Sự chuyển dịch từ mạng nơ-ron tích chập (CNN) sang các kiến trúc nền tảng transformer trong thị giác máy tính đã định hình lại yêu cầu chuyên môn đối với kỹ sư thị giác máy tính (CV). Mô hình Vision Transformer (ViT) xử lý hình ảnh dưới dạng các chuỗi phân mảnh có kích thước cố định, áp dụng cơ chế tự chú ý (self-attention) trên toàn bộ các phân mảnh thay vì sử dụng các bộ lọc tích chập cục bộ. Mô hình Swin Transformer mở rộng phương pháp này bằng cơ chế chú ý theo cửa sổ phân cấp, nâng cao tính khả thi khi xử lý dữ liệu đầu vào có độ phân giải cao.
Bên cạnh các mô hình thị giác thuần túy, bước phát triển có ý nghĩa then chốt là sự ra đời của các mô hình ngôn ngữ - thị giác (VLM). Các mô hình như CLIP và SigLIP học không gian biểu diễn nhúng chung giữa hai phương thức hình ảnh và văn bản thông qua phương pháp huấn luyện đối chiếu trên các tập dữ liệu lớn từ internet. Kết quả thực tiễn đạt được là khả năng hiểu theo từ vựng mở (open-vocabulary understanding), cho phép truy vấn bối cảnh hình ảnh bằng mô tả ngôn ngữ tự nhiên thay vì dựa vào các nhãn phân loại cố định.
Thành tựu này mở ra nhóm kỹ thuật nhận diện từ vựng mở. Các mô hình như OWL-ViT và Grounding DINO mở rộng năng lực định vị vật thể, cho phép phát hiện bất kỳ đối tượng nào được mô tả bằng văn bản mà không cần huấn luyện lại trên tập dữ liệu gắn nhãn của đối tượng đó.
Mô hình Segment Anything Model 2 (SAM 2) của Meta tiếp cận theo hướng khác, cung cấp khả năng phân đoạn không cần huấn luyện trước (zero-shot) dựa trên câu lệnh điều hướng cho cả hình ảnh tĩnh và luồng video. Khi người dùng hoặc mô hình tiền xử lý cung cấp tọa độ điểm, khung bao hoặc câu lệnh văn bản, SAM 2 sẽ trích xuất mặt nạ phân đoạn chất lượng cao mà không đòi hỏi huấn luyện chuyên biệt theo tác vụ.
Việc nắm vững cơ chế vận hành của các mô hình nền tảng này, xác định các trường hợp phát sinh lỗi (dịch chuyển miền dữ liệu, phân biệt chi tiết nhỏ, vật thể hiếm gặp) và phương pháp tích hợp các mô hình vào quy trình xử lý là kỹ năng trọng tâm ở giai đoạn này.
import torch
from PIL import Image
import requests
from transformers import AutoProcessor, AutoModelForZeroShotObjectDetection
model_id = "IDEA-Research/grounding-dino-tiny"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForZeroShotObjectDetection.from_pretrained(model_id)
image = Image.open("scene.jpg")
text_prompt = "a red forklift. a safety helmet."
inputs = processor(images=image, text=text_prompt, return_tensors="pt")
outputs = model(**inputs)
Đoạn mã này thực thi tác vụ nhận diện từ vựng mở bằng cách sử dụng câu lệnh văn bản đối chiếu với hình ảnh bối cảnh mà không yêu cầu huấn luyện chuyên biệt theo tác vụ.
Tài liệu tham khảo khuyến nghị: Bài báo khoa học gốc về ViT "An Image is Worth 16x16 Words"; tài liệu hướng dẫn thư viện Transformers của Hugging Face phục vụ nạp mô hình thực nghiệm; kho lưu trữ mã nguồn SAM 2 của Meta AI.


Nguồn tin: KDnuggets — Tác giả: Vinod Chugani. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.