

Harness²: Nâng cao hiệu suất của AI Agent mà không cần nâng cấp mô hình
Khi một AI agent không hoàn thành nhiệm vụ, việc nâng cấp mô hình thường được xem là giải pháp hiển nhiên tiếp theo. Tuy nhiên, hiệu năng của tác tử này còn phụ thuộc vào cách tiếp nhận chỉ dẫn, sử dụng công cụ và quản lý quy trình làm việc. Việc nắm bắt các yếu tố đó có thể mở ra cơ hội nâng cao độ tin cậy ngay trên mô hình hiện có. Dự án Harness² của Google Research đi sâu nghiên cứu [...] Bài viết Harness²: Nâng cao hiệu năng AI agent mà không cần nâng cấp mô hình xuất hiện đầu tiên trên Analytics Vidhya.
-->
Harness²: Tối ưu hóa AI Agent mà không cần thay đổi mô hình
Hội nghị AI mang tính tương lai nhất của Ấn Độ trở lại – Quy mô hơn, sắc bén hơn, táo bạo hơn
-->
ngày
:
giờ
:
phút
:
giây
Xem chi tiết
-->
DeepSeek-->
Khóa học miễn phí
Khóa học miễn phí-->
Lộ trình học tập-->
Chương trình tăng tốc -->
Chương trình tăng tốc -->
Mới -->
Chương trình GenAI Pinnacle-->
GenAI Pinnacle Plus
Tiên phong Agentic AI
Mới-->
Đăng nhập
Chuyển đổi chế độ
Đăng xuất
-->
Chuẩn bị phỏng vấn
Sự nghiệp
GenAI
Kỹ nghệ prompt
ChatGPT
LLM
Langchain
RAG
AI Agents
Machine Learning
Deep Learning
Công cụ GenAI
LLMOps
Python
NLP
SQL
Dự án AIML
Danh sách bài đọc
Lộ trình học Chuyên viên phân tích dữ liệu
Lộ trình toàn diện để trở thành Chuyên viên phân tích dữ liệu năm 2025
Lộ trình học Tableau
Lộ trình học tập toàn diện về Tableau năm 2025
Lộ trình học NLP
Lộ trình học tập toàn diện về NLP năm 2025
Lộ trình học Nhà khoa học dữ liệu
Lộ trình học tập để trở thành Nhà khoa học dữ liệu năm 2025
Lộ trình học Kỹ sư dữ liệu
Lộ trình từng bước để trở thành Kỹ sư dữ liệu năm 2025
Lộ trình học MLOps
Lộ trình học tập MLOps toàn diện: Phiên bản 2025
Lộ trình học Kỹ sư AI
Lộ trình để trở thành Kỹ sư AI năm 2025
Lộ trình học Thị giác máy tính
Lộ trình học tập toàn diện để làm chủ Thị giác máy tính năm 2025
Lộ trình học AI tạo sinh
Lộ trình tối ưu để học AI tạo sinh năm 2025
Lộ trình AI tạo sinh cho doanh nghiệp
Lộ trình GenAI cho doanh nghiệp
Lộ trình LLM
Giải mã các mô hình ngôn ngữ lớn: Lộ trình cho người mới bắt đầu
Lộ trình học Kỹ sư prompt
Lộ trình học tập để trở thành Chuyên gia kỹ nghệ prompt
Trang chủ
AI Agents
Harness²: Nâng cao hiệu suất AI Agent mà không cần nâng cấp mô hình
Harness²: Nâng cao hiệu suất AI Agent mà không cần nâng cấp mô hình
Sree Vamsi
Cập nhật lần cuối:
Ngày 30/10/2026
8 phút đọc
Khi một tác tử AI (AI agent) không hoàn thành nhiệm vụ, việc nâng cấp mô hình thường được xem là giải pháp tất yếu tiếp theo. Tuy nhiên, hiệu suất của tác tử còn phụ thuộc vào phương thức tiếp nhận chỉ dẫn, vận hành công cụ và quản lý quy trình xử lý. Việc thấu hiểu các yếu tố này có thể mở ra những giải pháp nâng cao độ tin cậy ngay trên mô hình hiện có.
Nghiên cứu Harness² của Google Research tập trung phân tích cấu trúc thiết lập phụ trợ và vai trò của cấu trúc này đối với hiệu suất của tác tử. Dự án đã được cài đặt và vận hành thử nghiệm nhằm đánh giá trực tiếp cơ chế hoạt động. Bài viết này phân tích kết quả nghiên cứu, quy trình triển khai và những bài học kinh nghiệm cho các nhà phát triển trong quá trình xây dựng tác tử AI.
Mục lục
Không cấu trúc phụ trợ nào đạt hiệu quả tối ưu trong mọi trường hợp!
Vì sao các prompt tự chỉnh sửa thất bại?
Các thành phần được chỉnh sửa thay thế
Đề xuất, Thăm dò, Hợp thành (Propose, Probe, Compose)
Đánh giá
Triển khai
Kiểm tra một lượt vận hành
Chuyển sang bộ tiêu chuẩn đánh giá thực tế
Kết luận
Các câu hỏi thường gặp
Không cấu trúc phụ trợ nào đạt hiệu quả tối ưu trong mọi trường hợp!
Một cấu trúc phụ trợ (harness) định hình hành vi của tác tử AI thông qua hệ thống prompt, công cụ, bộ nhớ và vòng lặp điều khiển. Tuy nhiên, mỗi cấu trúc lại phát huy hiệu quả ở từng nhóm tác vụ riêng biệt. Claude Code hoạt động vượt trội ở các tác vụ lập trình và bảng tính, trong khi Codex chiếm ưu thế ở các tác vụ trên môi trường web.
Bài học rút ra: Một cấu trúc phụ trợ cố định sẽ làm suy giảm tiềm năng hiệu suất vốn có.
Harness² hướng tới giải quyết hạn chế này bằng cơ chế tự thích ứng trong thời gian thử nghiệm, ngay cả đối với các tác vụ chưa từng được nhóm phát triển dự liệu trước.
Vì sao các prompt tự chỉnh sửa thất bại?
Việc cho phép tác nhân (agent) tự viết lại system prompt của chính mình nghe có vẻ triển vọng. Trên thực tế, điều này có thể làm giảm hiệu suất hoạt động.
Vấn đề nằm ở chỗ: mỗi chỉ dẫn được bổ sung đều đi kèm với một chi phí nhất định.
System prompt được xử lý lặp đi lặp lại trong suốt quá trình thực hiện tác vụ. Khi dung lượng prompt tăng lên, chúng tiêu tốn nhiều token hơn, làm thu hẹp không gian xử lý cho công việc thực tế.
Khi giới hạn token cạn kiệt, tác nhân có thể gặp lỗi và dừng lại trước khi hoàn thành nhiệm vụ.
Những thành phần được chỉnh sửa thay thế
Harness² cung cấp tám thành phần, phần lớn trong số đó duy trì ở trạng thái không hoạt động cho đến khi có tác nhân kích hoạt. Điểm mấu chốt là: chúng không tiêu tốn tài nguyên khi chưa sử dụng, khác biệt hoàn toàn với văn bản prompt.
Nhóm | Các thành phần | Đối tượng kiểm soát
Ngữ cảnh | System prompt, hàng rào bảo vệ (guardrails), bộ nhớ, kỹ năng | Nội dung mô hình tiếp nhận trước khi hành động
Giao diện công cụ | Hướng dẫn công cụ, tệp lệnh (scripts) | Cách thức mô tả và kích hoạt các công cụ
Ủy quyền | Tác nhân phụ (subagents) | Phần việc được chuyển giao sang một ngữ cảnh độc lập
Phần mềm trung gian | Tiện ích bổ sung (plugins) | Hành vi bên trong vòng lặp công cụ
Điểm khác biệt cốt lõi: một quy tắc trong prompt chỉ mang tính khuyến nghị; một quy tắc trong vòng lặp điều khiển là mang tính bắt buộc thực thi.
Hai giải pháp khắc phục thực sự hiệu quả
Ngăn chặn việc tìm kiếm dữ liệu không hồi kết: Tác nhân đã thiết lập một trình giám sát (watchdog) để theo dõi các bước thực hiện và buộc hệ thống phải bắt đầu viết trước khi cạn kiệt dung lượng token.
Phát hiện các bảng tính chưa hoàn chỉnh: Hệ thống đã chặn việc xác nhận hoàn thành tác vụ cho đến khi một tệp lệnh kiểm tra và xác nhận không có công thức nào bị thiếu sót.
Lý do mang lại hiệu quả: Khác với các chỉ dẫn trong prompt, các cơ chế bảo đảm an toàn này được thực thi bằng mã lệnh, không phụ thuộc vào khả năng tuân thủ tự nguyện của mô hình.
Đề xuất, Thử nghiệm, Hợp nhất
Thách thức lớn nhất là xác định xem một chỉnh sửa có thực sự mang lại hiệu quả hay không. Trong các bài kiểm chuẩn (benchmark), luôn có sẵn đáp án đối chiếu; trong tác vụ thực tế thì không.
Giai đoạn | Tiến trình thực hiện
Đề xuất (Propose) | Tác nhân chạy tác vụ một lần. Hai bộ phận chỉnh sửa độc lập sẽ đọc nhật ký thực thi: một bên xem xét cơ chế quy trình làm việc, chẳng hạn như các lệnh gọi công cụ bị lỗi; bên còn lại đóng vai trò chuyên gia lĩnh vực để đề xuất các quy tắc chuyên môn.
Thử nghiệm (Probe) | Khung điều khiển (harness) đã chỉnh sửa được chạy trên cùng tác vụ đó, tạo ra lần thử thứ hai để so sánh với lần đầu.
Hợp nhất (Compose) | Hai lần chạy được đem ra so sánh. Một chỉnh sửa chỉ được giữ lại nếu đã khắc phục được một lỗi cụ thể, có thể quan sát thấy từ lần chạy đầu tiên. Mọi yếu tố khác đều bị loại bỏ.
Tín hiệu đánh giá bắt nguồn từ sự khác biệt giữa các lần thực thi, không dựa trên điểm số so với đáp án có sẵn. Đây chính là yếu tố cho phép hệ thống hoạt động trên những tác vụ hoàn toàn mới.
Bước thử nghiệm không mang tính hình thức. Nếu thiếu bước này, hiệu suất giảm khoảng 10%.
Thử nghiệm cho phép tác nhân tự chỉnh sửa khung điều khiển của mình và mặc nhiên tin tưởng vào kết quả chỉnh sửa cho thấy: hiệu suất thu được còn kém hơn so với việc không chỉnh sửa.
Đánh giá
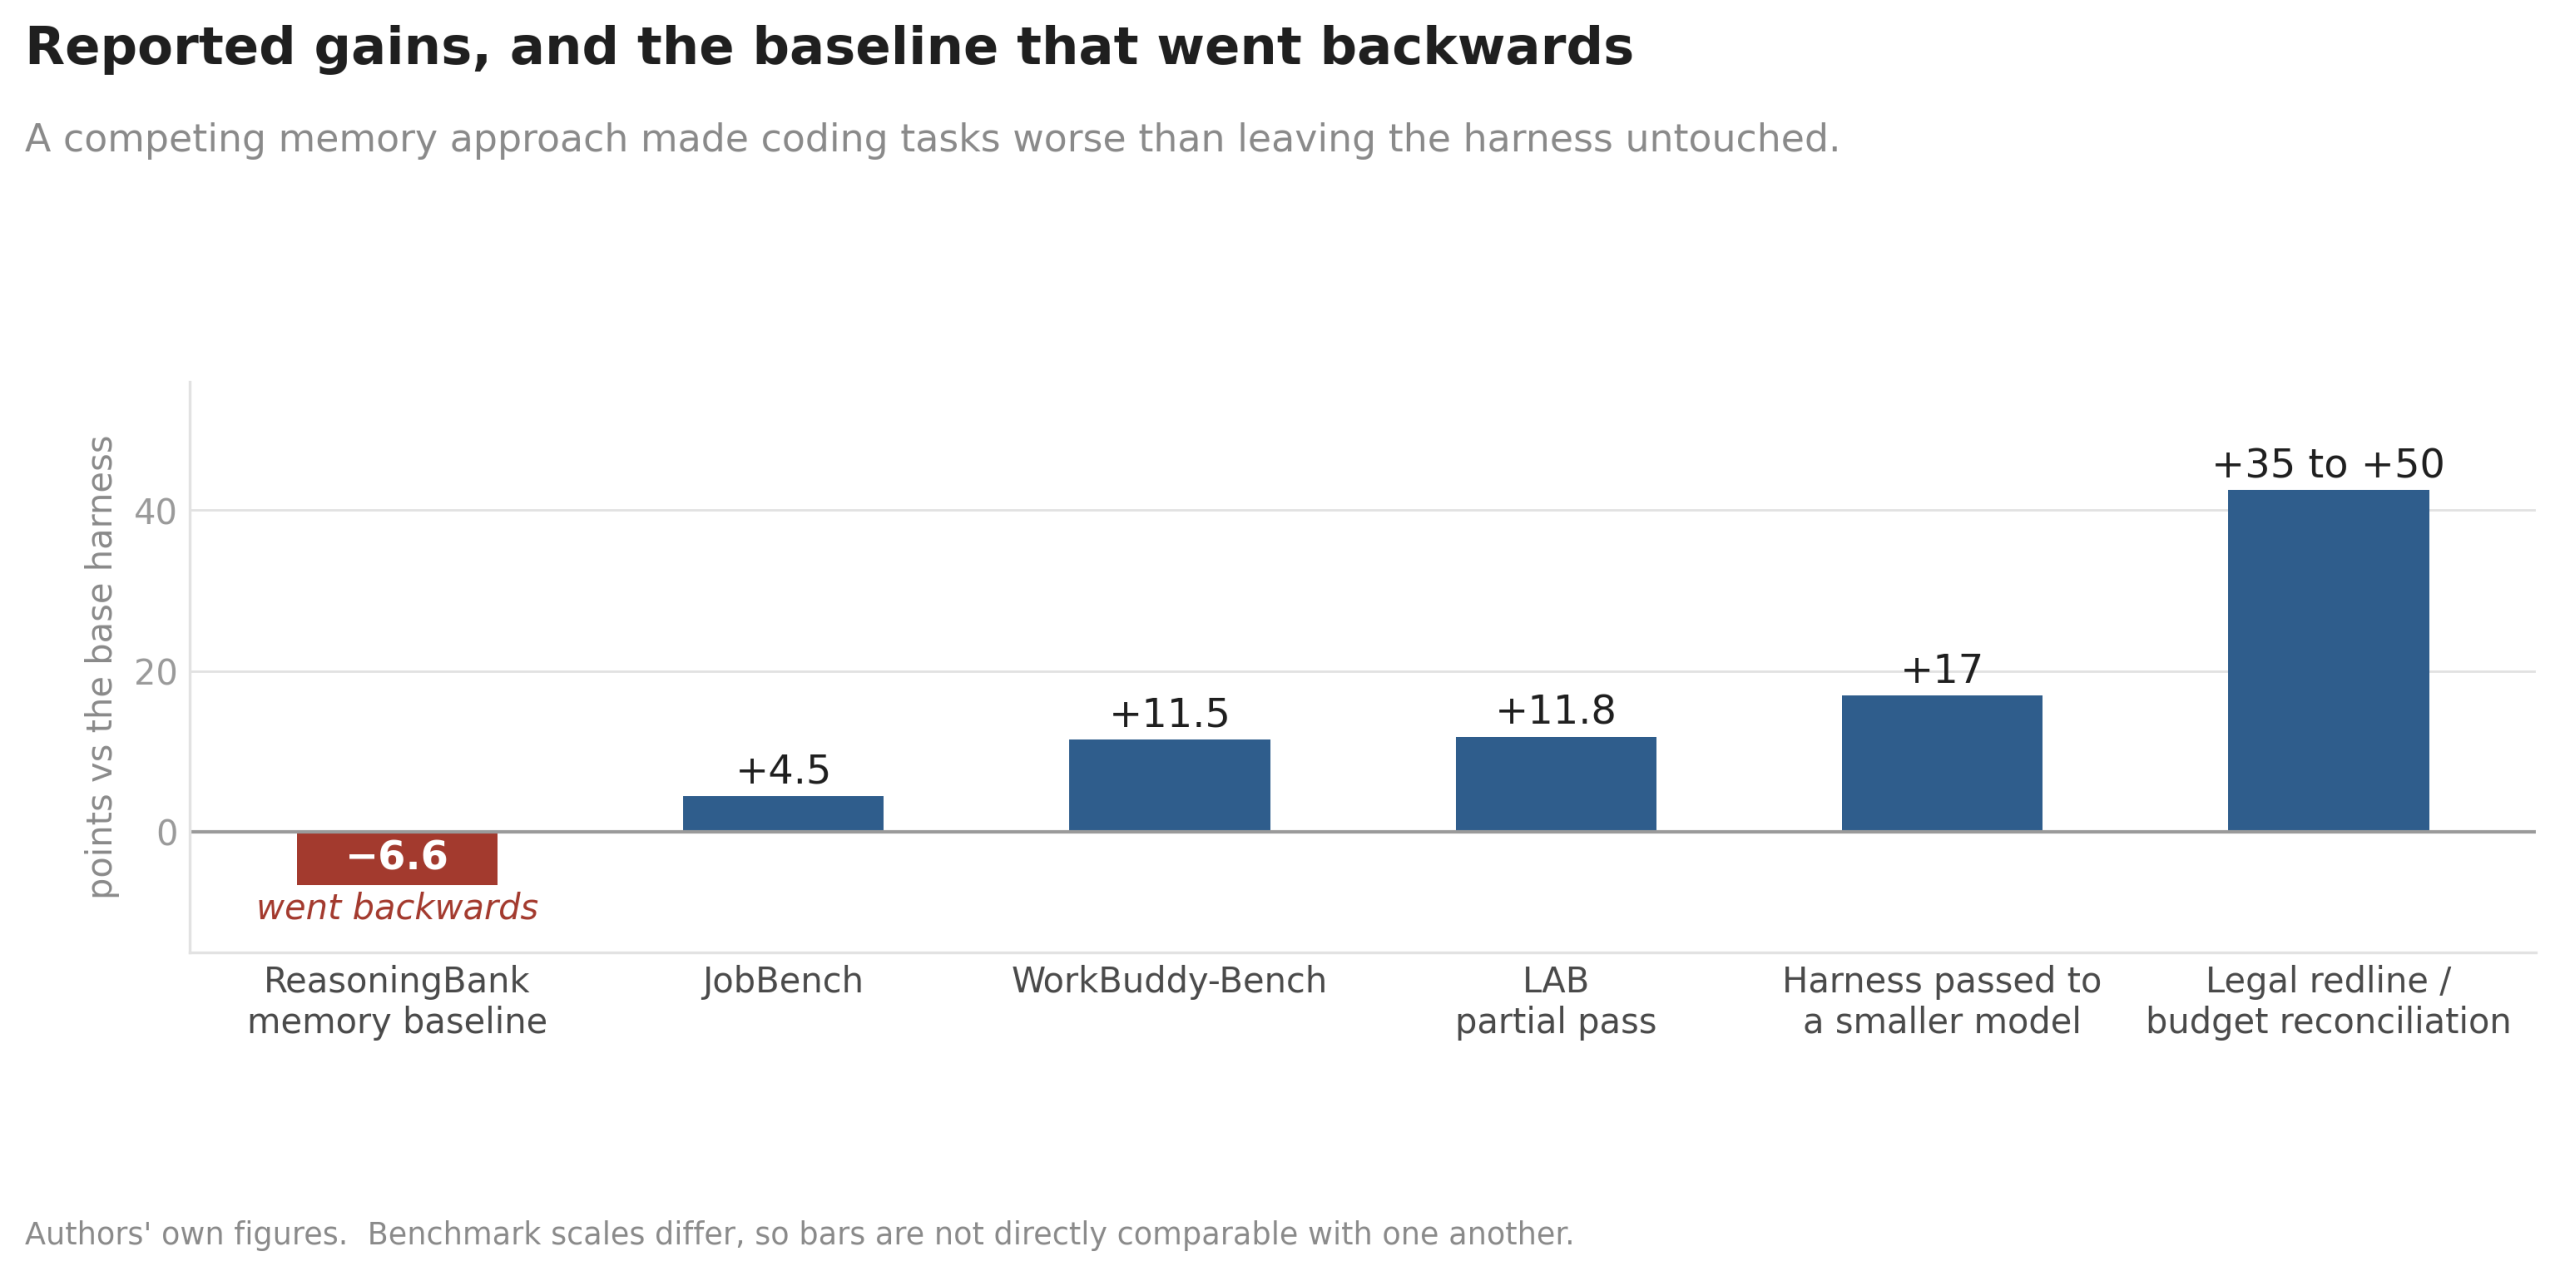
Kết quả nghiên cứu ghi nhận
Được thử nghiệm trên ba bộ chuẩn đánh giá chuyên nghiệp qua bốn cấu hình mô hình - khung điều khiển, sử dụng GLM-5 và



Nguồn tin: Analytics Vidhya — Tác giả: Sree Vamsi. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.