
Độ chính xác dấu phẩy động và tác động đối với quá trình suy luận mô hình
Tổng quan Bài viết này được chia thành năm phần, bao gồm: • Nguyên lý hoạt động của số thực dấu phẩy động • Các định dạng độ chính xác phổ biến • Tải mô hình ở mức độ chính xác khác • Độ chính xác hỗn hợp và các phép tính nhạy cảm • Đo lường kết quả Nguyên lý hoạt động của số thực dấu phẩy động Một số thực dấu phẩy động bao gồm phần dấu, phần mũ và phần định trị (thường được gọi là mantissa).
Độ chính xác số thực dấu phẩy động và tác động đối với suy luận mô hình
Tác giả: Adrian Tam, ngày 7/11/2026, chuyên mục Suy luận từ các mô hình Transformer 0
Chia sẻ
Đăng bài
Chia sẻ
Một mô hình là một tập hợp các con số. Định dạng được sử dụng để lưu trữ và tính toán các con số này quyết định dung lượng bộ nhớ mà mô hình chiếm dụng, tốc độ luân chuyển dữ liệu của phần cứng và các đơn vị số học có khả năng xử lý chúng. Do đó, việc thay đổi độ chính xác có thể giúp quá trình suy luận diễn ra nhanh hơn mà không cần thay đổi kiến trúc mô hình.
Độ chính xác thấp hơn không đồng nghĩa với việc luôn tốt hơn. Một định dạng có thể giúp tiết kiệm bộ nhớ nhưng lại vận hành chậm khi phần cứng đích thiếu kernel tính toán phù hợp. Định dạng đó có thể biểu diễn được các giá trị lớn nhưng lại làm mất đi các sai biệt nhỏ, hoặc duy trì được sai biệt tinh vi gần mức 0 nhưng lại gặp hiện tượng tràn số đối với các giá trị kích hoạt ngoại lai. Vấn đề cốt lõi không phải là việc lựa chọn định dạng có ít bit nhất, mà là định dạng đáp ứng được yêu cầu về chất lượng và được triển khai hiệu quả trên phần cứng thực tế.
Bài viết này đề cập đến các nội dung sau:
Cách các định dạng số thực dấu phẩy động cân đối giữa phạm vi biểu diễn, độ chính xác và mức sử dụng bộ nhớ;
Cách nạp mô hình ở độ chính xác phù hợp và xử lý các phép toán nhạy cảm;
Cách đo lường tác động của việc thay đổi độ chính xác đối với hiệu năng và chất lượng.
Dưới đây là nội dung chi tiết.
Độ chính xác số thực dấu phẩy động và tác động đối với suy luận mô hình.
Ảnh: Jean-Luc Benazet. Giữ một số quyền.
Tổng quan
Bài viết được chia thành năm phần:
Nguyên lý hoạt động của số thực dấu phẩy động
Các định dạng độ chính xác phổ biến
Nạp mô hình ở các mức độ chính xác khác nhau
Độ chính xác hỗn hợp và các phép toán nhạy cảm
Đánh giá kết quả
Nguyên lý hoạt động của số thực dấu phẩy động
Một số thực dấu phẩy động bao gồm phần dấu, phần mũ và phần định trị (thường gọi là mantissa). Phần mũ quyết định phạm vi độ lớn có thể biểu diễn. Phần định trị quyết định mức độ chuẩn xác để phân biệt các giá trị lân cận. Việc cắt giảm bất kỳ trường nào trong hai trường này đều dẫn đến sự đánh đổi.
Biểu diễn float32 cho giá trị $6.5$.
Hình trên minh họa một số chuẩn tắc hữu hạn. Chữ số $1$ dẫn đầu trong phần định trị là ngầm định, do đó 23 bit phân số được lưu trữ mang lại độ chính xác 24 bit. Các trường số mũ toàn số 0 và toàn số 1 lần lượt mã hóa các số phi chuẩn (subnormal) hoặc số 0, cùng các giá trị vô cực hoặc NaN; các trường này không áp dụng công thức của số chuẩn tắc nêu trong hình.
Bốn hiệu ứng quan trọng cần lưu ý trong quá trình suy luận:
Làm tròn: Một giá trị nằm giữa hai số có thể biểu diễn được thay thế bằng một trong hai số đó.
Tràn dưới (underflow): Một giá trị quá nhỏ trở thành số 0 hoặc mất phần lớn các bit có nghĩa.
Tràn trên (overflow): Một giá trị vượt quá giới hạn biểu diễn của định dạng và trở thành vô cực.
Sai số tích lũy: Nhiều tích số sau khi làm tròn được cộng dồn, khiến các sai số nhỏ tích tụ lại.
PyTorch cung cấp các giới hạn này thông qua hàm torch.finfo():
In các giới hạn số học của các kiểu số thực dấu phẩy động phổ biến trong PyTorch.
import torch
for dtype in (torch.float32, torch.float16, torch.bfloat16):
info = torch.finfo(dtype)
print(
dtype,
"smallest_normal=", info.tiny,
"largest=", info.max,
"resolution=", info.eps,
)
1
2
3
4
5
6
7
8
9
10
import torch
for dtype in (torch.float32, torch.float16, torch.bfloat16):
info = torch.finfo(dtype)
print(
dtype,
"smallest_normal=", info.tiny,
"largest=", info.max,
"resolution=", info.eps,
)
Định dạng float16 (FP16) có nhiều bit định trị (significand) hơn bfloat16 (BF16), do đó có thể phân biệt các giá trị gần nhau với độ chính xác cao hơn. Định dạng bfloat16 có số bit phần mũ (exponent) tương đương float32 (FP32), vì vậy hỗ trợ dải động lớn hơn nhiều so với float16. Đối với các giá trị kích hoạt (activations) của transformer, dải giá trị rộng hơn của BF16 thường tránh được hiện tượng tràn số (overflow) vốn có thể xảy ra ở FP16. Lựa chọn tối ưu vẫn phụ thuộc vào mô hình, kernels và phần cứng cụ thể.
Kiểu dữ liệu (dtype) của một tensor đầu vào không phản ánh toàn diện phép toán số học. Một phép nhân ma trận có thể tiếp nhận các toán tử FP16, tích lũy các tổng riêng phần ở định dạng FP32 và xuất kết quả dưới dạng FP16. Kết quả trung gian có độ chính xác cao hơn thường được sử dụng nhằm tránh hiện tượng tràn số trên (overflow) và tràn số dưới (underflow). Các thiết lập phần cứng và thư viện quyết định quy trình tính toán cụ thể này. Khi ghi nhận kết quả đánh giá hiệu năng (benchmark), cần ghi rõ độ chính xác của toán tử, phép tích lũy và kết quả đầu ra bất cứ khi nào có thể.
Các định dạng độ chính xác phổ biến
FP32 là định dạng độ chính xác đơn 32-bit và là hệ quy chiếu số học hữu ích. Định dạng này tiêu tốn dung lượng bộ nhớ tham số gấp hai lần so với định dạng 16-bit. FP64 hữu ích cho một số phép tính khoa học, song chi phí lưu trữ và tính toán của định dạng này hiếm khi mang lại hiệu quả cho quá trình suy luận của LLM. Khả năng hỗ trợ các kiểu dữ liệu có độ rộng lớn hơn thay đổi tùy theo phần mềm và phần cứng; hiện chưa có phương thức suy luận FP128 thay thế trực tiếp mang tính phổ quát.
FP16 sử dụng 16 bit với 5 bit dành cho phần mũ. Định dạng này giúp giảm dung lượng lưu trữ mô hình và lưu lượng truy cập bộ nhớ, đồng thời các bộ tăng tốc hiện đại có thể xử lý phép nhân ma trận FP16 với tốc độ cao. Dải giá trị hạn chế khiến định dạng này có nguy cơ gặp hiện tượng tràn số khi các giá trị kích hoạt chứa dữ liệu lớn.
BF16 cũng sử dụng 16 bit, song phân bổ 8 bit cho phần mũ và ít bit hơn cho phần định trị. Dải giá trị của BF16 gần tương đương FP32, nhưng độ chính xác thấp hơn. Các GPU trung tâm dữ liệu thế hệ mới và một số CPU hỗ trợ tính toán BF16 với tốc độ cao. PyTorch cũng hỗ trợ các phép toán BF16 và tính năng tự động chuyển đổi độ chính xác (autocast) trên CPU, dù các phép toán không được hỗ trợ có thể phải chuyển sang kiểu dữ liệu khác hoặc chạy chậm hơn. Cần kiểm tra thiết bị thực tế và các kernels trước khi lựa chọn định dạng này.
Các định dạng FP8 sử dụng 8 bit. FP8 giúp giảm dung lượng bộ nhớ của mô hình trong trường hợp mức tiêu tốn 16 bit cho mỗi giá trị là quá lớn. Có nhiều cấu trúc bố trí (layout) FP8 khác nhau do 8 bit không thể cung cấp đồng thời cả dải giá trị rộng và độ chính xác cao. E4M3 có độ chính xác định trị cao hơn, trong khi E5M2 sở hữu dải giá trị rộng hơn. Các công cụ suy luận có thể chọn những định dạng khác nhau cho trọng số (weights), giá trị kích hoạt và gradient, đồng thời thường lưu trữ thông tin điều chỉnh tỷ lệ (scaling) bên ngoài giá trị 8-bit.
Các định dạng FP4 giúp cắt giảm dung lượng lưu trữ sâu hơn. Do 4 bit là quá ít để có thể thay thế trực tiếp FP16 trong các ứng dụng chung, các hệ thống thực tế phải sử dụng phương pháp mã hóa chọn lọc kỹ lưỡng, tỷ lệ theo khối (block scales), kỹ thuật hiệu chuẩn hoặc quy trình huấn luyện đặc thù. MXFP4 và NVFP4 quy định các tiêu chuẩn về tỷ lệ và cấu trúc bố trí khác nhau; khả năng hỗ trợ từ bộ tăng tốc phụ thuộc vào thế hệ phần cứng cụ thể và ngăn xếp phần mềm (software stack). Cần đối chiếu định dạng cụ thể với bảng tương thích của môi trường thực thi (runtime).
Dung lượng bộ nhớ tham số của một mô hình dày đặc (dense model) là
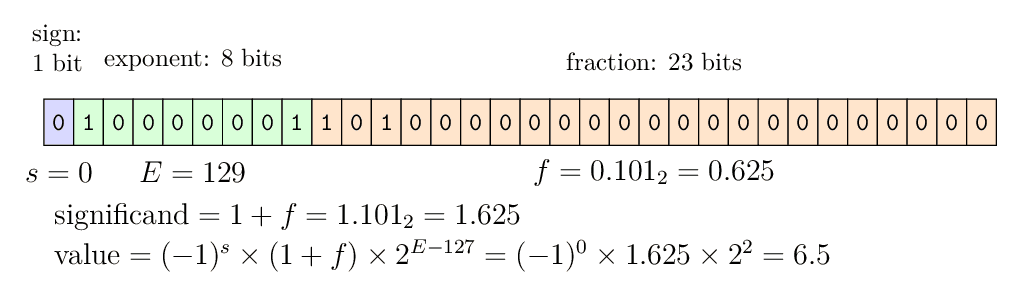
Nguồn tin: Machine Learning Mastery — Tác giả: Adrian Tam. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.