
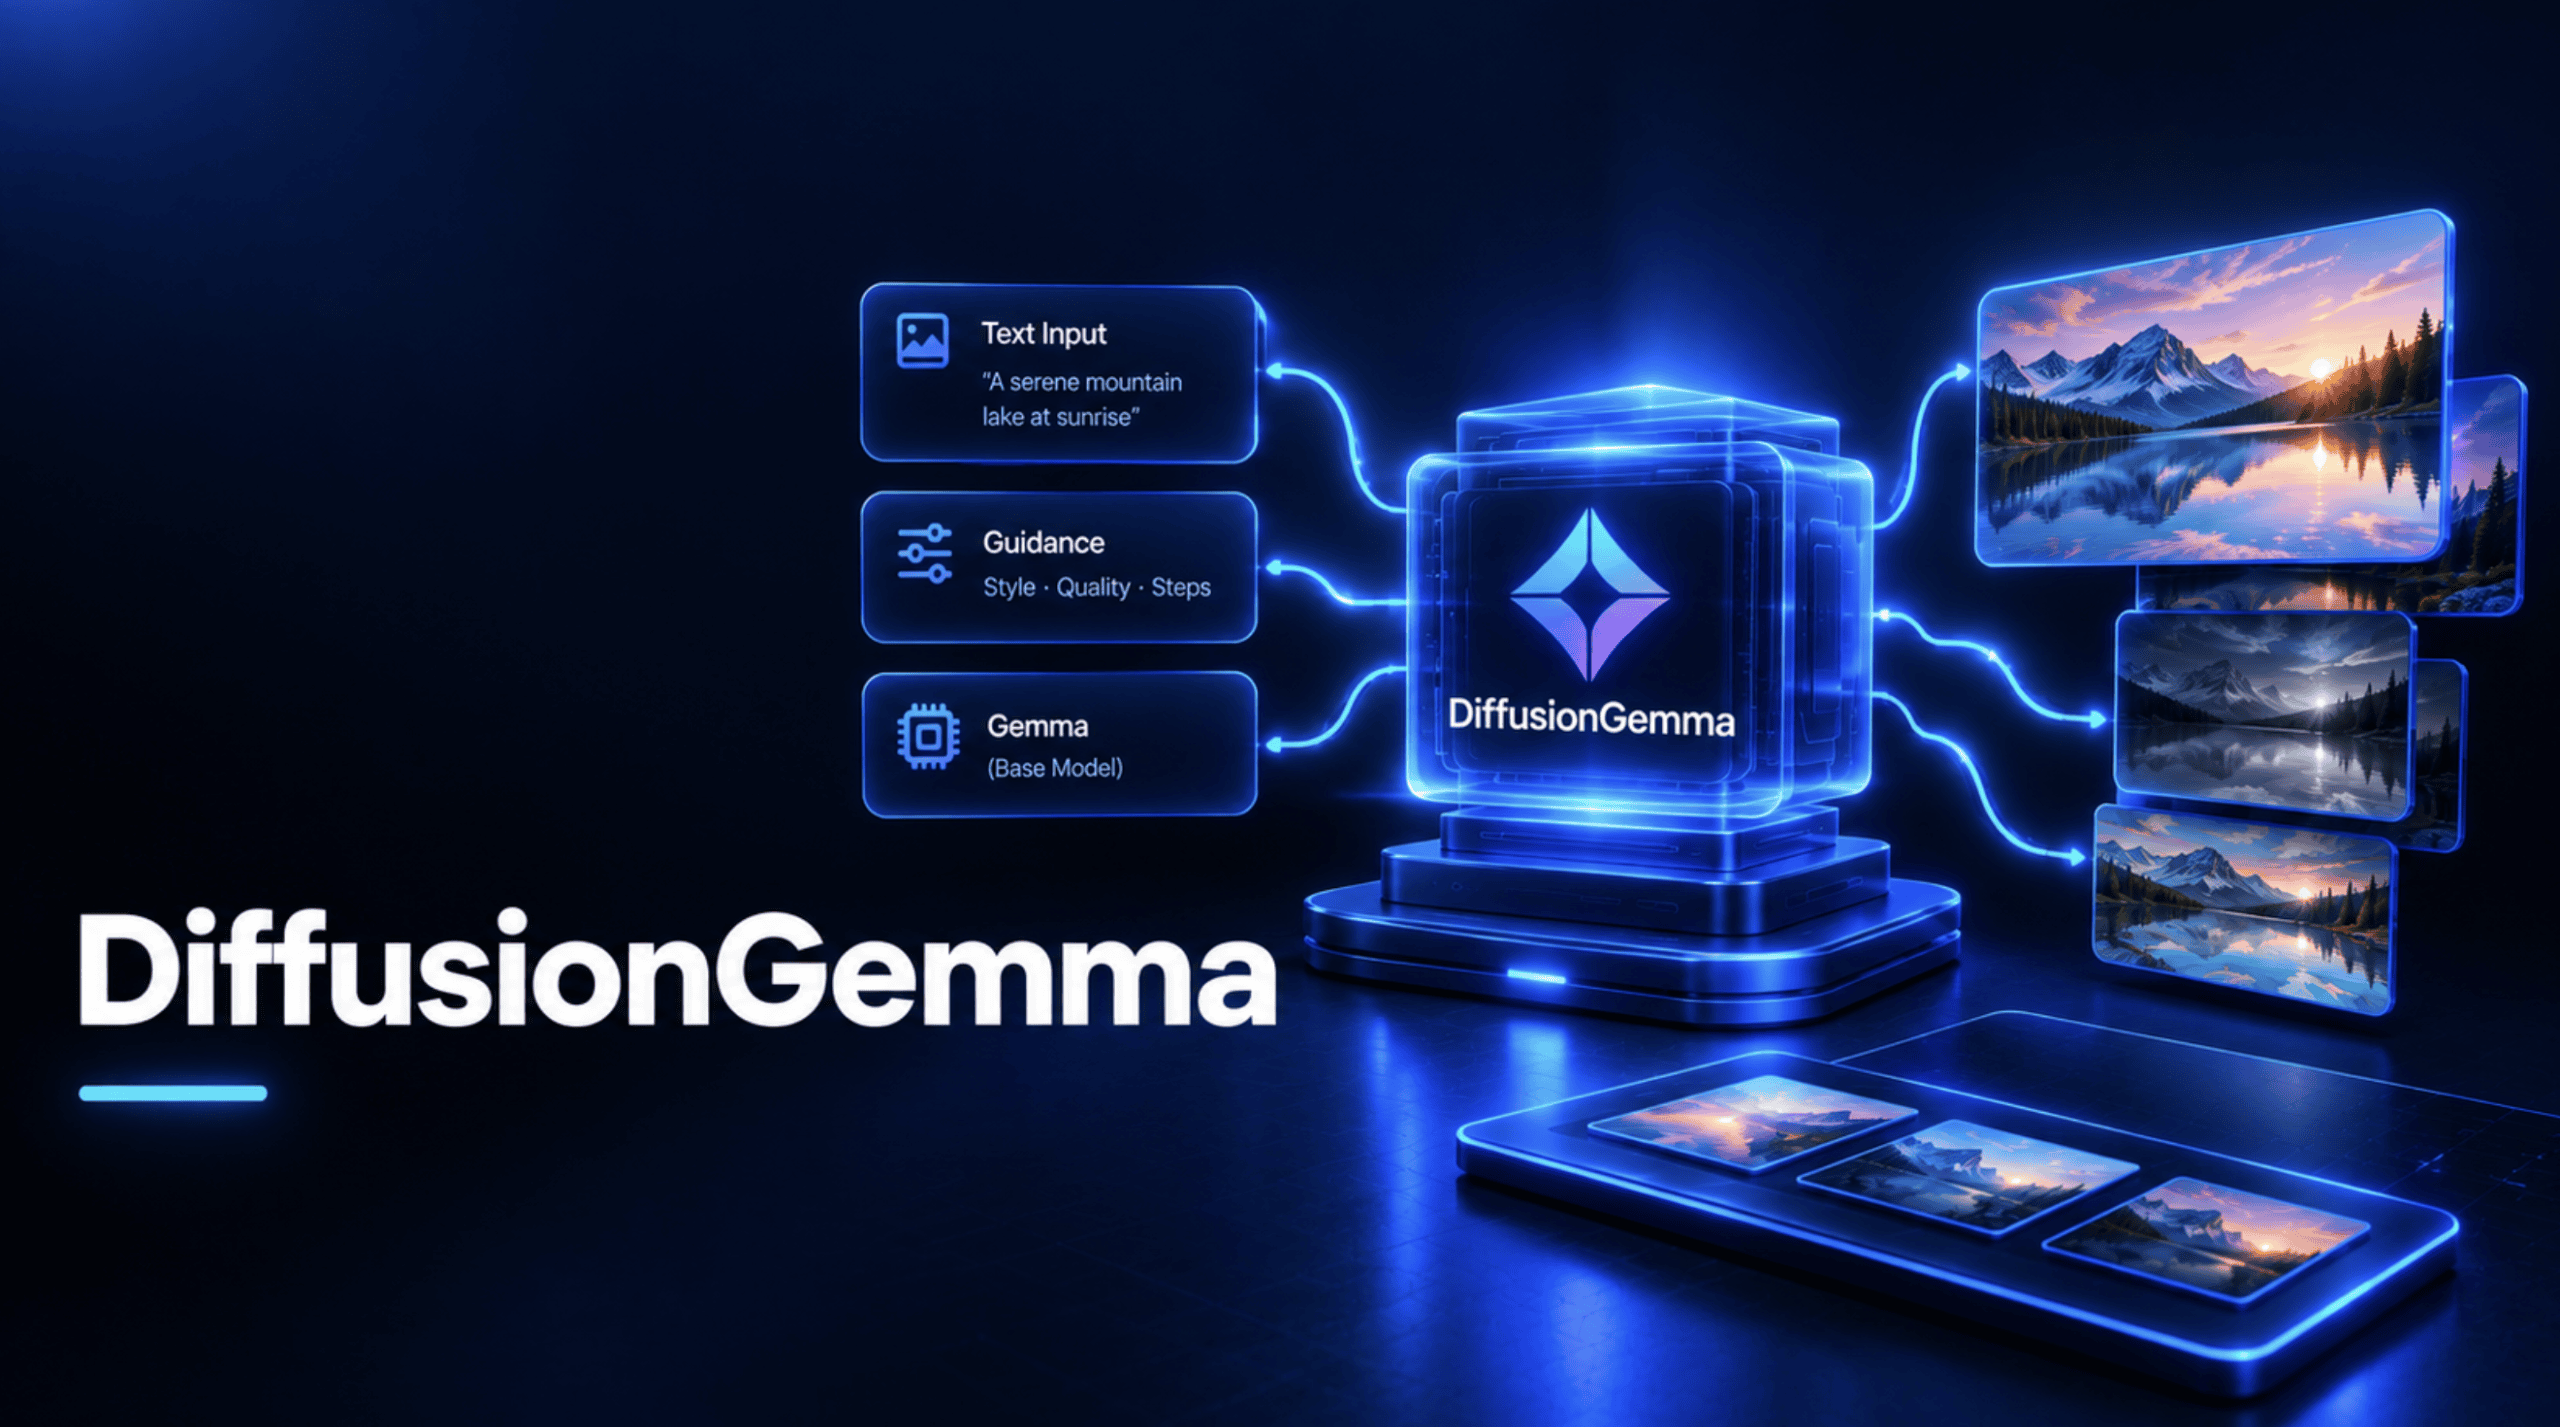
DiffusionGemma: Trải nghiệm thực tế mô hình ngôn ngữ có khả năng tạo văn bản đồng thời của Google
Bài viết giới thiệu về DiffusionGemma, phân tích điểm khác biệt giữa cơ chế tạo văn bản dựa trên mô hình khuếch tán (diffusion) của hệ thống này so với các mô hình ngôn ngữ tự hồi quy (autoregressive language models) tiêu chuẩn, đồng thời hướng dẫn phương thức vận hành...
DiffusionGemma: Trải nghiệm thực tế mô hình văn bản tạo sinh đồng thời của Google
Tác giả: Shittu Olumide, ngày 6/11/2026, chuyên mục Mô hình ngôn ngữ 0
Chia sẻ
Đăng bài
Chia sẻ
Bài viết này phân tích bản chất của DiffusionGemma, sự khác biệt giữa phương thức tạo văn bản dựa trên cơ chế khuếch tán (diffusion) với các mô hình ngôn ngữ tự hồi quy tiêu chuẩn, cũng như quy trình vận hành mô hình này bằng thư viện Hugging Face Transformers và vLLM.
Các nội dung chính bao gồm:
Cơ chế khử nhiễu song song theo khối của DiffusionGemma và lý do mô hình này chuyển điểm nghẽn tạo sinh từ băng thông bộ nhớ sang năng lực tính toán.
Quy trình tải mô hình, tạo văn bản, theo dõi tiến trình khử nhiễu, cùng cách sử dụng các chỉ dẫn hệ thống, chế độ tư duy và dữ liệu đầu vào dạng hình ảnh với Transformers.
Cách thức triển khai DiffusionGemma với vLLM và tác dụng thực tế của các thiết lập lấy mẫu (sampling) do Google khuyến nghị.
DiffusionGemma là gì?
Các mô hình ngôn ngữ lớn phổ biến hiện nay như GPT, Claude, Gemini hay phiên bản Gemma tiêu chuẩn đều tạo văn bản theo cùng một nguyên lý cơ bản: xử lý tuần tự từng token từ trái sang phải, trong đó mỗi từ mới được tạo ra dựa trên toàn bộ nội dung đã viết trước đó. DiffusionGemma, do Google DeepMind công bố ngày 10/6/2026, đã thay đổi hoàn toàn quy chuẩn này. Đây là mô hình mở mang tính thử nghiệm, có khả năng tạo và tinh chỉnh đồng thời toàn bộ một khối văn bản song song, áp dụng cơ chế khuếch tán tương tự các mô hình tạo ảnh như Stable Diffusion vào ngôn ngữ thay vì điểm ảnh (pixel).
Bài viết phân tích cấu trúc của DiffusionGemma, sự khác biệt về mặt cơ chế giữa việc tạo văn bản bằng mô hình khuếch tán so với phương pháp tự hồi quy truyền thống trên các LLM, đồng thời cung cấp hướng dẫn thực hành chi tiết: từ khâu nạp mô hình, khởi tạo phản hồi đầu tiên, theo dõi quá trình khuếch tán theo thời gian thực cho đến việc triển khai trong môi trường vận hành thực tế.
DiffusionGemma được xây dựng trên nền tảng kiến trúc của mô hình Gemma 4 26B, sử dụng thiết kế Mixture-of-Experts với tổng cộng 26 tỷ tham số nhưng chỉ có 3,8 tỷ tham số hoạt động trên mỗi token. Tên gọi "A4B" đi kèm biểu thị số lượng tham số hoạt động này. Mô hình được phát hành theo giấy phép Apache 2.0 dưới dạng thử nghiệm, đồng nghĩa với việc Google xác định đây là bản xem trước phục vụ nghiên cứu và phát triển chứ chưa phải là một sản phẩm hoàn chỉnh, ổn định.
Một số thông số kỹ thuật đáng chú ý bao gồm: mô hình hỗ trợ đa phương thức ở đầu vào, chấp nhận văn bản, hình ảnh (với tỷ lệ khung hình và độ phân giải linh hoạt) cùng video (không hỗ trợ âm thanh), và đầu ra luôn là văn bản. Khi được lượng tử hóa (quantized), mô hình có thể hoạt động trong giới hạn 18 GB VRAM, cho phép vận hành cục bộ trên một GPU thương mại cao cấp như RTX 4090 hoặc RTX 5090. Ngoài ra, mô hình còn tích hợp chế độ tư duy có thể tùy chỉnh, cho phép phân tích bài toán từng bước qua một luồng lập luận riêng biệt trước khi đưa ra câu trả lời cuối cùng — tính năng sẽ được minh họa chi tiết ở phần sau của bài viết.
Sự khác biệt giữa cơ chế tạo văn bản khuếch tán và phương pháp truyền thống
Mô hình tự hồi quy tiêu chuẩn như GPT-4 hoặc mô hình Gemma thông thường tạo ra từng token, nối token đó vào chuỗi, đưa toàn bộ dữ liệu trở lại đầu vào rồi tiếp tục tạo token kế tiếp cho đến khi hoàn tất. Điểm nghẽn thực sự trong quy trình này, đặc biệt đối với người dùng cá nhân vận hành trên thiết bị cục bộ, không nằm ở năng lực tính toán mà ở băng thông bộ nhớ: mô hình phải liên tục nạp toàn bộ trọng số từ bộ nhớ chỉ để tạo ra một token tại một thời điểm, khiến các nhân tính toán thực tế của GPU phần lớn ở trạng thái nhàn rỗi trong khi chờ truyền tải dữ liệu. Đồng thời, do quá trình tạo nội dung diễn ra hoàn toàn tuần tự, mô hình tự hồi quy không thể chỉnh sửa những nội dung đã tạo. Khi một token đã được xác lập, token đó mang tính cố định; đây chính là nguyên nhân khiến các mô hình này đôi khi rơi vào bế tắc giữa chừng khi xử lý câu trả lời phức tạp mà không có khả năng quay lại để điều chỉnh.
DiffusionGemma đảo ngược cả hai hạn chế nêu trên. Thay vì tạo từng token riêng lẻ, mô hình bắt đầu với một khung gồm 256 token giữ chỗ (về bản chất là nhiễu ngẫu nhiên) và tiến hành khử nhiễu đồng thời toàn bộ khối qua nhiều lượt xử lý. Theo cơ chế được Google gọi là Uniform State Diffusion (Khuếch tán trạng thái đồng nhất), các token có độ tin cậy cao nhất sẽ hỗ trợ xác định các token có độ tin cậy thấp hơn, giúp toàn bộ chuỗi dần trở nên rõ nét thay vì được viết tuần tự theo thứ tự trước sau. Cơ chế này chuyển điểm nghẽn thực tế từ băng thông bộ nhớ sang năng lực tính toán, do GPU được phân bổ một khối lượng công việc song song thực sự lớn để xử lý thay vì ở trạng thái chờ giữa các bước tuần tự, từ đó tạo tiền đề nâng cao tốc độ xử lý.
Đối với các chuỗi dài hơn một khung 256 token, DiffusionGemma áp dụng phương pháp được Google gọi là khử nhiễu tự hồi quy theo khối (block-autoregressive denoising). Khi một khung được xử lý hoàn chỉnh, khung đó sẽ được ghi nhận vào bộ nhớ đệm KV (KV cache) của mô hình thông qua cơ chế chú ý nhân quả (causal attention) thông thường, tương tự như cơ chế của một mô hình tự hồi quy tiêu chuẩn; tiếp đó, một khung 256 token mới sẽ bắt đầu quá trình khử nhiễu dựa trên toàn bộ dữ liệu đã được ghi nhận trước đó. Sự kết hợp này mang tính có chủ đích: cơ chế chú ý nhân quả tuần tự dành cho lịch sử đã ghi nhận giúp duy trì tính ổn định khi tạo văn bản dài, trong khi cơ chế chú ý hai chiều (bidirectional attention) bên trong từng khung đang hoạt động — nơi bất kỳ token nào cũng có thể tương tác với mọi token khác trong cùng một khối — vừa bảo đảm tốc độ xử lý song song, vừa đem lại khả năng tự hiệu chỉnh hoàn toàn mới. Nếu độ tin cậy của một token suy giảm trong quá trình khử nhiễu, bộ lấy mẫu (sampler) có thể tái tạo nhiễu cho token đó và để mô hình thử lại; đây là điều mà mô hình tự hồi quy không thể thực hiện về mặt cấu trúc một khi token đã được xác lập.
Thiết lập
Phần cứng: Tài liệu hướng dẫn của Google quy định cần GPU có bộ nhớ trên 60 GB, chẳng hạn như dòng card A100 hoặc H100, đối với mô hình đầy đủ chưa lượng tử hóa. Đối với việc vận hành cục bộ trên phần cứng phổ thông, phiên bản lượng tử hóa với yêu cầu bộ nhớ khoảng 18 GB VRAM là giải pháp khả thi trên các dòng card như RTX 4090 hoặc 5090.
Phần mềm:
# Cài đặt PyTorch và các thư viện cốt lõi khác
pip install torch accelerate
# Cài đặt thư viện transformers (yêu cầu phiên bản này hoặc mới hơn)
pip install "transformers>=5.11.0"
1
2
3
4
5
# Cài đặt PyTorch và các thư viện cốt lõi khác
p


Nguồn tin: Machine Learning Mastery — Tác giả: Shittu Olumide. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.