
Dạy kỹ thuật Jiu Jitsu cho LLM
Đường dẫn bài viết: https://maxdemarzi.com/2026/11/02/teaching-an-llm-a-little-jiu-jitsu/ Đường dẫn bình luận: https://news.ycombinator.com/item?id=50342859 Điểm: 1 Số bình luận: 0
Xây dựng mô hình LLM chuyên biệt cho môn Nhu thuật Brasil (Brazilian Jiu Jitsu)
Max De Marzi
Đồ thị, đồ thị và không gì ngoài đồ thị
Trang chủ
Giới thiệu
Liên hệ
Dịch vụ
Video
Ngày 02/11/2026
Để lại bình luận
Tác giả: maxdemarzi
Các vấn đề, RelationalAI
Huấn luyện kỹ thuật Nhu thuật cho mô hình LLM
Đầu năm nay, các kỹ sư tại Relational AI đã hỗ trợ tập đoàn AT&T xây dựng các mô hình LLM chuyên ngành viễn thông mang tên Otel và vươn lên vị trí dẫn đầu bảng xếp hạng. Thông tin chi tiết được cung cấp tại các liên kết trên. Bài viết này tập trung vào quy trình huấn luyện một mô hình LLM chuyên sâu về môn Nhu thuật Brasil (Brazilian Jiu Jitsu). Mục tiêu của dự án là tiếp nhận các câu hỏi cơ bản từ người mới tập luyện và cung cấp câu trả lời chuẩn xác, bảo đảm tính kiên nhẫn và tính sư phạm thực tế. Khác với quy trình đào tạo võ sinh trực tiếp tại các võ đường trong nhiều năm, các mô hình ngôn ngữ lớn (LLM) chỉ có thể tiếp thu tri thức thông qua dữ liệu ngôn ngữ và văn bản.
Nguồn tư liệu ban đầu bao gồm hàng nghìn video hướng dẫn chuyên đề chất lượng cao cùng hàng nghìn video trên nền tảng YouTube với các mức độ chi tiết khác nhau. Khác với các lớp học dành cho trẻ em vốn duy trì doanh thu trực tiếp cho các câu lạc bộ, đối tượng khách hàng trọng tâm của thị trường tài liệu kỹ thuật số là nam giới trung niên. Dữ liệu huấn luyện được thu thập từ hơn 50 khóa học chuyên đề trên BJJ Fanatics, kết hợp phương pháp của Jozef Chen và các video thi đấu thực tế có thuyết minh từ YouTube thông qua công cụ yt-dlp.
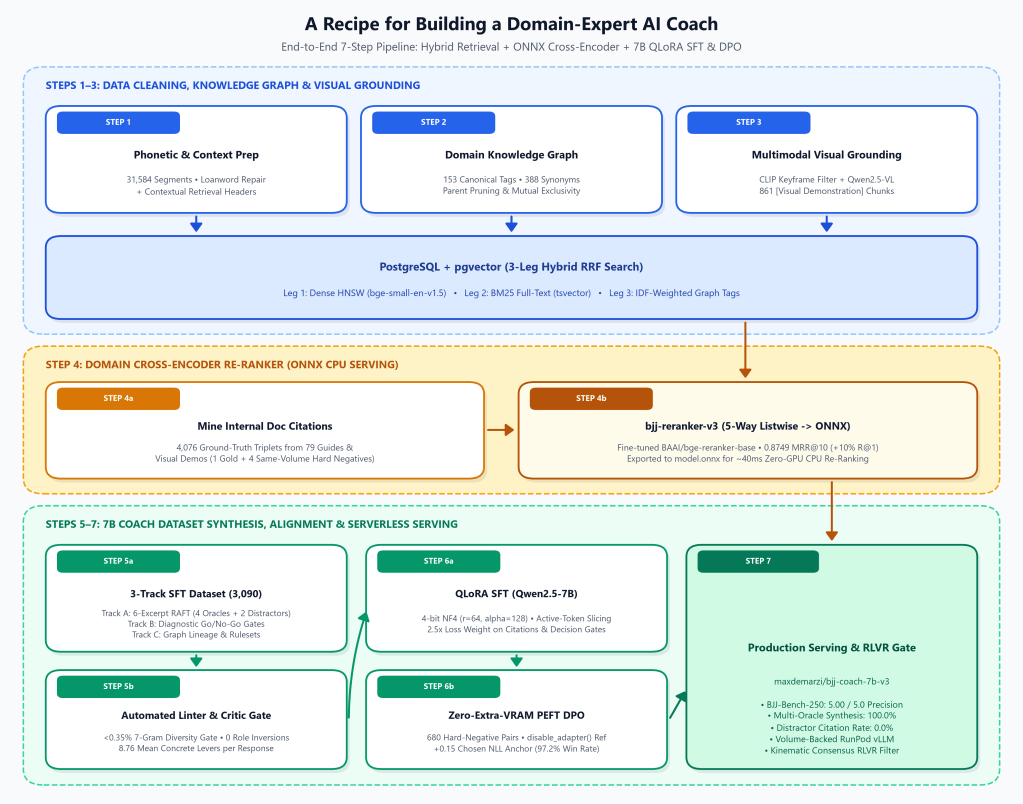
Nhằm tóm tắt quy trình tái lập hệ thống cho các kho tài liệu và video tương tự, các bước triển khai bao gồm:
Xử lý triệt để các lỗi nhận dạng phiên âm và gắn tiêu đề Truy xuất Ngữ cảnh ([Context: Tác giả — Nguồn | Danh mục | Thẻ]) trước khi nhúng (embedding).
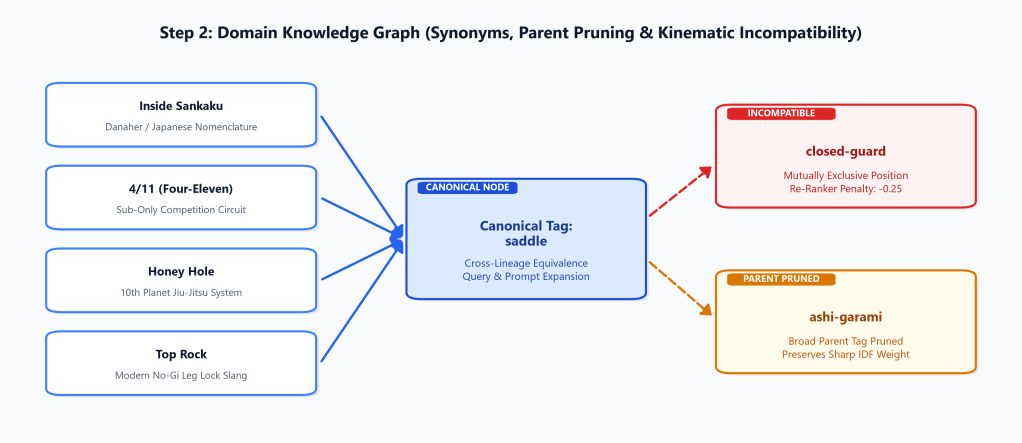
Xây dựng Đồ thị tri thức (Knowledge Graph) tường minh nhằm ánh xạ các thẻ chuẩn hóa, từ đồng nghĩa giữa các trường phái, hệ thống phân cấp thẻ cha-con và các quy tắc loại trừ lẫn nhau.
Kiểm duyệt các khung hình chính của video bằng mô hình CLIP kết hợp Mô hình Ngôn ngữ - Thị giác (Vision-Language Model), chuyển đổi các động tác thị phạm không lời thành các đoạn dữ liệu [Minh họa trực quan] có thể truy vấn.
Khai thác các liên kết có mốc thời gian từ tài liệu hiện có để tinh chỉnh mô hình xếp hạng lại (Re-Ranker) ONNX Cross-Encoder (bge-reranker-base) với hàm mất mát danh sách 5 chiều (5-way listwise loss).
Tổng hợp tập dữ liệu tinh chỉnh có giám sát (SFT) 3 nhánh (phương pháp RAFT 6 đoạn trích kèm dữ liệu gây nhiễu + các cổng chẩn đoán Đạt/Không đạt + phả hệ và quy tắc từ Đồ thị tri thức), đồng thời kiểm soát chất lượng bằng công cụ kiểm tra tự động 7-gram với ngưỡng <0,35%.
Thực hiện SFT bằng phương pháp QLoRA với trọng số quyết định 2,5 lần, tiếp nối bằng kỹ thuật DPO PEFT không tiêu tốn thêm VRAM (với lệnh model.disable_adapter(): + điểm neo NLL 0,15) trên một GPU đơn lẻ.
Kiểm định hệ thống dựa trên bộ tiêu chí đánh giá chuyên ngành và triển khai trên hạ tầng vLLM không máy chủ (serverless) có gắn bộ lưu trữ khối.
Phương pháp xây dựng trợ lý AI chuyên gia trong lĩnh vực hẹp
Giả sử hệ thống cần xử lý một kho tri thức chuyên ngành quy mô lớn—trong trường hợp này là khoảng 30.000 phân đoạn video hướng dẫn, 14.000 đoạn video thi đấu và 79 tài liệu kỹ thuật về Nhu thuật Brasil. Phương pháp xử lý tương tự cũng có thể áp dụng cho các lĩnh vực như quy trình phẫu thuật, bảo trì hàng không, robot công nghiệp hay luật thuế.
Khi người dùng đặt câu hỏi, mục tiêu là xây dựng một trợ lý AI đáp ứng các yêu cầu:
Sử dụng chuẩn xác thuật ngữ chuyên ngành (nhận diện được các thuật ngữ khác nhau từ các trường phái võ thuật cùng biểu thị một kỹ thuật).
Truy xuất chính xác các phân đoạn then chốt từ cả phần thuyết minh bằng lời nói lẫn các động tác thị phạm trực quan không kèm âm thanh.
Hệ thống tạo ra câu trả lời rõ ràng gồm nhiều đoạn văn với các trích dẫn nội dòng từ [1] đến [6], cho phép trình phát video chuyển trực tiếp đến đúng mốc thời gian, đồng thời loại bỏ các kết quả tìm kiếm gần đúng nhưng thiếu chính xác.
Hệ thống vận hành nhanh và tiết kiệm chi phí trên mô hình trọng số mở quy mô 7 tỷ tham số mà không phát sinh chi phí cho các API cao cấp (frontier API).
Việc kết nối trực tiếp phương thức tìm kiếm vector cơ bản với một mô hình 7B có sẵn sẽ dẫn đến các lời khuyên chung chung thiếu thực tế, các quy tắc sai lệch (hallucination) và cơ chế vận động học không chuẩn xác (chẳng hạn như hướng dẫn học viên xoay sai hướng để thoát khỏi đòn khóa gót heel hook).
Dưới đây là quy trình chi tiết từng bước được áp dụng để xây dựng maxdemarzi/bjj-coach-7b-v3 và bjj-reranker-v3, giúp bộ tiêu chuẩn đánh giá chuyên ngành (BJJ-Bench-250) đạt điểm số tuyệt đối 5,00 / 5,0 về độ chính xác động học (Kinematic Precision) với tỷ lệ trích dẫn gây nhiễu là 0,0%.
Nội dung quy trình cụ thể như sau.
Các thành phần cấu thành (Tổng quan kiến trúc)
Trước khi tiến hành thiết lập, hệ thống bao gồm các cấu phần sau:
Quá trình huấn luyện cả mô hình xếp hạng lại cross-encoder và mô hình ngôn ngữ 7B chỉ yêu cầu một GPU duy nhất (NVIDIA L40S, A40 hoặc A100 trên RunPod trong khoảng 30 phút).
Bước 1: Làm sạch dữ liệu sai lệch cục bộ và bổ sung tiêu đề ngữ cảnh
Bản ghi văn bản từ video thực tế thường chứa nhiều lỗi. Khi hướng dẫn trên sàn tập, huấn luyện viên thường hụt hơi và sử dụng nhiều thuật ngữ chuyên ngành mượn từ tiếng Nhật và tiếng Bồ Đào Nha. Các mô hình chuyển đổi giọng nói thành văn bản như Whisper thường nhận diện sai: "kimura" thành "camera", "De La Riva" thành "dealer river", "Danaher" thành "donna hair", "ashi garami" thành "oshi garami", và "inside sankaku" thành "inside sinkhole".
1a. Sửa lỗi nhận diện ngữ âm trước tiên
Không nên lãng phí năng lực xử lý của mô hình để huấn luyện LLM phỏng đoán các lỗi chính tả phát âm, trong khi các lỗi này có thể được xử lý triệt để ngay tại thời điểm tiếp nhận dữ liệu. Cần xây dựng một từ điển thay thế chuyên ngành và áp dụng lên các bản ghi thô trước khi thực hiện nhúng (embed) hoặc huấn luyện:
const PHONETIC_REPAIRS = [
[/\bcamera\b/gi, 'kimura'],
[/\bdealer river\b/gi, 'de la riva'],
[/\bdonna (?:her|hair)\b/gi, 'Danaher'],
[/\boshi garami\b/gi, 'ashi garami'],
[/\binside sinkhole\b/gi, 'inside sankaku'],
[/\bhonor roll\b/gi, 'honey hole'],
[/\bMarcelo team\b/gi, 'marcelotine'],
[/\b(?:uma|homo) plata\b/gi, 'omoplata'],
];
1b. Bổ sung tiêu đề truy xuất ngữ cảnh vào đầu đoạn trước khi nhúng
Một phân đoạn bản ghi video dài 60 giây thường chứa nhiều đại từ: "Khi người đó đẩy vào đây, tôi chuyển chân sang vị trí kia và khóa lại". Nếu đứng riêng lẻ, đoạn dữ liệu này hoàn toàn không thể hiện được tư thế đang diễn ra.
Trước khi tính toán các vector nhúng dày đặc (dense embeddings) (BAAI/bge-small-en-v1.5) hoặc f


Nguồn tin: Hacker News LLM — Tác giả: maxdemarzi. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.