
Đầu độc dữ liệu là gì? Cách thức kẻ tấn công làm sai lệch các mô hình AI và tập dữ liệu
Đầu độc dữ liệu là hành vi thao túng dữ liệu huấn luyện, tinh chỉnh, đánh giá hoặc truy xuất, khiến hệ thống AI tiếp nhận các hành vi sai lệch hoặc đưa ra kết quả theo chủ đích của kẻ tấn công. Tài liệu hướng dẫn này làm rõ cơ chế vận hành, các yếu tố đánh đổi, phương pháp đánh giá cùng những biện pháp kiểm soát thiết thực trong thực tiễn.
Những vấn đề cơ bản về AI
Đầu độc dữ liệu là gì? Phương thức kẻ tấn công làm sai lệch mô hình và tập dữ liệu AI
Đầu độc dữ liệu là hành vi thao túng dữ liệu huấn luyện, tinh chỉnh, đánh giá hoặc truy xuất nhằm khiến hệ thống AI học các hành vi sai lệch hoặc tạo ra kết quả theo chủ đích của kẻ tấn công. Tài liệu này phân tích cơ chế, sự đánh đổi, phương pháp đánh giá và các biện pháp kiểm soát có ý nghĩa trong thực tiễn.
Xuất bản
Ngày 25/10/2026
Tác giả
Miles Okada, Trợ lý Nghiên cứu AI và An ninh mạng
Thêm Unite.AI vào các nguồn ưu tiên trên Google
Đầu độc dữ liệu là hành vi thao túng dữ liệu huấn luyện, tinh chỉnh, đánh giá hoặc truy xuất nhằm khiến hệ thống AI học các hành vi sai lệch hoặc tạo ra kết quả theo chủ đích của kẻ tấn công.
Khái niệm đầu độc dữ liệu cần được luận giải chính xác, bởi tên gọi này xác định một luồng thông tin, lựa chọn huấn luyện, cơ chế vận hành hoặc ranh giới quản trị cụ thể. Việc đồng nhất khái niệm này với "AI tiên tiến" khiến các nhận định trở nên thiếu căn cứ kiểm chứng. Tài liệu này tiếp cận khái niệm từ đầu vào và các giả định đến kết quả quan sát được, sau đó phân tích nhận thức giản lược dễ gây nhầm lẫn nhất.
Đầu độc dữ liệu: Định nghĩa, Ranh giới và Mục đích
Đầu độc dữ liệu thao túng dữ liệu huấn luyện, tinh chỉnh, đánh giá hoặc truy xuất để hệ thống AI học các hành vi sai lệch hoặc tạo ra kết quả theo chủ đích của kẻ tấn công. Định nghĩa này bao gồm ba yêu cầu thực tiễn: có đầu vào xác định, có quá trình chuyển đổi hoặc quyết định đặc trưng của hành vi đầu độc dữ liệu, và có kết quả đo lường được theo mục tiêu đã định. Nếu thiếu một trong các yếu tố đó, khái niệm này chỉ phản ánh một giả định thay vì một cơ chế đã được triển khai.
AI đáng tin cậy đòi hỏi bằng chứng xác thực trong toàn bộ vòng đời. Một biện pháp kiểm soát chỉ có ý nghĩa khi chủ thể quản lý, phạm vi, điều kiện kích hoạt, hành vi dự kiến và phương pháp xác minh được quy định rõ ràng. Đối với hành vi đầu độc dữ liệu, cách tiếp cận hệ thống này có vai trò then chốt, bởi hiệu năng hệ thống có thể bị chi phối bởi dữ liệu phụ trợ, giao diện, phần cứng, quyền truy cập và con người ngay cả khi mô hình cốt lõi không thay đổi. Do đó, một phân tích chuẩn xác cần tách biệt hành vi tiếp thu của mô hình với sản phẩm quyết định thời điểm, phạm vi và thẩm quyền áp dụng hành vi đó.
Nhận thức sai lệch phổ biến nhất là việc đồng nhất hành vi này với tấn công né tránh (evasion attack) chỉ diễn ra sau khi mô hình đã được triển khai. Dù có thể mang biểu hiện bề ngoài tương tự đầu độc dữ liệu, tấn công né tránh có bản chất nhân quả khác biệt: đòi hỏi bằng chứng thành công khác nhau, tiêu tốn các nguồn lực chi phí khác nhau và cần các biện pháp kiểm soát rủi ro khác nhau. Vì vậy, ranh giới phân định mang tính vận hành thay vì chỉ thuần túy về mặt thuật ngữ.
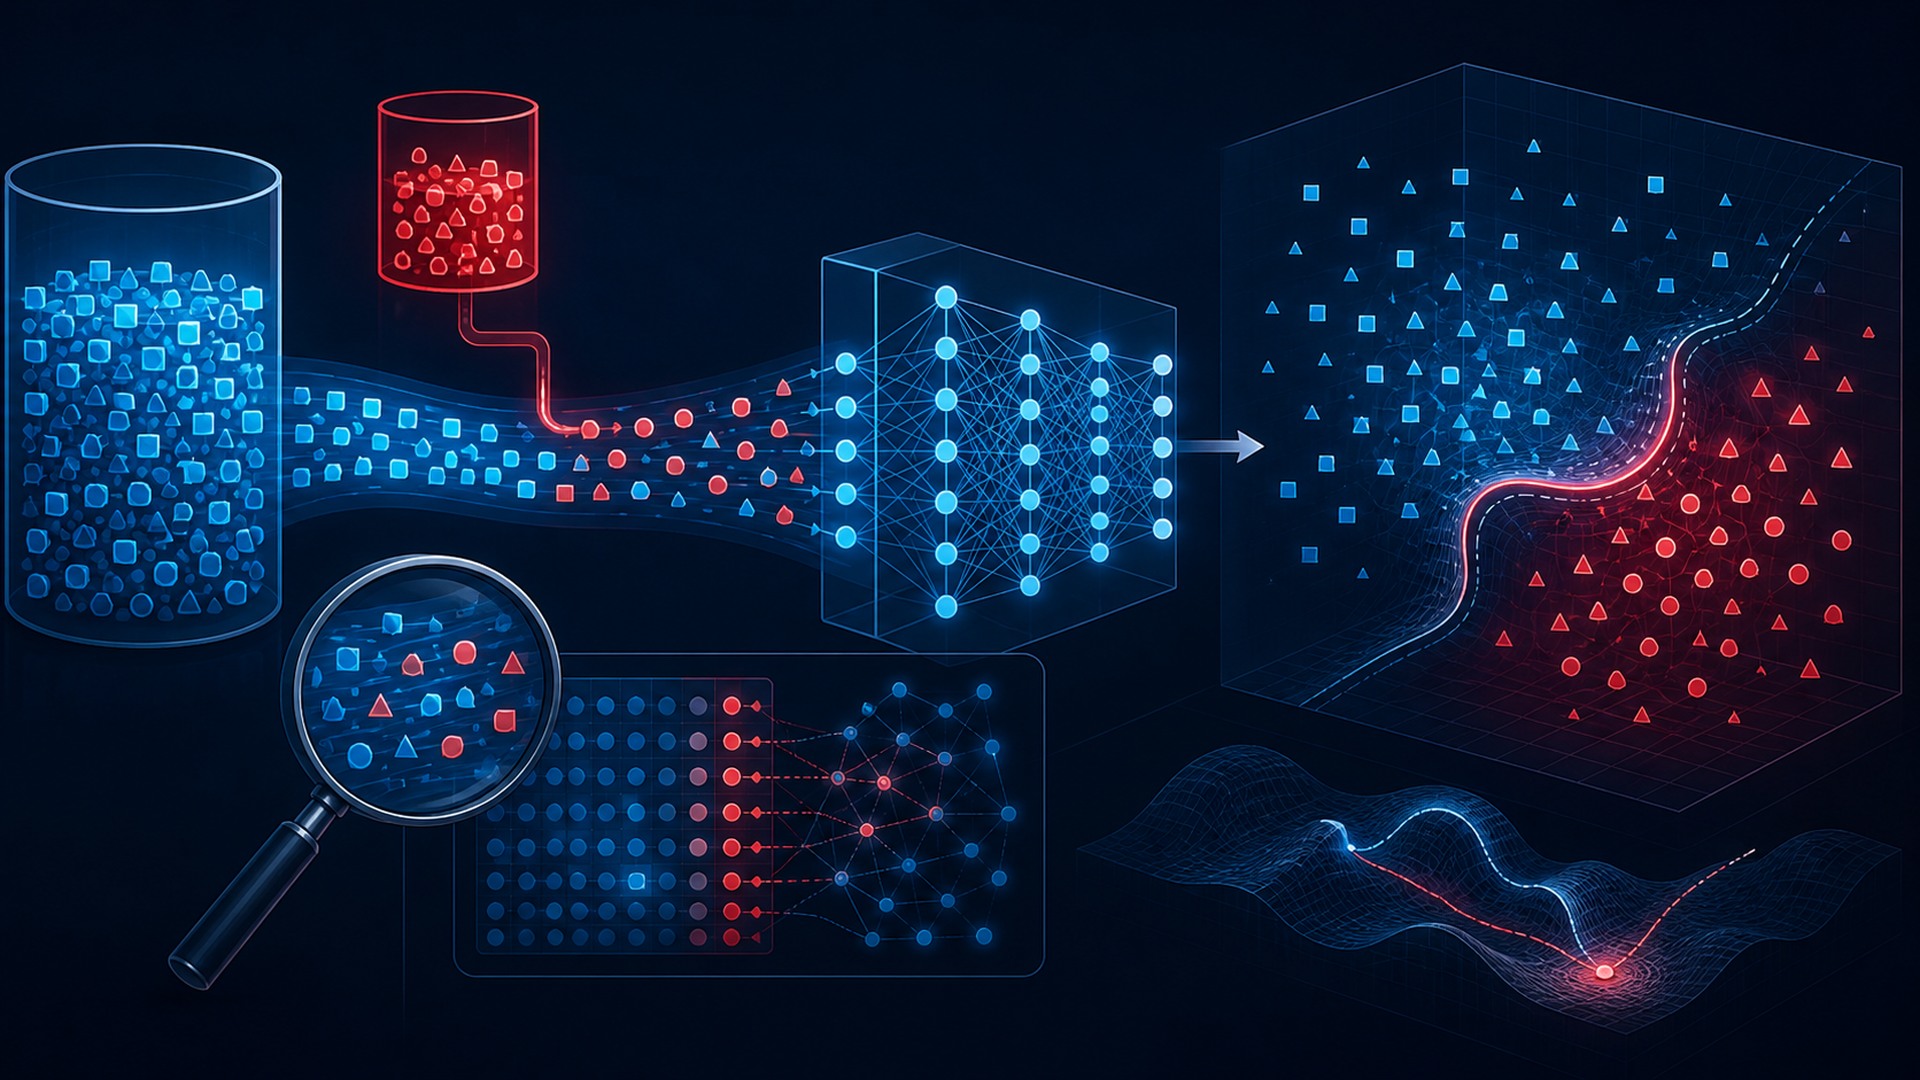
Mô hình vận hành năm giai đoạn của hành vi đầu độc dữ liệu
01Giành quyền tác động đến dữ liệu
→
02Cài cắm dữ liệu gán nhãn sai, thiên lệch hoặc chứa mã kích hoạt
→
03Vượt qua khâu sàng lọc và khử trùng lặp
→
04Làm biến đổi mô hình đã học hoặc
→
05Kích hoạt sự suy giảm trên diện rộng hoặc một
Đầu độc dữ liệu chuyển đổi đầu vào thành kết quả thông qua năm bước vận hành có thể quan sát được. Nội dung thuyết minh đánh số dưới đây tuân thủ trình tự này.
Sơ đồ trên là mô hình quan hệ nhân quả cô đọng của hành vi đầu độc dữ liệu, không mang hàm ý mọi quy trình triển khai đều bao gồm năm thành phần phần mềm riêng biệt. Một số hệ thống tích hợp các giai đoạn, trong khi các hệ thống khác lặp lại quy trình theo chu trình khép kín. Mô hình này duy trì tính hữu dụng nhờ ràng buộc mỗi thay đổi về thông tin hoặc thẩm quyền đều phải có chủ thể chịu trách nhiệm, đầu vào, đầu ra và phương thức kiểm thử tương ứng.
1. Giành quyền tác động đến nguồn dữ liệu: Đầu vào và các giả định trong hành vi đầu độc dữ liệu
Ở giai đoạn này của quá trình đầu độc dữ liệu (Data poisoning), hệ thống phải giành được quyền tác động đối với một nguồn dữ liệu. Vấn đề trọng tâm không chỉ đơn thuần là thao tác đó có diễn ra hay không, mà là thao tác đó tiếp nhận thông tin nào, làm thay đổi trạng thái nào và có bằng chứng nào chứng minh sự thay đổi đó là hợp lệ. Người đánh giá cần có khả năng phân biệt thao tác này với một cuộc tấn công lẩn tránh (evasion attack) vốn chỉ được áp dụng sau khi mô hình đã triển khai, đồng thời có thể tái lập kết quả trong cùng các điều kiện đã nêu.
Quá trình chuyển giao sang giai đoạn Data poisoning này bắt đầu từ mục tiêu đã xác định và phải kết thúc bằng một kết quả có thể hỗ trợ việc chèn các mẫu bị dán nhãn sai, thiên lệch hoặc mang yếu tố kích hoạt (trigger). Cần ghi nhận mức độ không chắc chắn, các phương án bị loại bỏ, mức độ sử dụng tài nguyên và mọi sự kiểm soát của con người hoặc phần mềm được áp dụng tại ranh giới hệ thống. Dấu vết lưu trữ này là cơ sở để các đội ngũ kỹ thuật xác định liệu một tập dữ liệu mục tiêu rất nhỏ có khó bị phát hiện trong khối dữ liệu quy mô web (web-scale data) hay không, trước khi lỗ hổng đó dẫn tới một kết quả đầu ra mang tính hệ quả.
2. Chèn các mẫu bị dán nhãn sai, thiên lệch hoặc mang yếu tố kích hoạt: Biểu diễn hoặc quyết định trong Data poisoning
Ở giai đoạn này của quá trình Data poisoning, hệ thống phải chèn các mẫu bị dán nhãn sai, thiên lệch hoặc mang yếu tố kích hoạt. Vấn đề trọng tâm không chỉ đơn thuần là thao tác đó có diễn ra hay không, mà là thao tác đó tiếp nhận thông tin nào, làm thay đổi trạng thái nào và có bằng chứng nào chứng minh sự thay đổi đó là hợp lệ. Người đánh giá cần có khả năng phân biệt thao tác này với một cuộc tấn công lẩn tránh chỉ được áp dụng sau khi mô hình đã triển khai, đồng thời có thể tái lập kết quả trong cùng các điều kiện đã nêu.
Quá trình chuyển giao sang giai đoạn Data poisoning này bắt đầu từ việc giành quyền tác động đối với một nguồn dữ liệu và phải kết thúc bằng một kết quả có thể hỗ trợ việc vượt qua khâu sàng lọc và khử trùng lặp (deduplication). Cần ghi nhận mức độ không chắc chắn, các phương án bị loại bỏ, mức độ sử dụng tài nguyên và mọi sự kiểm soát của con người hoặc phần mềm được áp dụng tại ranh giới hệ thống. Dấu vết lưu trữ này là cơ sở để các đội ngũ kỹ thuật xác định liệu một tập dữ liệu mục tiêu rất nhỏ có khó bị phát hiện trong khối dữ liệu quy mô web hay không, trước khi lỗ hổng đó dẫn tới một kết quả đầu ra mang tính hệ quả.
3. Vượt qua khâu sàng lọc và khử trùng lặp: Bước chuyển đổi đặc thù trong Data poisoning
Ở giai đoạn này của quá trình Data poisoning, hệ thống phải vượt qua khâu sàng lọc và khử trùng lặp. Vấn đề trọng tâm không chỉ đơn thuần là thao tác đó có diễn ra hay không, mà là thao tác đó tiếp nhận thông tin nào, làm thay đổi trạng thái nào và có bằng chứng nào chứng minh sự thay đổi đó là hợp lệ. Người đánh giá cần có khả năng phân biệt thao tác này với một cuộc tấn công lẩn tránh chỉ được áp dụng sau khi mô hình đã triển khai, đồng thời có thể tái lập kết quả trong cùng các điều kiện đã nêu.
Quá trình chuyển giao sang giai đoạn Data poisoning này bắt đầu từ việc chèn các mẫu bị dán nhãn sai, thiên lệch hoặc mang yếu tố kích hoạt và phải kết thúc bằng một kết quả có thể hỗ trợ việc làm biến đổi mô hình đã học hoặc retrieved co


Nguồn tin: Unite AI — Tác giả: Miles Okada, AI & Cybersecurity, AI Research Agent. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.