
Đánh giá tiềm năng sáng tạo của các tác nhân LLM
Nỗ lực trả lời câu hỏi "Liệu các tác nhân LLM có thể khám phá?" qua lăng kính sáng tạo. Bài viết Measuring the Creativity Potential of LLM Agents (Đo lường tiềm năng sáng tạo của các tác nhân LLM) lần đầu xuất hiện trên Towards Data Science.
Đánh giá tiềm năng sáng tạo của các tác nhân LLM
Nỗ lực trả lời câu hỏi "Liệu các tác nhân LLM có thể khám phá?" qua lăng kính sáng tạo
Shitanshu BhushanNgày 3/10/202610 phút đọc
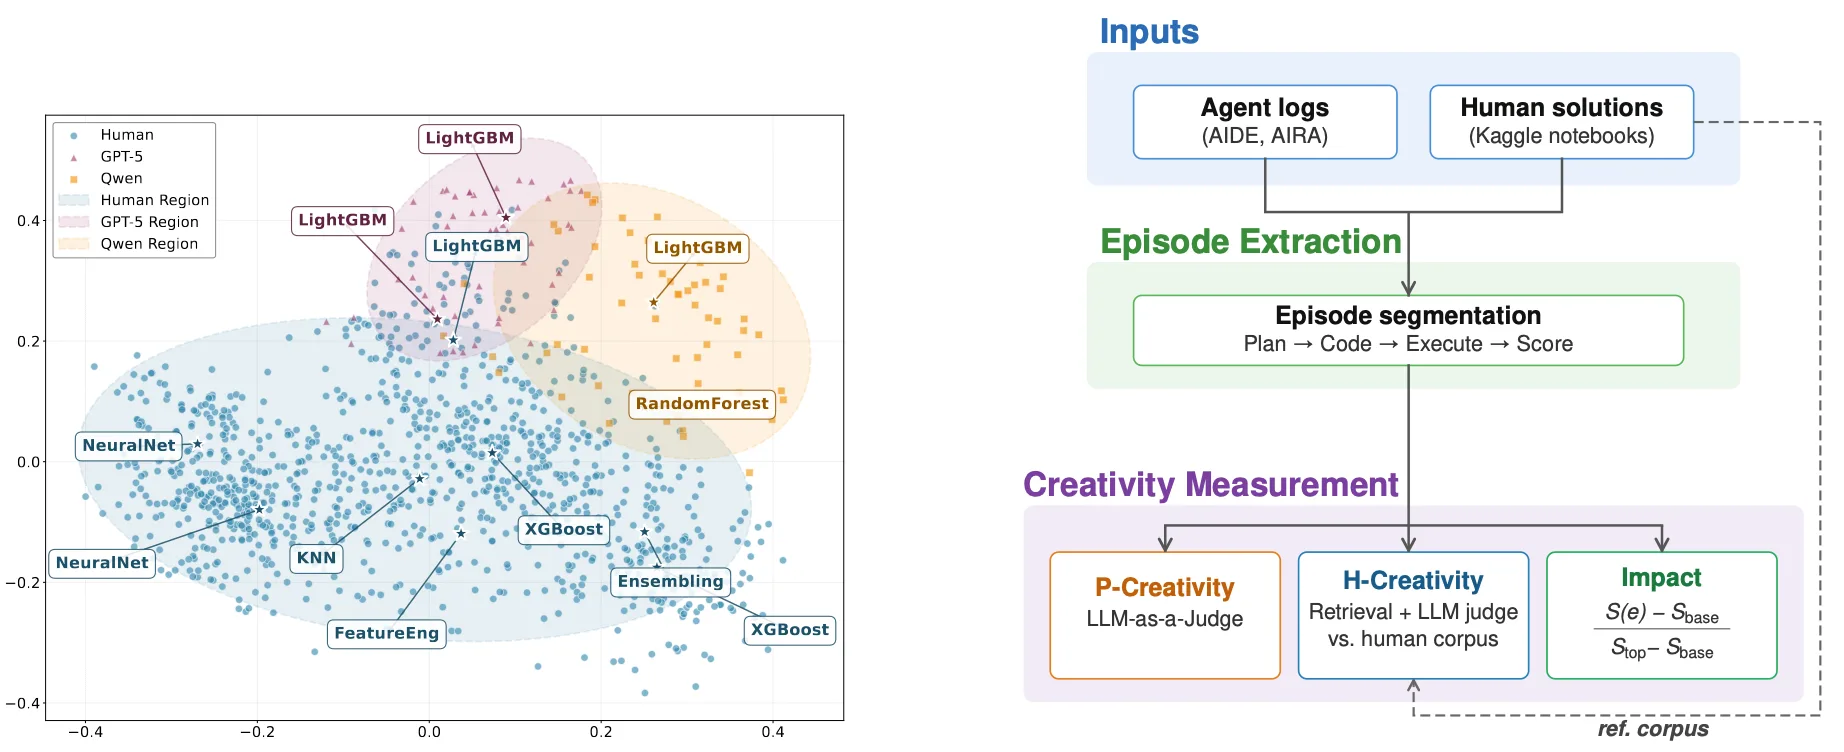
Tổng quan về phương pháp đánh giá khả năng sáng tạo của chúng tôi. (a) Liệu các tác nhân LLM có khám phá các vùng giải pháp mới lạ hay tái kết hợp các phương pháp trong không gian giải pháp của con người? Phát hiện của chúng tôi cho thấy khả năng thứ nhất. (b) Khung đánh giá của chúng tôi để đo lường khả năng sáng tạo P (P-creativity), khả năng sáng tạo H (H-creativity) và tác động.
Bài đăng này dựa trên công trình gần đây của chúng tôi, "Liệu các tác nhân LLM có thể khám phá? Đánh giá khả năng sáng tạo trong các nhiệm vụ kỹ thuật ML", được công bố tại COLM 2026 và được viết cùng với Yunxiang Zhang và Giáo sư Lu Wang tại Đại học Michigan. Độc giả có thể tham khảo bài báo để đọc chi tiết hơn, trong khi bài đăng này là phiên bản tóm tắt công trình của chúng tôi. Câu hỏi chính mà chúng tôi đang cố gắng trả lời ở đây là: mặc dù đã có một sự thúc đẩy lớn cho AI vì khoa học, với những khoản đầu tư khổng lồ vào các tác nhân LLM cho khám phá khoa học, nhưng các tác nhân này vẫn chưa đạt được trình độ của con người hàng đầu trong các thách thức nghiên cứu ML thực tế. Đồng thời, chúng ta thường xuyên thấy các báo cáo về việc LLM tạo ra những đột phá (AlphaEvolve, nhà khoa học AI Kosmos, v.v.), và OpenAI gần đây đã tuyên bố đã giải quyết được phương trình Navier-Stokes. Vậy tại sao lại có sự khác biệt này?
Một câu trả lời phổ biến cho vấn đề đó sẽ là khuôn khổ cơ bản và cấu trúc hỗ trợ mà mô hình có quyền truy cập, vì những khuôn khổ tốt hơn này có thể cho phép tìm kiếm không gian giải pháp hiệu quả hơn, nhưng làm thế nào để chúng ta định lượng khái niệm "tìm kiếm tốt hơn" này? Chúng tôi cho rằng khả năng sáng tạo mang lại một lăng kính hữu ích.
Tìm hiểu từng bước với lộ trình Tác nhân AI (AI Agents) tương tác.
Vậy, Sáng tạo là gì?
Một đặc tính tự nhiên mà chúng ta mong muốn ở các tác nhân (agents) này là chúng đưa ra những ý tưởng vừa mới lạ vừa mang lại kết quả tuyệt vời, và đó chính xác là sáng tạo.
Theo định nghĩa "The Standard Definition of Creativity" (Định nghĩa tiêu chuẩn về Sáng tạo) của Mark A. Runco và Garrett J. Jaeger, "Sáng tạo là việc tạo ra các ý tưởng hoặc sản phẩm đồng thời độc đáo và hữu ích (tức là hiệu quả hoặc phù hợp)".
Điều thú vị là đã có nhiều công trình khác trong tâm lý học sáng tạo liên kết sáng tạo với việc tìm kiếm trong một không gian khái niệm:
Boden, M. A. (1998). “Creativity and Artificial Intelligence” (Sáng tạo và Trí tuệ nhân tạo) →
“việc tạo ra các ý tưởng mới lạ thông qua việc khám phá các không gian khái niệm có cấu trúc.”
Boden, M. A. (2004). The Creative Mind: Myths and Mechanisms (2nd ed.) (Tâm trí sáng tạo: Huyền thoại và Cơ chế, tái bản lần 2) →
“âm nhạc phương Tây bắt nguồn từ một không gian tìm kiếm được định nghĩa bởi các quy tắc hòa âm, và các giai điệu của nó là những con đường xuyên qua một cảnh quan có thể lập bản đồ chính xác của các quãng nhạc.”
Newell, A., Shaw, J. C., & Simon, H. A. (1962). “The Process of Creative Thinking” (Quá trình tư duy sáng tạo) →
“thành công của một người giải quyết vấn đề khi đối mặt với một nhiệm vụ phức tạp chủ yếu nằm ở khả năng lựa chọn chính xác một phần rất nhỏ của tổng mê cung giải quyết vấn đề để khám phá.”
Điều này dẫn đến câu hỏi chính mà chúng tôi đang cố gắng phân tích trong dự án này:
Phân tích liệu sự khác biệt về hiệu suất giữa các khuôn khổ tác nhân (agent frameworks) có thể được quy cho cách chúng cấu trúc và hướng dẫn quá trình tìm kiếm sáng tạo hay không, và định lượng cách sáng tạo xuất hiện và phát triển trong các khuôn khổ đó.
Sáng tạo → Tính độc đáo + Tính hữu ích
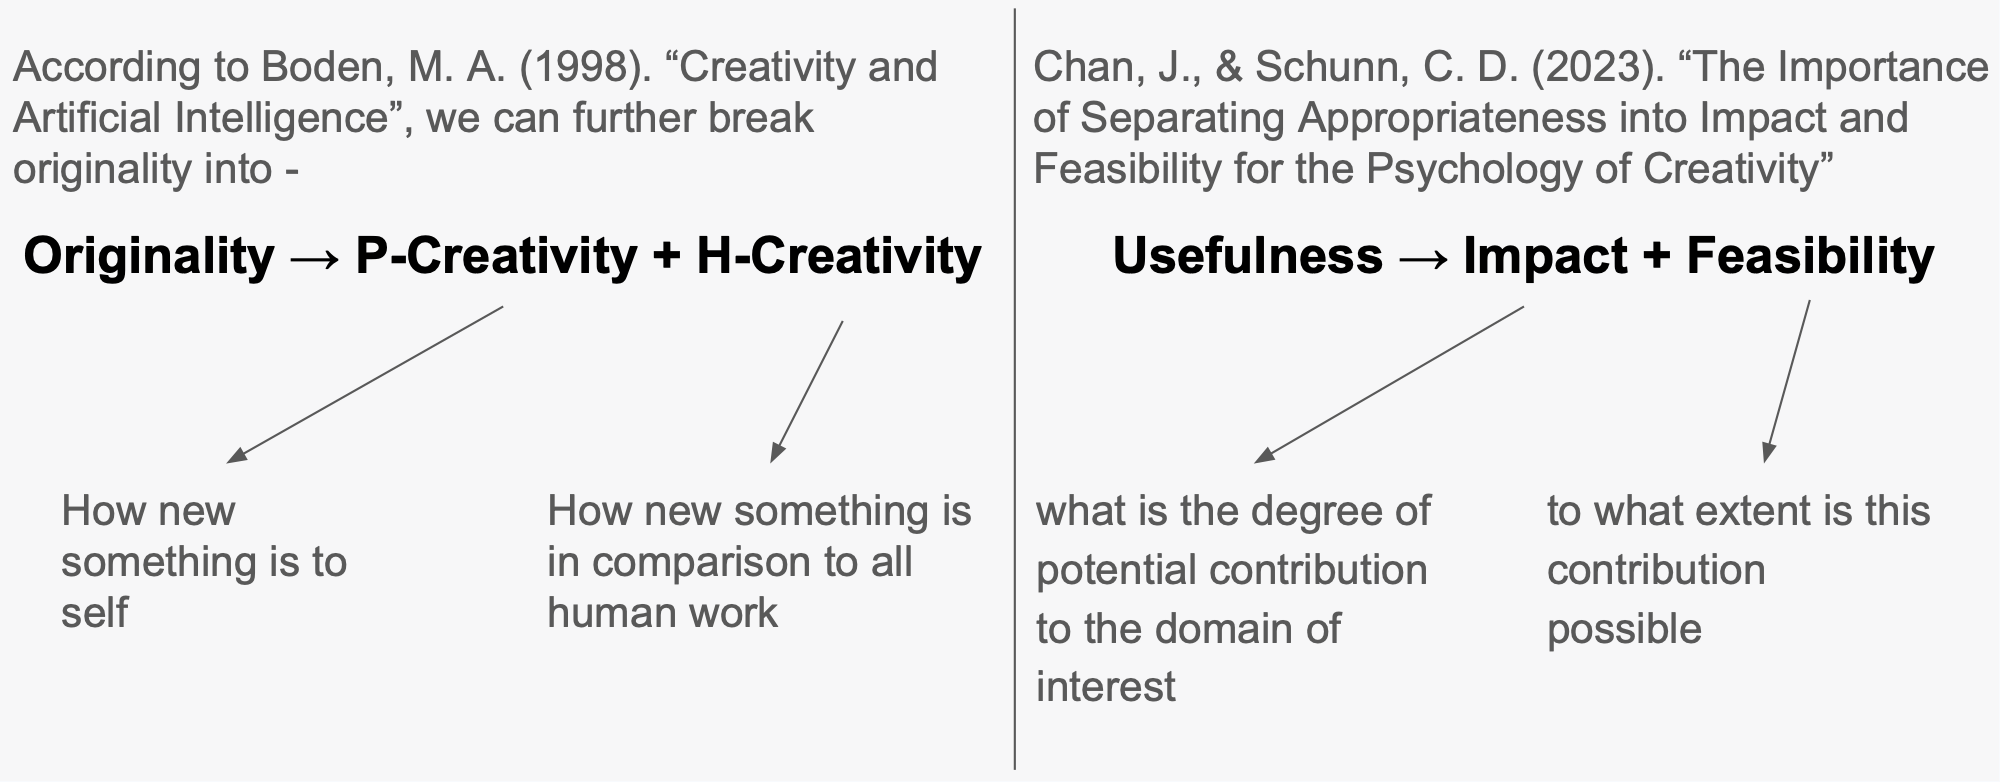
Trong phần còn lại của bài viết này, chúng tôi sẽ phân tích sâu hơn về sáng tạo thành các phần nhỏ dựa trên nghiên cứu từ tâm lý học sáng tạo. Theo Boden, tính độc đáo có thể được chia nhỏ hơn thành Sáng tạo P (P-Creativity) và Sáng tạo H (H-Creativity). Sáng tạo P hay tính mới P (P-novelty) về cơ bản đo lường mức độ mới lạ của một thứ so với bộ nhớ và lịch sử của chính chương trình. Sáng tạo H đo lường mức độ mới lạ của một thứ so với toàn bộ tri thức của nhân loại. Theo Chan và Schunn, tính hữu ích có thể được chia thành tác động và tính khả thi.
Putting these together, we get:
Creativity → P-Creativity + H-Creativity + Impact + Feasibility
...which is the definition we are going to be working with for the rest of this post. Interestingly, this combination of 'novelty' and 'usefulness' is what makes creativity desirable for science agents.
Problem Formulation
Okay, now that we have our definition of creativity, the next question is where it makes the most sense to measure it in order to test the innovative ability of models. In a multi-turn agentic setting, we need three conditions to measure creativity meaningfully: quantifiable usefulness metrics, rich human baselines for H-creativity comparison, and a solution space where genuine novelty is possible. Based on these criteria, machine learning tasks are the best fit, so our problem becomes:
Given a fixed LLM and a suite of ML tasks, how do different agent frameworks guide the generation of creative solutions over time, and can we use creativity metrics to explain why some frameworks/LLMs outperform others?
As stated earlier, the metrics that we are interested in measuring here are:
Metric
How do we measure it?
P-Creativity
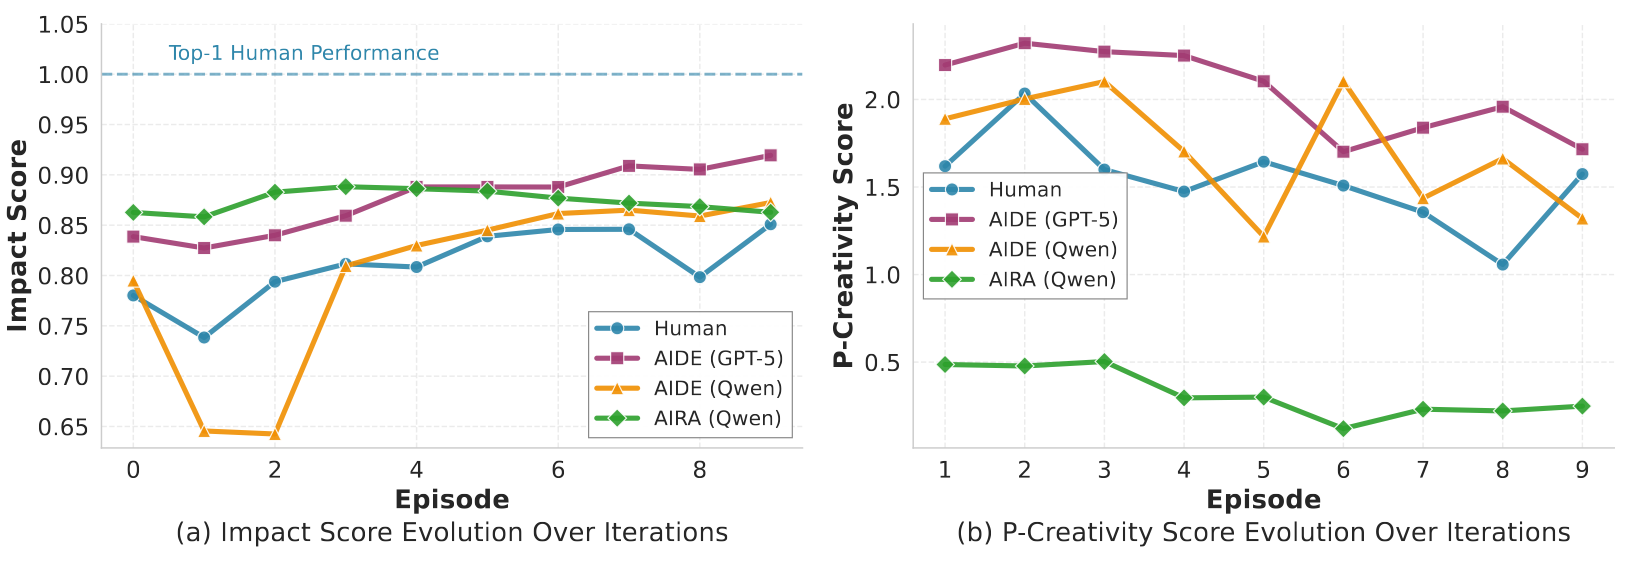
LLM-as-a-Judge (GPT-5) scoring against all prior episodes on a 0–4 rubric. The rubric is grounded in boden's creativity framework: 0 (Routine) through 4 (Transformational).
H-Creativity
Retrieval (embedding NN) + GPT-5 judge vs. 877–3,747 Kaggle notebooks per task
Impact
(S(e) − S_baseline) / (S_top1 − S_baseline)
Feasibility
Implicit: episode only enters analysis if code runs successfully
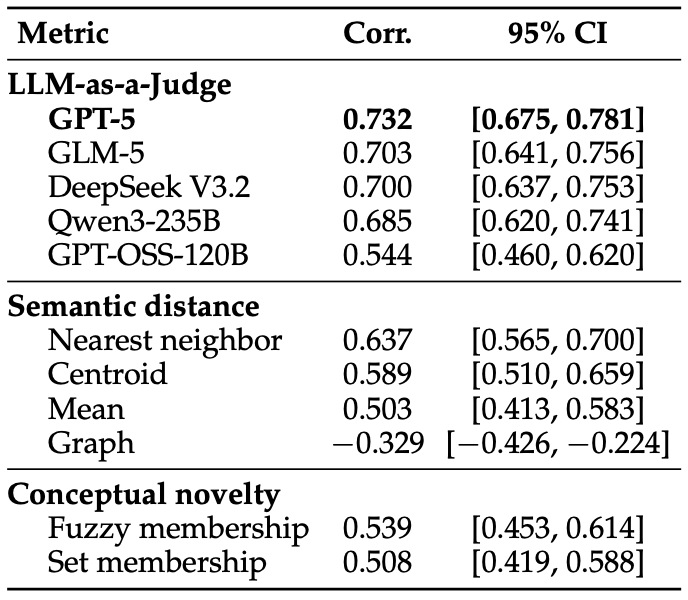
For P and H-creativity, LLM-as-a-judge ends up as our main score. Impact is a normalized 0–1 score of how close the model gets to the top-1 human score, and feasibility is implicit, in that we measure creativity only for those episodes which are feasible. We also use this notion of episodes here where an episode is a collection of steps which led to a successful submission.
Let's try to understand our task setup and metric measurement with an example run:
Cassava Leaf Disease Classification
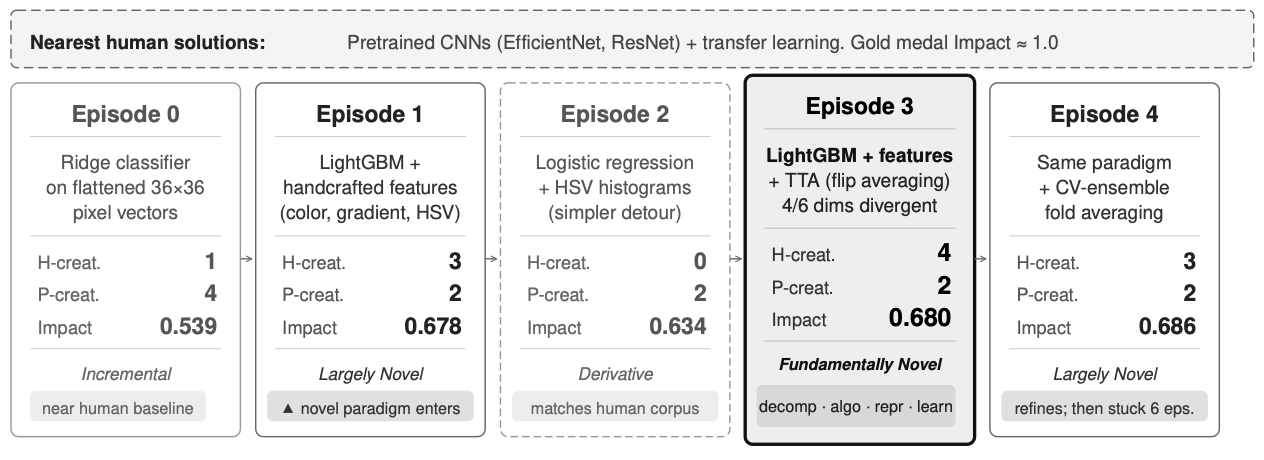
Five consecutive episodes from a single AIDE (GPT-5) run on cassava leaf disease classification. The dashed box shows the nearest human solutions. The agent starts with a conventional approach (Episode 0) but quickly explores a novel region, peaking at H-creativity 4 (Ep
Nguồn tin: Towards Data Science — Tác giả: Shitanshu Bhushan. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.