
Công cụ mã nguồn mở pg_vectorsearch nâng cao khả năng mở rộng tìm kiếm vector cho PostgreSQL
Tiger Data đã phát hành pg_vectorsearch, một tiện ích mở rộng mã nguồn mở dành cho PostgreSQL phục vụ tìm kiếm tương đồng vector, hiện đang ở giai đoạn thử nghiệm alpha. Chỉ mục PRISM của công cụ này áp dụng kỹ thuật phân vùng và nén dữ liệu thay vì phương pháp tiếp cận dựa trên đồ thị như chỉ mục HNSW của pgvector, qua đó giảm yêu cầu về bộ nhớ và rút ngắn thời gian xây dựng chỉ mục. Theo Renato Losio
Trang chủ InfoQ
Tin tức
Công cụ mã nguồn mở pg_vectorsearch nâng cao khả năng mở rộng tìm kiếm vector cho PostgreSQL
AI, ML và Kỹ thuật dữ liệu
Công cụ mã nguồn mở pg_vectorsearch nâng cao khả năng mở rộng tìm kiếm vector cho PostgreSQL
Ngày 07/11/2026
3
phút đọc
Tác giả
Renato Losio
Theo dõi chúng tôi trên
Youtube 232.000 người theo dõi
Linkedin 26.000 người theo dõi
Instagram Mới
RSS 19.000 độc giả
X 57.100 người theo dõi
Facebook 21.000 lượt thích
Bluesky Mới
Nghe bài viết này - 0:00
Âm thanh đã sẵn sàng phát
Trình duyệt không hỗ trợ thành phần âm thanh này.
0:00
0:00
Chuẩn 1,25x 1,5x
Thích
Danh sách đọc
Tiger Data vừa phát hành pg_vectorsearch, một tiện ích mở rộng mã nguồn mở dành cho PostgreSQL nhằm phục vụ tìm kiếm tương đồng vector, hiện đang trong giai đoạn thử nghiệm alpha. Chỉ mục PRISM của tiện ích này áp dụng phương pháp phân vùng và nén dữ liệu thay vì hướng tiếp cận dựa trên đồ thị như chỉ mục HNSW của pgvector, giúp giảm dung lượng bộ nhớ yêu cầu và rút ngắn thời gian khởi tạo chỉ mục.
Theo nhóm phát triển, pg_vectorsearch cho phép tìm kiếm vector nhanh hơn và tiết kiệm bộ nhớ hơn ngay trong PostgreSQL, qua đó giảm bớt hạ tầng cần thiết để xử lý các tập dữ liệu vector quy mô lớn. Tiện ích này hỗ trợ các cột pgvector hiện có, cho phép các ứng dụng thực hiện tìm kiếm vector mà không cần một hệ cơ sở dữ liệu riêng biệt. Để sử dụng các tính năng mới, các nhà phát triển cần cài đặt tiện ích mở rộng và khởi tạo chỉ mục PRISM trên cột vector:
CREATE EXTENSION pg_vectorsearch;
CREATE INDEX ON documents USING prism (embedding vec32_l2_ops);
Trong các thử nghiệm hiệu năng do Tiger Data thực hiện trên 100 triệu vector, PRISM hoàn thành khởi tạo chỉ mục trong 1 giờ 40 phút trên hệ thống có 128 GB bộ nhớ, trong khi HNSW (Hierarchical Navigable Small World) mất tới 42 giờ trên hệ thống có 512 GB bộ nhớ. Tiền thân là Timescale, Tiger Data là doanh nghiệp phát triển TimescaleDB, tiện ích mở rộng mã nguồn mở của PostgreSQL chuyên xử lý dữ liệu chuỗi thời gian và phân tích thời gian thực.
Ông Erik Nordström, kỹ sư cao cấp tại Tiger Data, ông Matvey Arye, kỹ sư trưởng tại Tiger Data, và ông Noah Hein, quản lý tiếp thị sản phẩm tại Tiger Data, cho biết:
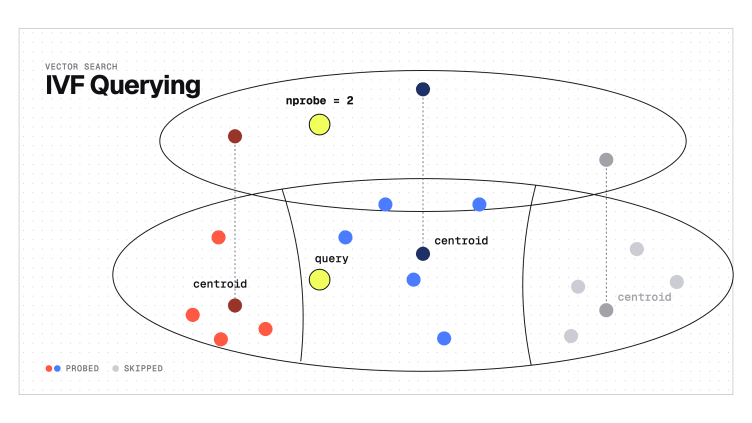
PRISM đưa phương pháp tiếp cận dựa trên phân vùng vào PostgreSQL, tương tự như giải pháp đang được các hệ thống tìm kiếm vector chuyên dụng thế hệ mới áp dụng. Thay vì liên kết từng vector với các vector lân cận trong một đồ thị, PRISM nhóm các vector tương đồng vào các phân vùng và lưu trữ dưới dạng danh sách nén được đóng gói mật độ cao trong các trang cơ sở dữ liệu.
Trong khi HNSW là thuật toán tìm kiếm láng giềng gần đúng giúp nhanh chóng xác định các vector tương đồng với truy vấn trên các tập dữ liệu lớn, PRISM thu hẹp phạm vi tìm kiếm vào các phân vùng phù hợp và quét tuần tự các vector đã nén. Cơ chế này giúp giảm kích thước chỉ mục và loại bỏ các tác vụ truy cập ngẫu nhiên gây tốn kém tài nguyên bộ nhớ hoặc đĩa cứng, từ đó nâng cao tốc độ tìm kiếm vector trực tiếp trong PostgreSQL với dung lượng RAM thấp hơn.
Ông Michael Freedman, đồng sáng lập kiêm Giám đốc công nghệ (CTO) của Tiger Data, đã công bố bài viết mô tả kiến trúc của chỉ mục vector PRISM. Chỉ mục trong pg_vectorsearch kết hợp phương pháp phân cụm phân cấp để thu hẹp không gian tìm kiếm, nén vector để tối ưu hóa việc quét tuần tự và áp dụng kỹ thuật lượng tử hóa RaBitQ nhằm giảm thiểu các phép tính khoảng cách tốn kém tài nguyên. Hệ thống thực hiện nhân bản các vector ở gần ranh giới phân vùng nhằm cải thiện độ bao phủ (recall), đồng thời vận hành dựa trên các cơ chế lưu trữ, ghi nhật ký và xử lý đồng thời nguyên bản của PostgreSQL.
Nguồn: Freedman trên LinkedIn
Tính năng tái cân bằng gia tăng (incremental rebalancing) hiện chưa được hoàn thiện, do đó việc dữ liệu thay đổi thường xuyên có thể đòi hỏi phải tái tạo chỉ mục nhằm duy trì hiệu quả tìm kiếm. Ông Freedman giải thích:
Vấn đề khó khăn hơn là việc duy trì cấu trúc phân cụm khi tập dữ liệu có sự biến động. Các trọng tâm (centroid) không tự động dịch chuyển khi có thêm vector mới, và các danh sách đăng tải (posting list) sẽ dần mất đi tính cục bộ vật lý ban đầu. Hiện tại, hệ thống mới chỉ hỗ trợ việc chia tách theo nhu cầu ở mức độ hạn chế đối với các danh sách đăng tải vượt kích thước cho chỉ mục phẳng, trong khi các thao tác tái cân bằng tổng quát hơn, bao gồm hợp nhất và gán lại dữ liệu, vẫn chưa được triển khai.
Trên một chủ đề thảo luận được quan tâm tại Hacker News, phản ứng chung của giới chuyên môn là chú ý về mặt kỹ thuật song vẫn giữ thái độ thận trọng. Các chuyên gia nhận thấy tiềm năng nâng cao tốc độ tìm kiếm vector với mức tiêu hao bộ nhớ thấp hơn ngay trong PostgreSQL, nhưng cũng đặt ra câu hỏi về việc kiểm chuẩn độc lập, khả năng pg_vectorsearch thay thế pgvectorscale, cũng như việc thiếu tính năng hỗ trợ tìm kiếm có bộ lọc. Ông Hermon Hagos bình luận:
Chi phí tìm kiếm vector vừa được hạ thấp (...) Đối với những nhà phát triển ứng dụng RAG trên một cơ sở dữ liệu duy nhất cùng nguồn ngân sách hạn hẹp, điều này có ý nghĩa rất thiết thực. Khả năng tìm kiếm ngữ nghĩa nhanh mà không cần khởi tạo một kho lưu trữ vector riêng biệt hay một máy chủ cấu hình lớn hơn mang lại hiệu quả tiết kiệm chi phí rõ rệt. Dự án vẫn đang ở giai đoạn thử nghiệm alpha, do đó chưa nên triển khai tới khách hàng, song đây là giải pháp cần theo dõi chặt chẽ.
Dù chưa được kiểm chứng độc lập, các thử nghiệm đối chuẩn của Tiger Data được thực hiện bằng công cụ mã nguồn mở, đo lường chỉ số recall@10 so với kết quả tìm kiếm chính xác, đồng thời so sánh cả hai loại chỉ mục trên cùng cấu hình PostgreSQL và cùng loại phiên bản máy chủ, sử dụng định dạng halfvec 16-bit của pgvector cho HNSW.
Tiện ích mở rộng vector mới yêu cầu PostgreSQL phiên bản 18 trở lên và hiện hỗ trợ các vector có tối đa 1.968 chiều. Tính năng tìm kiếm vector kết hợp bộ lọc giữa WHERE và ORDER BY hiện chưa được hỗ trợ cho đến phiên bản phát hành chính thức. Mã nguồn dự án đã được đăng tải trên GitHub. Tiger Data dự kiến sẽ chuyển tiện ích mở rộng pgvectorscale hiện có sang trạng thái bảo trì.
Về tác giả
Renato Losio
Xem thêmThu gọn
Đánh giá bài viết
Mức độ ứng dụng
Phong cách
Đã liên hệ tác giả
Nội dung này thuộc chủ đề AI, ML & Data Engineering
Nguồn tin: InfoQ AI — Tác giả: Renato Losio. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.