
Chống lại "rác" AI trong các bài báo khoa học
Trí tuệ nhân tạo (AI) đang thực hiện mọi việc ở quy mô lớn, từ việc thu thập dữ liệu web (web scraping) ở cấp độ tấn công từ chối dịch vụ (DoS) cho đến việc tạo ra hoặc hỗ trợ sản xuất một khối lượng lớn các bài nghiên cứu khoa học. Điều này đang dẫn đến một cuộc khủng hoảng về hậu cần và chất lượng, khi tỷ lệ tín hiệu trên nhiễu (signal-to-noise ratio) ngày càng trở nên khó kiểm soát. Tuần trước, máy chủ tiền bản in arXiv đã thông báo sẽ áp dụng chính sách giới hạn tốc độ mới đối với người gửi bài, theo đó mỗi người sẽ chỉ được gửi tối đa hai bài mỗi tháng. Biện pháp này được đưa ra, theo thông báo…
Góc nhìn của Anderson
Chống lại "rác" AI trong các bài báo khoa học
Xuất bản ngày 4/10/2026
Bởi Martin Anderson
Trí tuệ nhân tạo (AI) thực hiện mọi thứ ở quy mô lớn, từ việc cạo dữ liệu web (web scraping) ở cấp độ tấn công từ chối dịch vụ (DOS-attack) cho đến việc tạo ra hoặc hỗ trợ một lượng lớn các bài nộp nghiên cứu khoa học. Kết quả là điều này đang trở thành một cuộc khủng hoảng về hậu cần và chất lượng, khi tỷ lệ tín hiệu trên nhiễu (signal-to-noise ratio) ngày càng trở nên khó định hướng.
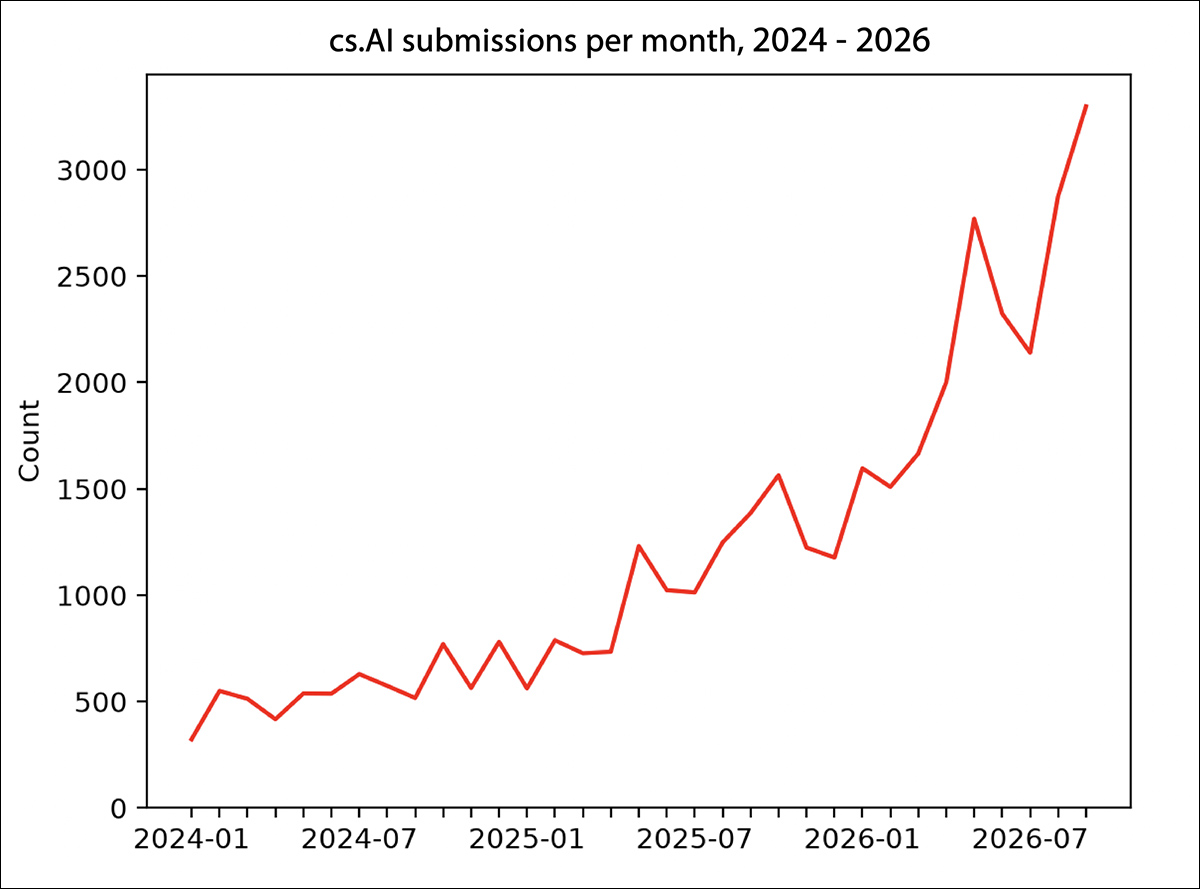
Tuần trước, máy chủ bài in sẵn arXiv đã thông báo sẽ áp dụng chính sách giới hạn tốc độ mới đối với người nộp bài, theo đó mỗi người sẽ chỉ được nộp tối đa hai bài mỗi tháng. Thông báo cho biết biện pháp này được đưa ra nhằm đối phó với sự gia tăng chóng mặt về số lượng bài nộp trong một khoảng thời gian ngắn:
Số lượng bài nộp hàng tháng vào danh mục cs.AI của arXiv từ tháng 1/2024 đến tháng 9/2026, cho thấy mức tăng hơn sáu lần trong giai đoạn này. Nguồn
Bài đăng trên blog của Kat Boboris thông báo về động thái này, vốn thu hút bình luận trên Hacker News vào thứ Năm tuần trước, cho biết arXiv đã nhận được 40.363 bài nộp vào tháng 9 năm 2026 – gần gấp đôi con số 20.569 bài nhận được vào tháng 9 năm 2024, và hơn bốn lần con số 9.869 bài nhận được vào tháng 9 năm 2016.
Bà Boboris nhận định, số lượng bài nộp trong tháng gần nhất cũng tạo ra gần 9.000 yêu cầu hỗ trợ cho nhân viên và người kiểm duyệt của arXiv:
“Các kiểm duyệt viên của chúng tôi đang nhận thấy sự gia tăng các bài viết mỏng, có phạm vi hẹp, cũng như các bài viết ‘cắt lát’ (salami papers), trong đó một công trình duy nhất được chia nhỏ và nộp dưới dạng một tập hợp các bài viết nhỏ hơn.
Cũng có sự gia tăng đáng kể các bài viết dày đặc, được viết bằng AI. Các công cụ AI đang giúp các tác giả dễ dàng tràn ngập arXiv và các kho lưu trữ khác bằng những bài viết có giá trị thấp này.”
Trước đó, vào tháng 5 năm nay, arXiv đã thực hiện biện pháp cấm một năm đối với nội dung AI không được kiểm duyệt; và vào tháng 10 năm ngoái, đã thông báo với những người nộp bài khảo sát và bài quan điểm (cả hai loại này đều có thể được tạo ra với ít nỗ lực hơn một nghiên cứu học thuật đầy đủ) rằng họ sẽ cần sự ủng hộ của đồng nghiệp để được xuất bản trên arXiv.
Hiện tại, việc giới hạn các yêu cầu http thường gây cản trở của tên miền arXiv không quá rõ ràng, và người ta chỉ có thể hy vọng rằng các nguồn cấp RSS rất hữu ích của nó sẽ tồn tại sau đợt cắt giảm này. Tuần trước, Reddit đã công bố việc loại bỏ hoàn toàn các nguồn cấp RSS của mình, điều này sẽ diễn ra từ giữa tháng tới. Tuy nhiên, tình trạng phi lợi nhuận của arXiv có nghĩa là có rất ít lợi ích tương tự có thể thu được bằng cách hướng người đọc vào các lượt truy cập trang web bắt buộc, hoặc đăng nhập cưỡng bức – ít nhất là vào thời điểm hiện tại.
**Chống lại làn sóng đang lên**
Trước những vấn đề nghiêm trọng và ngày càng tăng xung quanh tác động tiêu cực của việc sử dụng AI trong nghiên cứu khoa học – đặc biệt là liên quan đến nghiên cứu AI, vốn đã làm lu mờ tất cả các danh mục khác và vươn lên từ sự vô danh để trở thành một yếu tố chính trị và kinh tế, gần đây – một hướng nghiên cứu đã xuất hiện nhằm tìm cách chống lại sự suy giảm chất lượng của các bài nộp liên quan đến AI.
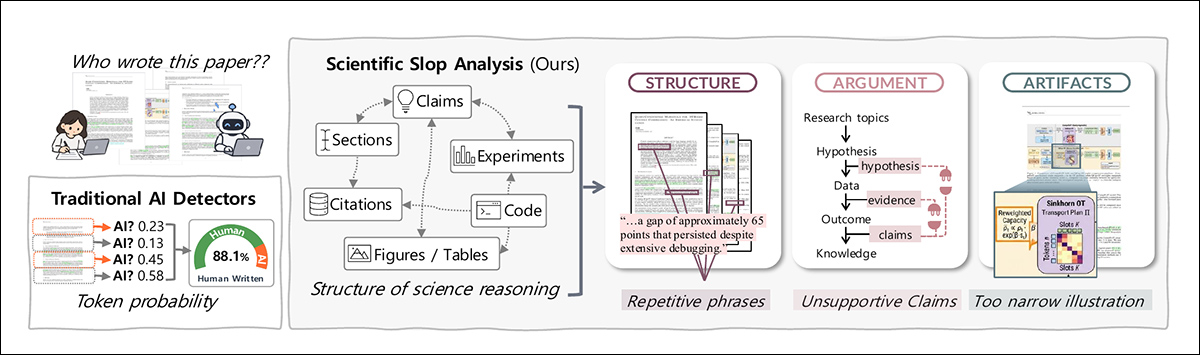
Công trình mới nhất giải quyết vấn đề này là sự hợp tác giữa Đại học Quốc gia Seoul của Hàn Quốc và Đại học Minnesota ở Hoa Kỳ. Bài báo, có tiêu đề "Science or Slop?: Benchmarking and Mitigating Scientific Slop in AI-Generated Papers" (Khoa học hay Rác rưởi?: Đánh giá và Giảm thiểu Rác rưởi Khoa học trong các Bài báo do AI tạo ra), đề xuất đo lường "rác rưởi khoa học" thông qua những thất bại trong mối liên hệ giữa các tuyên bố, bằng chứng, trích dẫn và cấu trúc của một bài báo:
Từ bài báo mới, một cái nhìn tổng quan về cách tiếp cận của công trình đối với "rác rưởi khoa học", cho thấy những thất bại trong cấu trúc, lập luận và các hiện vật hỗ trợ có thể bộc lộ những điểm yếu mà các công cụ phát hiện văn bản AI thông thường bỏ qua. Nguồn
Không giống các phương pháp tiếp cận trước đây, hệ thống mới xem xét vượt ra ngoài bản thân văn bản để đánh giá liệu các tuyên bố của bài báo có được hỗ trợ đúng đắn bởi các lập luận, bằng chứng và trích dẫn hay không. Các tác giả nêu rõ:
“Mỗi phần của một bài báo có thể có vẻ hợp lý khi đứng riêng lẻ, do đó những sự cố này không thể bị phát hiện bởi các công cụ dò tìm cấp độ token và chỉ có thể được xác định hoặc sửa chữa ở cấp độ toàn bộ bài báo. Để đánh giá và giảm thiểu tình trạng cẩu thả trong khoa học, bài báo này giải quyết ba thách thức.
Thứ nhất, các chỉ số cấp độ token không thể nắm bắt được cách thức lập luận khoa học kết nối xuyên suốt một bài báo. Các phần, tuyên bố, trích dẫn, bằng chứng và tài liệu có thể đều có vẻ hợp lý, trong khi mối quan hệ giữa chúng lại bị phá vỡ. Chúng tôi liên tục quan sát thấy những thất bại như vậy trong các bài báo do AI tạo ra từ đầu đến cuối, và các nhà phê bình ICLR đã phạt chúng ngay cả trong các bài nộp do con người viết.
Thứ hai, việc phát hiện các mẫu này vẫn chưa được đo lường. Các bộ dữ liệu thử nghiệm hiện có chỉ gắn nhãn văn bản, do đó mức độ mà các công cụ dò tìm, bao gồm cả các LLM đọc toàn bộ bài báo, xác định được các mẫu này chưa bao giờ được đo lường.
Thứ ba, các mẫu này khó có thể được giảm thiểu một cách đáng tin cậy. Trong khi các tín hiệu cấp độ token có thể được loại bỏ bằng cách diễn giải lại, việc sửa chữa các mẫu này đòi hỏi phải khôi phục các mối quan hệ bị thiếu mà không làm thay đổi khoa học cơ bản.”
Công cụ đánh giá mới của các tác giả, được đặt tên là SciSlopBench, đã được tích hợp vào SciSlopHarness, một khuôn khổ được thiết kế để phát hiện và sửa chữa các lỗi trong lập luận khoa học của một bài báo, đồng thời bảo toàn bằng chứng khoa học cơ bản:
Các ví dụ so sánh các đoạn văn bản lỗi với các bản sửa đổi do SciSlopHarness thực hiện. Các bổ sung không có căn cứ bị từ chối, trong khi các tuyên bố được sắp xếp lại hoặc viết lại khi cần thiết để phản ánh tốt hơn bằng chứng có sẵn trong bài báo.
Bản thân công cụ đánh giá SciSlopBench được xây dựng từ 390 bài báo do AI tạo ra, mỗi bài được ghép nối với một bài báo do con người viết giải quyết vấn đề nghiên cứu và loại đóng góp tương tự.
Trong các thử nghiệm, SciSlopBench được sử dụng để phân biệt giữa 390 cặp bài báo, với mỗi cặp bao gồm bài báo do AI tạo ra đã đề cập ở trên và một bài báo do con người viết được ghép nối theo vấn đề nghiên cứu và loại đóng góp. Công cụ đánh giá đã xác định chính xác bài báo do AI tạo ra trong 85,9% các so sánh này, vượt trội đáng kể so với các công cụ dò tìm văn bản AI thông thường.
Các tác giả nêu rõ:
“Trong khi các bản sửa đổi tiêu chuẩn để lại sự cẩu thả còn sót lại và việc nhắc nhở trực tiếp có ý thức về sự cẩu thả kích hoạt phần thưởng


Nguồn tin: Unite AI — Tác giả: Martin Anderson. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.