
Chất lượng hàng đầu với 1% chi phí: Đánh giá hiệu năng thực tế của các mô hình phân loại LLM
Đường dẫn bài viết: https://airbnb.tech/ai-ml/frontier-quality-at-1-of-the-cost-a-production-benchmark-of-llm-classifiers/ Đường dẫn bình luận: https://news.ycombinator.com/item?id=50391660 Điểm: 3 Số bình luận: 0
Mô hình E2B sau tinh chỉnh (fine-tuned) đã được đưa vào thử nghiệm đối chuẩn (benchmark) với các API tiên tiến hàng đầu trong một tác vụ phân loại thực tế ở môi trường vận hành. Kết quả cho thấy mô hình này đạt chất lượng tương đương trong thời gian dưới 100 ms, với mức chi phí chỉ bằng khoảng một phần một trăm.
Tác giả: Clay Gibson, Adel Elmalaha
Tại Airbnb, các mô hình AI được ứng dụng cho các tác vụ phân loại, bao gồm phát hiện nội dung rủi ro do người dùng đăng tải, xác định nguyên nhân khách hàng liên hệ bộ phận hỗ trợ và nhận diện các chủ đề trong phần đánh giá. Những tác vụ này đòi hỏi khả năng hiểu ngôn ngữ tinh tế cùng tư duy phán đoán thông thường để suy luận những hàm ý chưa được diễn đạt rõ ràng.
Các mô hình tiên tiến hàng đầu, với quy mô hàng trăm tỷ tham số và được tiền huấn luyện trên dữ liệu cấp độ toàn mạng internet, thường thể hiện hiệu quả cao ở những tác vụ này. Tuy nhiên, đối với các sản phẩm tương tác và khối lượng xử lý lớn, độ chính xác mới chỉ đáp ứng một phần yêu cầu. Hệ thống còn đòi hỏi độ trễ thấp, chi phí vận hành ở mức kiểm soát được, cùng khả năng cân đối giữa tỷ lệ dương tính giả và âm tính giả.
Các mô hình trọng số mở (open-weight) quy mô nhỏ hơn cho tốc độ xử lý nhanh hơn và chi phí vận hành tiết kiệm hơn khi triển khai trên diện rộng. Thông qua việc trích xuất xác suất log (logprobs), hệ thống có thể tạo điểm số để thiết lập ngưỡng phân loại. Dù vậy, các mô hình nhỏ này được huấn luyện để xử lý phạm vi hội thoại rất rộng, trong khi các tác vụ cụ thể của hệ thống chỉ chiếm một phần rất nhỏ trong phân phối huấn luyện đó. Khi sử dụng trực tiếp mà không qua tùy biến, các mô hình này thường bỏ qua những chi tiết phân biệt tinh tế vốn có ý nghĩa quyết định đối với sản phẩm.
Việc tối ưu hóa câu lệnh (prompting) cũng tồn tại những giới hạn nhất định. Điều này tương tự như bài tập thực hành thường gặp ở bậc tiểu học: viết hướng dẫn cách làm món bánh mì kẹp bơ đậu phộng và mứt. Nếu chỉ viết "cắm dao vào lọ bơ đậu phộng", người thực hiện có thể đâm xuyên qua vỏ lọ hoặc cắm phần cán dao thay vì lưỡi dao. Thực tế cho thấy khó có chỉ dẫn nào đủ chi tiết để ngăn ngừa mọi sự thiếu sót về mặt tư duy thông thường.
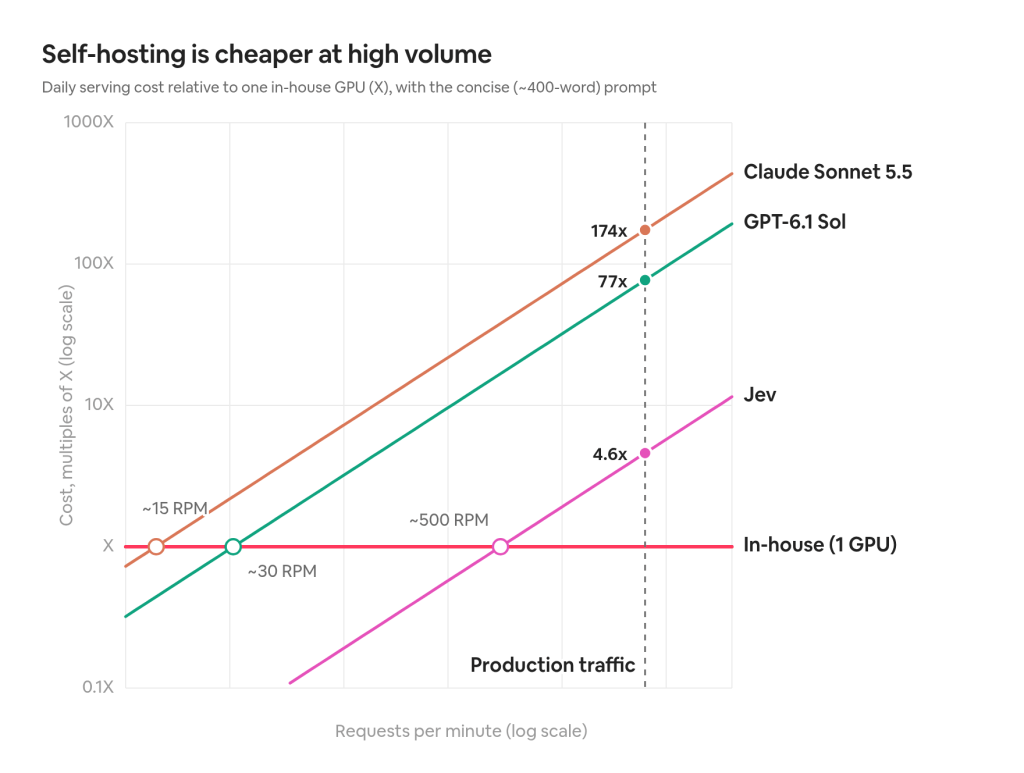
GLOWC, khung làm việc nội bộ do các kỹ sư tại Airbnb phát triển, giúp đơn giản hóa quy trình tinh chỉnh các mô hình ngôn ngữ (và mô hình thị giác-ngôn ngữ) trọng số mở thành các bộ phân loại có tốc độ cao và độ chính xác lớn. Báo cáo này tiến hành đối chuẩn trực tiếp một trong những bộ phân loại nói trên với các mô hình trọng số mở và mô hình độc quyền thương mại, cho thấy mô hình đạt chất lượng tương đương các mô hình hàng đầu trong thời gian dưới 100 ms với chi phí chỉ xấp xỉ 1%.
Nghiên cứu tình huống: Đánh giá đối chuẩn bộ phân loại trong môi trường vận hành
Các phép đo chuẩn công khai hiếm khi phản ánh đúng những ràng buộc của sản phẩm trong môi trường thực tế. Do đó, thử nghiệm được thực hiện trên một bộ phân loại vận hành chuyên kiểm duyệt nội dung vi phạm chính sách của Airbnb về tính minh bạch trong định giá và thanh toán. Tác vụ này đòi hỏi nhận diện các ranh giới chính sách phức tạp với độ chuẩn xác cao, bởi lỗi dương tính giả sẽ ngăn chặn các nội dung hợp lệ được đăng tải. Mô hình tiếp nhận hàng nghìn lượt gọi mỗi phút và do phải kiểm soát việc đăng tải theo thời gian thực, kết quả chấm điểm bắt buộc phải trả về trong vòng 200 ms.
Thử nghiệm tiến hành so sánh bộ phân loại tinh chỉnh với 2 tỷ tham số hiệu dụng (E2B) với các mô hình trọng số mở và mô hình độc quyền trên tập dữ liệu đánh giá độc lập gồm 10.000 mẫu có gán trọng số. Mô hình tinh chỉnh được huấn luyện trên các mẫu dữ liệu đã ẩn danh từ những người dùng không từ chối chia sẻ dữ liệu cho đào tạo AI. Các mô hình trọng số mở được tự lưu trữ bằng công cụ vLLM 0.28.0 trên một GPU NVIDIA RTX Pro 6000 duy nhất. Các mô hình có quy mô đến 12B tham số hoạt động ở định dạng bfloat16; các mô hình lớn hơn sử dụng các điểm kiểm tra (checkpoint) định dạng FP8 hoặc NVFP4 sẵn có công khai. Các mô hình độc quyền được gọi thông qua API của nhà cung cấp. Trừ khi có ghi chú khác, tất cả các mô hình đều nhận cùng một câu lệnh súc tích khoảng 400 từ.
Chất lượng và độ trễ
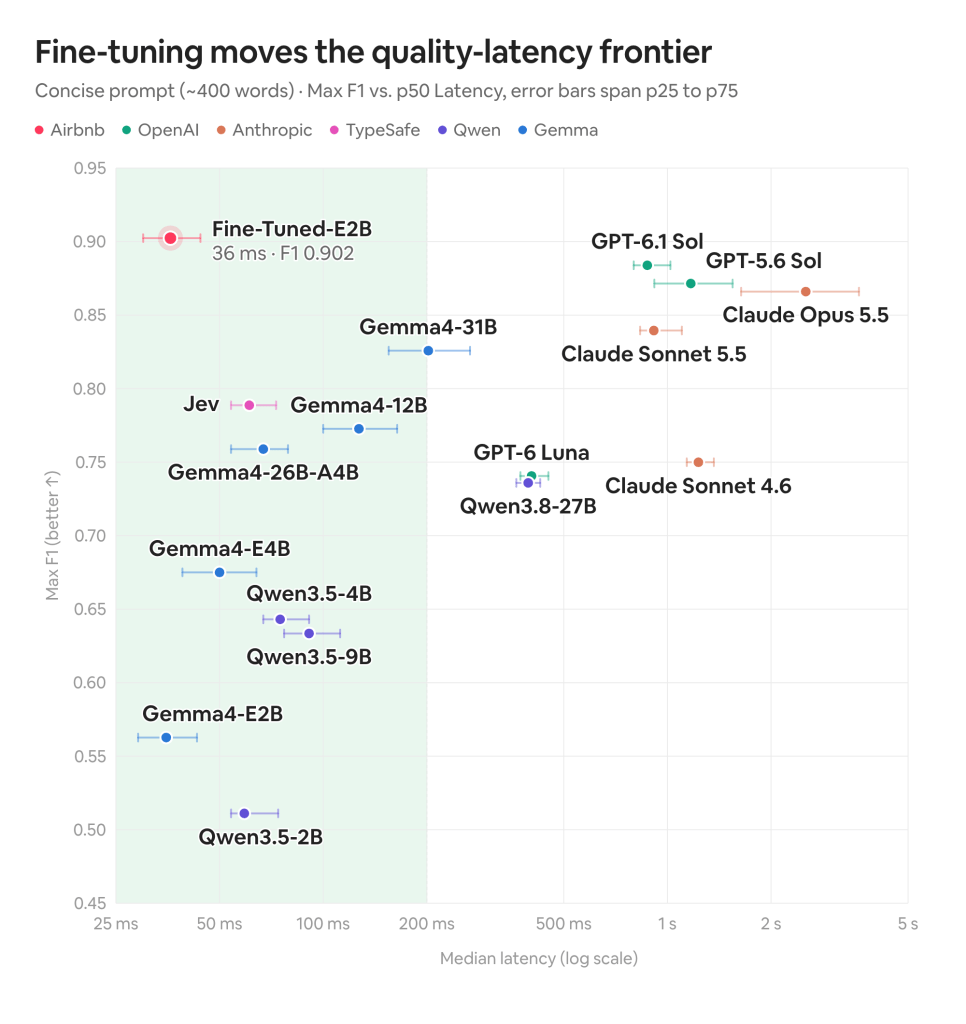
Mọi mô hình được triển khai đều phải bảo đảm đủ độ chính xác để đưa ra quyết định chính sách tin cậy, đồng thời phải đủ nhanh để không làm gián đoạn trải nghiệm của người dùng. Hai tiêu chí này thường có sự đánh đổi lẫn nhau, tạo nên ranh giới giữa chất lượng và độ trễ như thể hiện ở biểu đồ dưới đây.
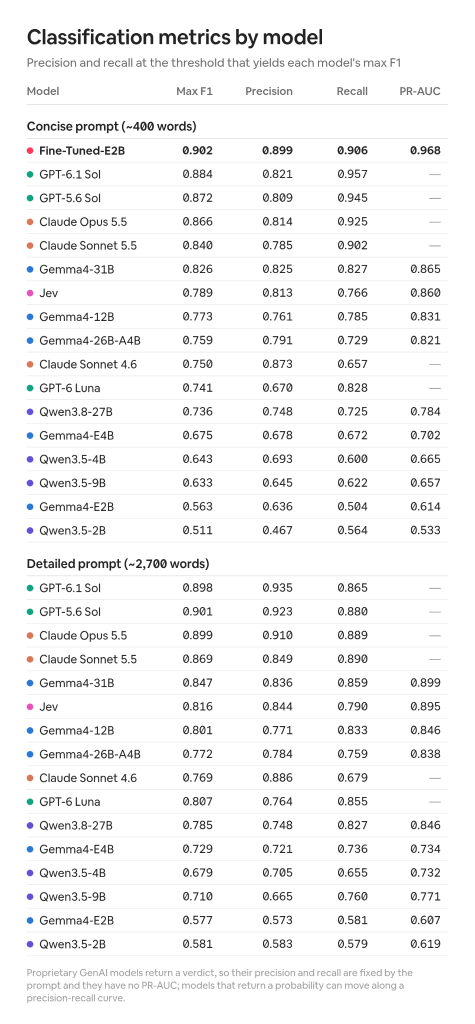
Chỉ số F1 tối đa (max F1) được sử dụng làm thước đo chất lượng phân loại. Thông thường, diện tích dưới đường cong Precision-Recall (PR-AUC) được ưu tiên đối với các bài toán phân loại mất cân bằng dữ liệu. Tuy nhiên, phần lớn các mô hình độc quyền chỉ trả về kết quả Đúng (True) hoặc Sai (False), do đó không có đường cong để tính tích phân. Chỉ số F1 tối đa đưa cả hai nhóm mô hình về cùng một hệ quy chiếu: đối với các mô hình mở trọng số (open-weight) và mô hình ra quyết định (decision models), ngưỡng phân loại được quét trên toàn dải giá trị để chọn ra điểm F1 cao nhất; đối với các mô hình độc quyền khác, chỉ số F1 được tính trực tiếp từ kết luận trả về. Kết luận chung không phụ thuộc vào phương pháp đánh giá: các chỉ số PR-AUC (ở những mô hình có hỗ trợ) và độ chính xác (accuracy) cho thứ hạng mô hình gần như tương đồng với max F1. Độ trễ được xác định là thời gian xử lý phía máy chủ, do cổng điều phối dịch vụ (serving gateway) ghi nhận.
Các mô hình mở trọng số có tốc độ xử lý nhanh nhưng phải đánh đổi chất lượng. Nhiều mô hình mở trọng số có độ trễ thấp hơn giới hạn cho phép. Chất lượng phân loại và độ trễ có xu hướng tăng tỷ lệ thuận với quy mô mô hình. 2 Khi sử dụng nguyên bản, hiệu năng của nhóm này đạt mức bão hòa thấp hơn đáng kể so với các mô hình độc quyền tốt nhất hoặc bộ phân loại đã qua tinh chỉnh (fine-tuning).
Các mô hình tạo sinh độc quyền đạt độ chính xác cao nhưng tốc độ chậm và thiếu tính linh hoạt. Chất lượng phân loại của nhóm này không cải thiện đáng kể khi tăng thời gian suy luận, do đó dữ liệu được ghi nhận ở chế độ suy nghĩ thấp (low-thinking). Ngay cả ở chế độ này, GPT-6.1 Sol và Claude Sonnet 5.5 vẫn có độ trễ trung vị khoảng 900 mili-giây và độ trễ p99 lên tới nhiều giây, vượt nhiều lần giới hạn cho phép. GPT-6 Luna là mô hình tạo sinh độc quyền nhanh nhất trong thử nghiệm, song vẫn chậm hơn và kém chính xác hơn so với Gemma4-31B khi vận hành trên một GPU đơn lẻ. Do mỗi mô hình chỉ trả về một kết luận thay vì điểm số xác suất, hệ thống chỉ nhận được một điểm cố định trên đồ thị precision-recall. Với câu lệnh (prompt) ngắn gọn, GPT-6.1 Sol đạt độ chính xác (precision) 0,82 và độ thu hồi (recall) 0,96, thiên về độ thu hồi trong một tác vụ mà các trường hợp dương tính giả gây tổn thất lớn. Việc điều chỉnh điểm cân bằng này đòi hỏi phải viết lại toàn bộ câu lệnh.
Các mô hình ra quyết định đạt hiệu năng cao tương ứng với tốc độ xử lý. Mô hình Jev của TypeSafe trả về giá trị xác suất thay vì tạo kết luận văn bản, nhờ đó không bị hạn chế bởi quá trình tạo token và có thể thiết lập ngưỡng tương tự bộ phân loại nội bộ. Đây là mô hình nguyên bản có độ chính xác cao nhất trong nhóm có độ trễ dưới 100 mili-giây được thử nghiệm.
Phương pháp tinh chỉnh (fine-tuning) giúp mở rộng ranh giới tối ưu giữa chất lượng và độ trễ thay vì phải đánh đổi giữa hai yếu tố này. Việc tinh chỉnh Gemma4-E2B trên hàng trăm nghìn mẫu dữ liệu chuyên ngành đã nâng chỉ số F1 từ 0,563 lên 0,902, tương đương các mô hình độc quyền hàng đầu, trong khi độ trễ trung vị vẫn duy trì ở mức 35 mili-giây. Không có mô hình nào khác trong thử nghiệm đạt được hiệu quả tiệm cận trên cả hai tiêu chí này.
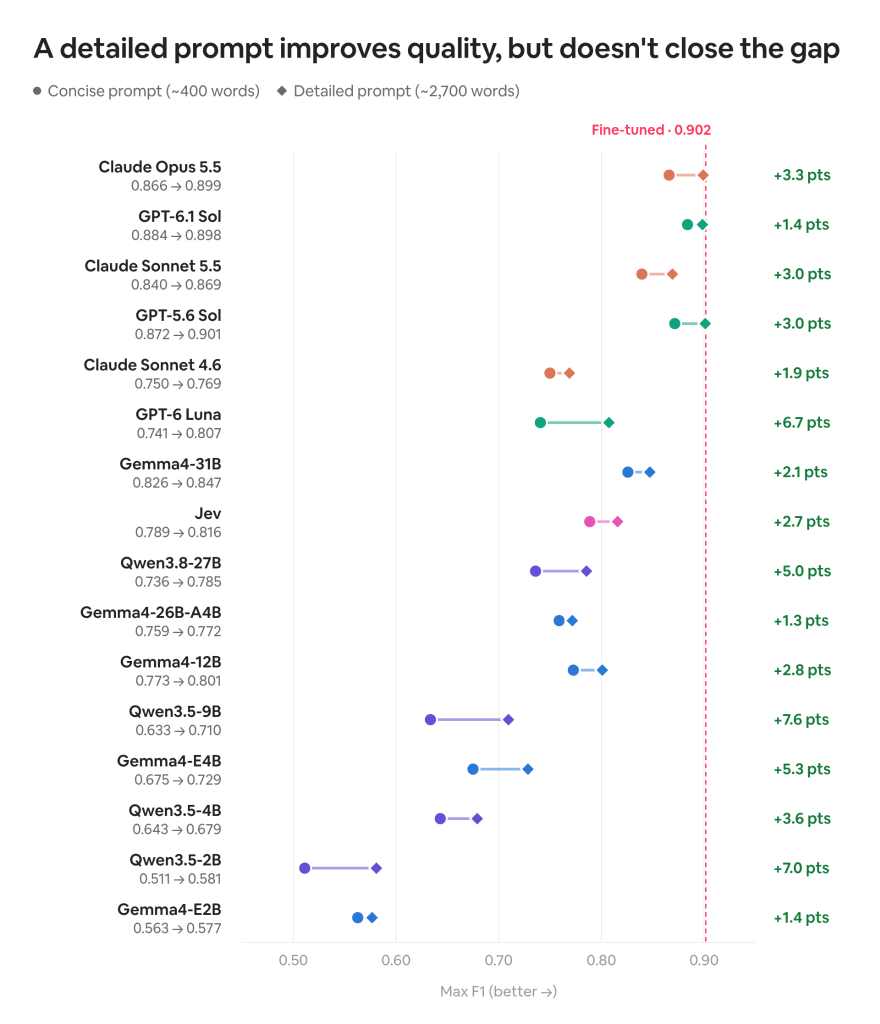
Câu lệnh chi tiết giúp nâng cao chất lượng phân loại nhưng không thể thu hẹp hoàn toàn khoảng cách. Toàn bộ mô hình đã được thử nghiệm với câu lệnh chi tiết dài 2.700 từ, mô tả cụ thể từng nhóm hành vi kèm ví dụ thực tế và các trường hợp dương tính giả phổ biến. Các mô hình tạo sinh độc quyền tăng từ một đến ba điểm và gần tương đương với bộ phân loại đã tinh chỉnh, dù ở m
Nguồn tin: Hacker News LLM — Tác giả: eivarv. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.