
Cách sử dụng PINN cho bài toán ngược Navier-Stokes
Một bản dựng PyTorch từ đầu giúp phục hồi lưu lượng máu, độ nhớt và ứng suất cắt thành mạch trong động mạch bị hẹp từ 40 phép đo vận tốc nhiễu. Bài viết Cách sử dụng PINN cho bài toán ngược Navier-Stokes xuất hiện lần đầu trên Towards Data Science.
Học sâu
Cách sử dụng PINN cho bài toán ngược Navier-Stokes
Một mô hình PyTorch được xây dựng từ đầu giúp phục hồi lưu lượng máu, độ nhớt và ứng suất cắt thành mạch trong động mạch bị hẹp từ 40 phép đo vận tốc nhiễu.
Ferran Alia, ngày 3 tháng 10 năm 2026, 10 phút đọc
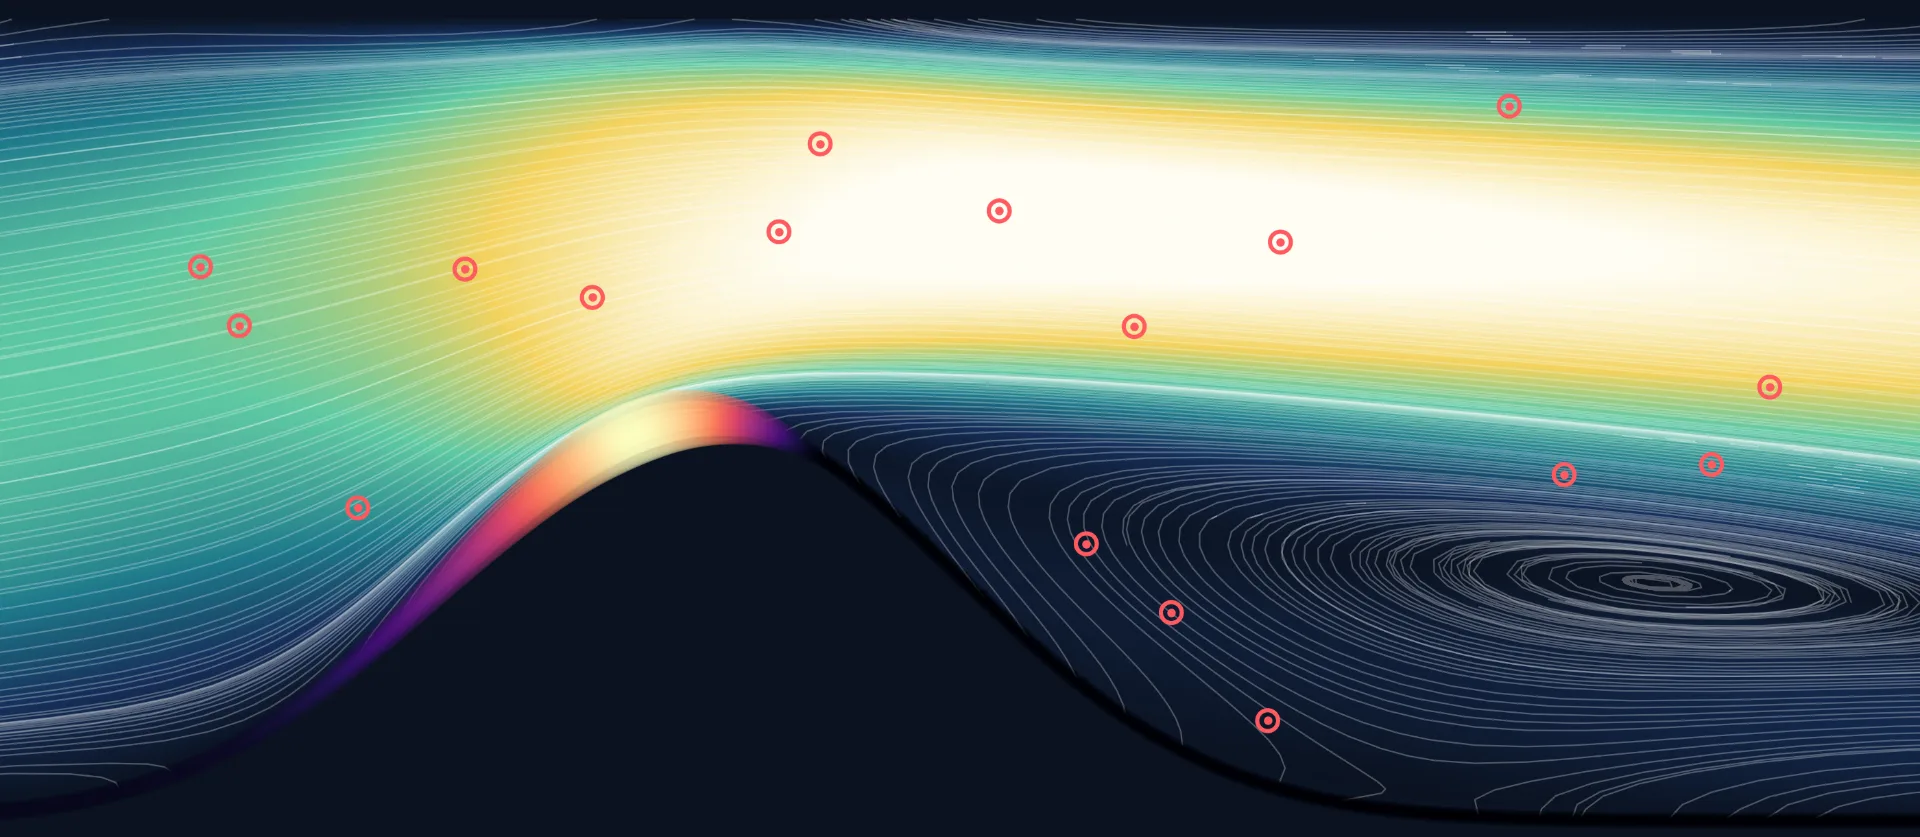
Trường vận tốc của PINN xung quanh chỗ hẹp. Các vòng tròn màu đỏ là cảm biến, và thành mạch phát sáng ở những nơi ứng suất cắt thành mạch được suy luận là cao nhất. Đây là đầu ra của mô hình, không phải dữ liệu tham chiếu CFD.
Xây dựng một PINN bằng PyTorch để phục hồi lưu lượng máu, độ nhớt chưa biết và ứng suất cắt thành mạch trong động mạch bị hẹp từ các phép đo cảm biến nhiễu.
Ứng suất cắt thành mạch là lực ma sát mà máu tác dụng lên thành mạch. Nó liên quan đến vị trí tích tụ mảng bám và rất khó đo trực tiếp. Những gì một phòng khám có thể thu được, ví dụ bằng siêu âm Doppler, là vận tốc tại một vài điểm bên trong mạch máu. Vì vậy, câu hỏi đặt ra cho bài viết này là liệu một mạng nơ-ron có thể lấy những vận tốc phân tán, nhiễu đó, cùng với các phương trình dòng chảy của chất lỏng, và trả về toàn bộ trường dòng chảy và ứng suất cắt tại thành mạch hay không.
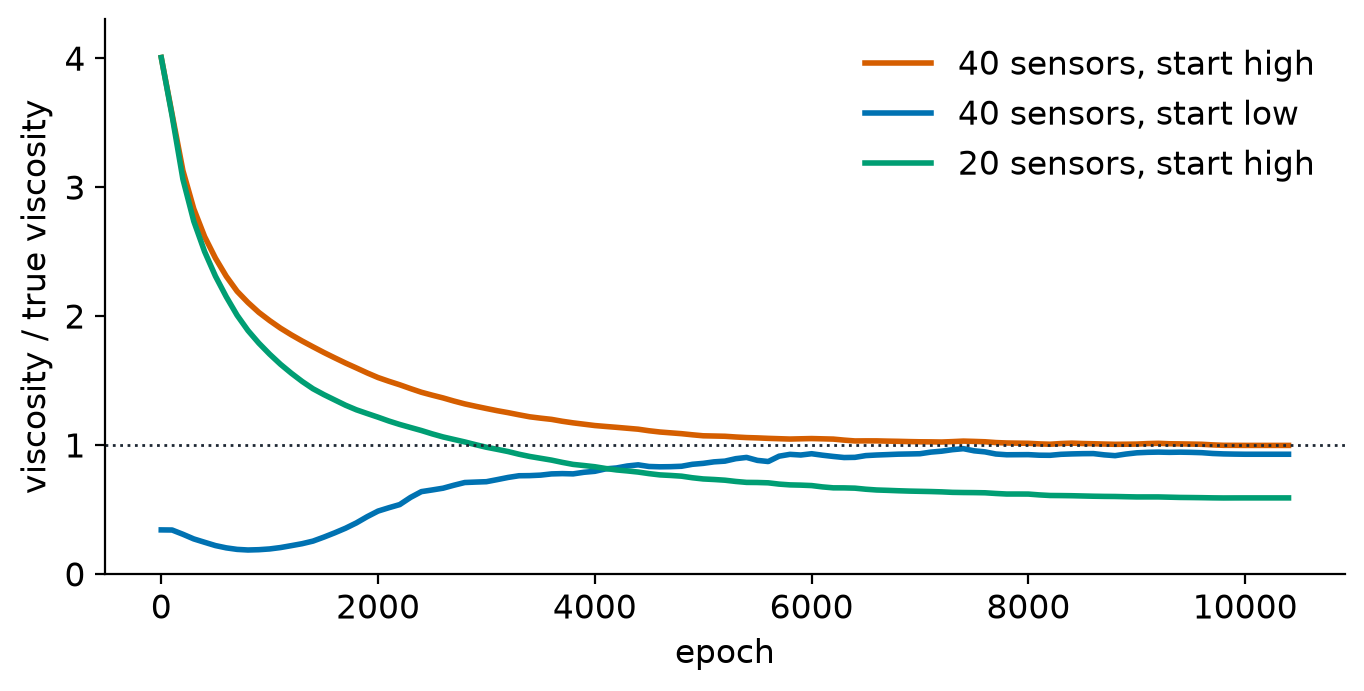
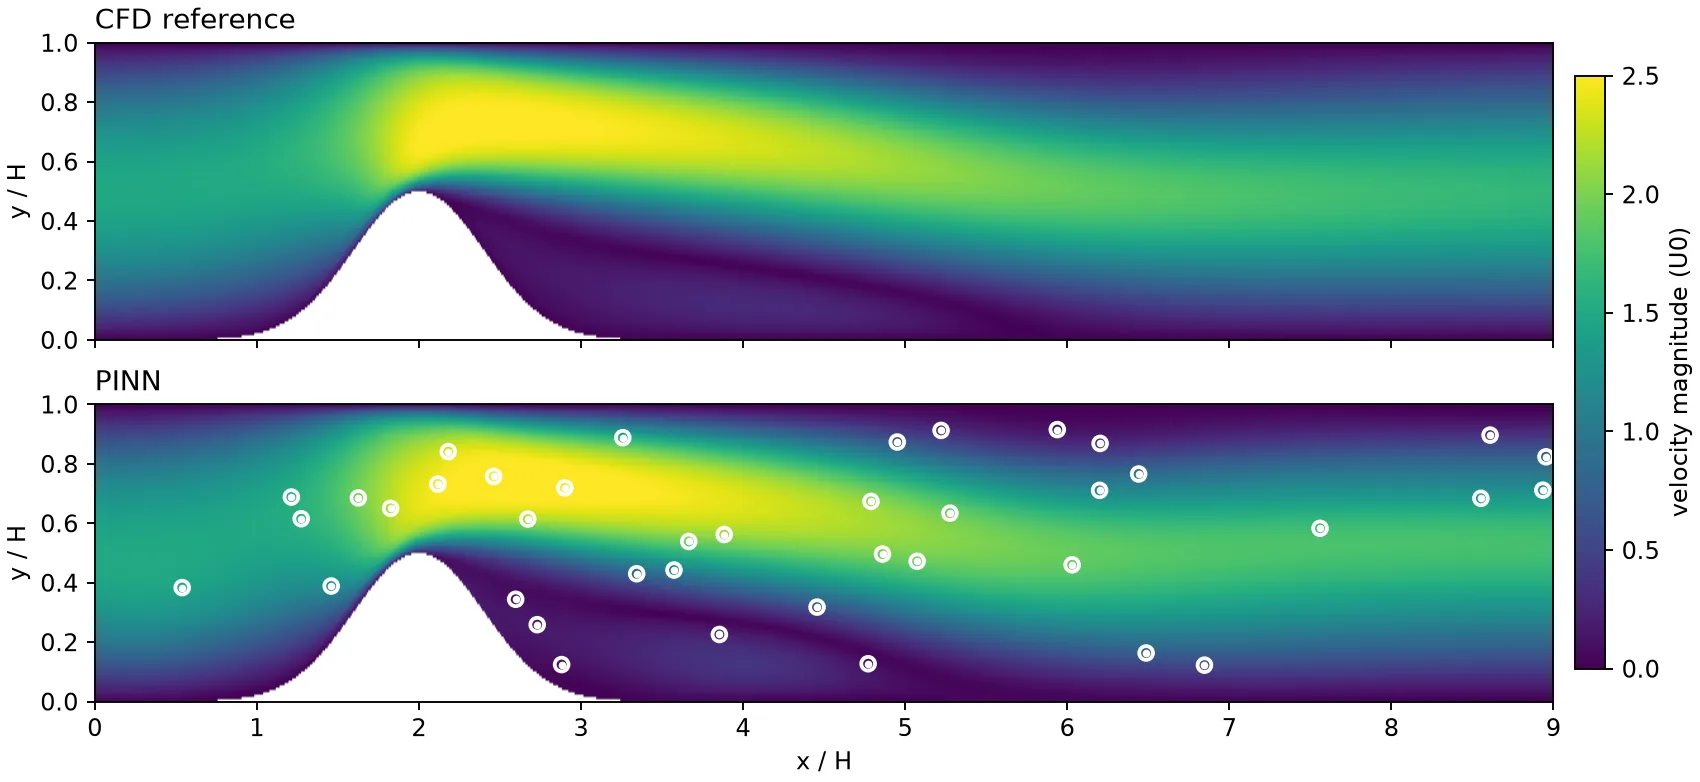
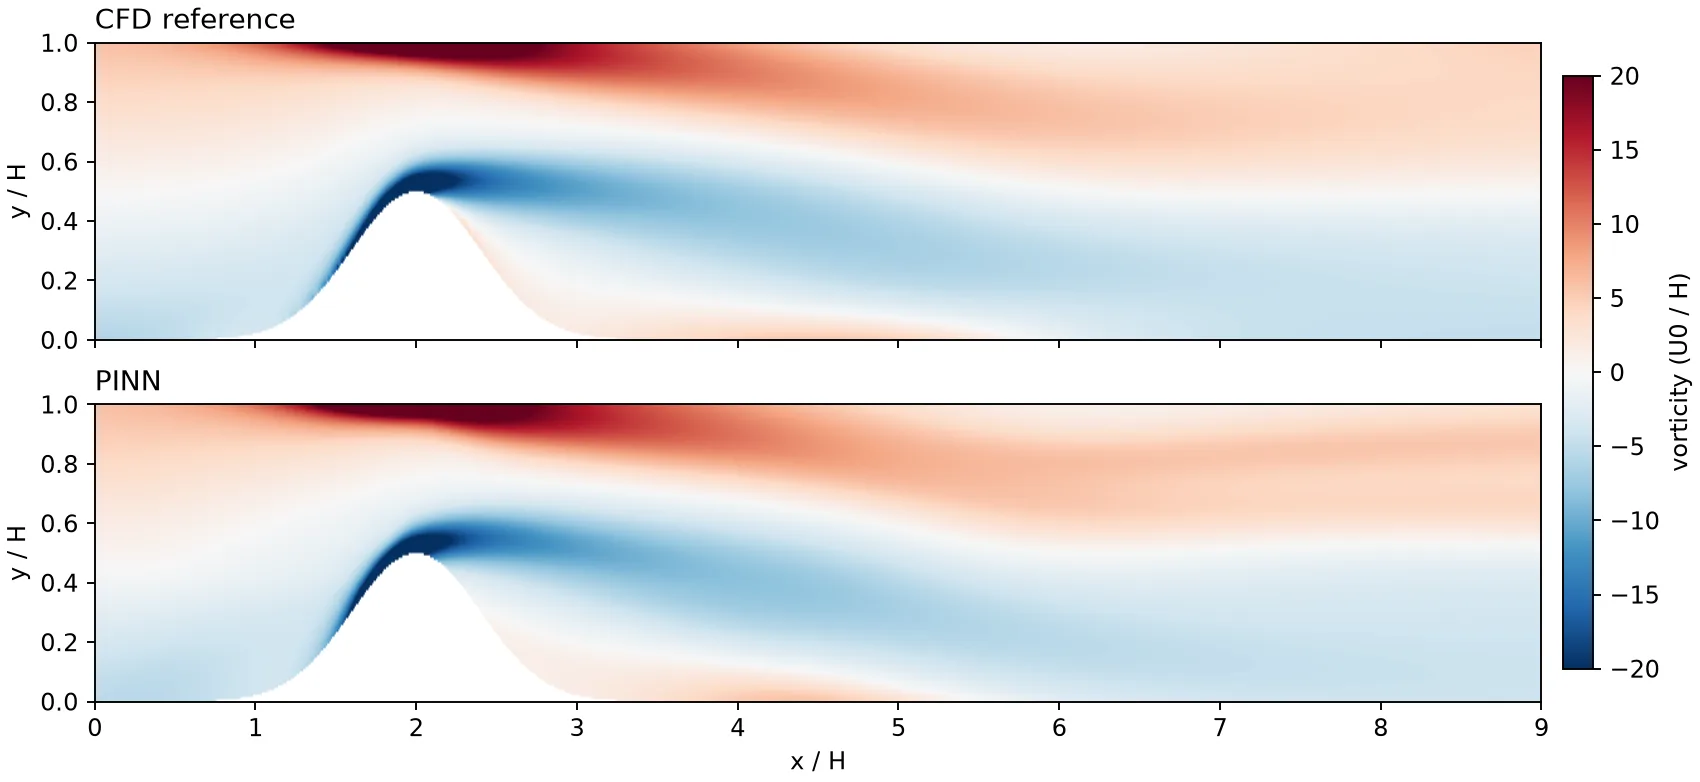
Mạng nơ-ron được thông tin vật lý (PINN) là một lựa chọn phù hợp tự nhiên. Chúng tôi đã xây dựng một mạng bằng PyTorch thuần túy, không sử dụng DeepXDE hay bất kỳ thư viện PINN nào khác, cho một động mạch 2D có chỗ hẹp (hẹp mạch). Từ 40 phép đo vận tốc, nó tái tạo trường vận tốc và áp suất cũng như vùng dòng chảy ngược phía sau chỗ hẹp. Nó cũng tính toán độ nhớt của chất lỏng, được coi là chưa biết, và ứng suất cắt thành mạch của nó bám sát dữ liệu tham chiếu CFD.
Đây là bài viết đầu tiên trong một loạt bài về PINN cho dòng chảy máu. Nó bao gồm phần cốt lõi: phần dư Navier-Stokes, độ nhớt có thể học được và yếu tố quyết định chất lượng kết quả. Các bài viết sau sẽ đề cập đến bộ giải CFD đằng sau dữ liệu tham chiếu và dòng chảy xung động theo nhịp tim.
Tìm hiểu từng bước với lộ trình Học máy tương tác.
**Thiết lập**
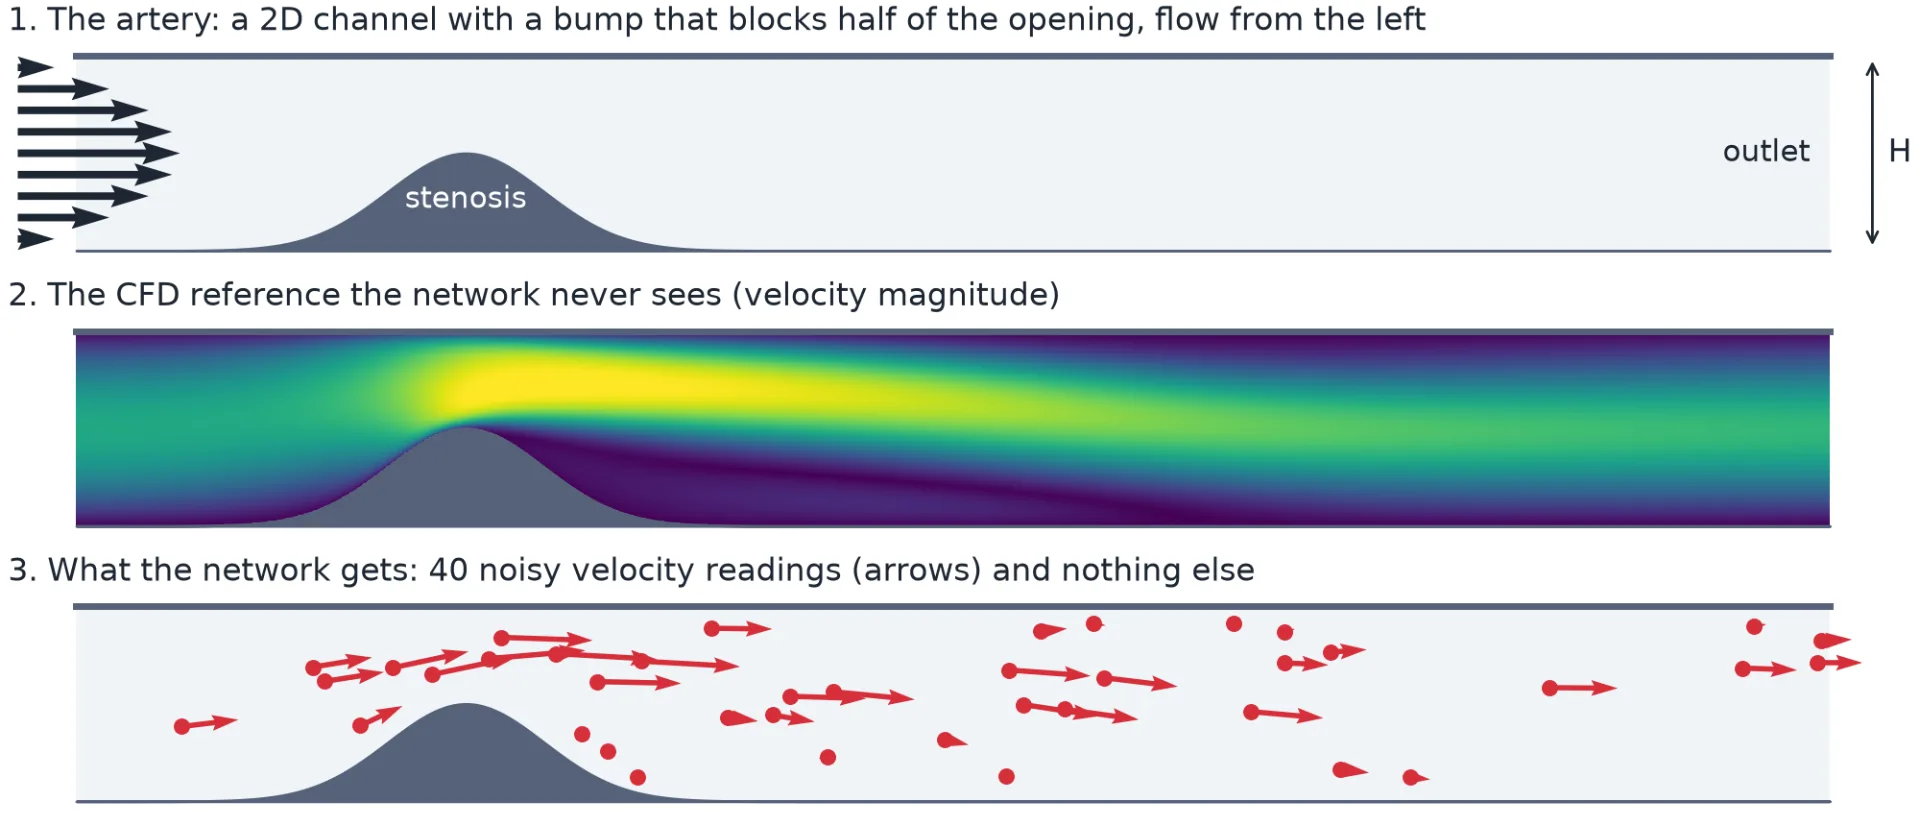
Động mạch là một kênh 2D có chiều cao H với một chỗ phình nhẵn trên thành dưới, làm tắc nghẽn một nửa khẩu độ, tương đương hẹp 50%. Dòng chảy là Navier-Stokes không nén được ở số Reynolds 200, với các độ dài được đo bằng chiều cao kênh và vận tốc được đo bằng vận tốc đầu vào. Đây là một dòng chảy chậm, ở mức thấp trong những gì xảy ra ở động mạch cảnh. Trong các đơn vị này, độ nhớt động học là 0,005.
Bài viết này không đề cập đến bệnh nhân, đây là một lựa chọn có chủ đích. Để đánh giá một bản tái tạo, cần biết đáp án đúng, vì vậy tôi đã tạo ra nó. Một bộ giải Navier-Stokes do tôi viết (phương pháp chiếu trên lưới so le) tính toán dòng chảy ổn định, và Mạng thần kinh vật lý (PINN) chỉ nhận được một vài giá trị đọc nhiễu từ giải pháp đó. Nhiễu là nhiễu Gauss, ở mức 7% vận tốc đầu vào. Tôi có thể trình bày về bộ giải này trong một bài viết sau.
Chiều dài của kênh quan trọng hơn tôi mong đợi. Phiên bản đầu tiên của tôi dài năm chiều cao. Phía sau chỗ phình, dòng chảy tách khỏi thành và một vùng dòng chảy ngược hình thành. Trong năm chiều cao, vùng đó không bao giờ đóng lại: chất lỏng vẫn di chuyển ngược ở đầu ra, nơi bộ giải giả định nó thoát ra. Đầu ra đã định hình giải pháp tham chiếu nhiều như vật lý. Kéo dài kênh lên chín chiều cao đã khắc phục được vấn đề. Dòng chảy ngược hiện kết thúc quanh x = 5,8 và mọi thứ sau đó đều chảy về phía trước.
Các giá trị đọc là 40 điểm bên trong chất lỏng, mỗi điểm có một vectơ vận tốc cộng với nhiễu. Không có giá trị đọc áp suất và không có giá trị đọc ngay tại thành. Tôi đặt chúng trong bốn dải dọc theo kênh, với nhiều điểm hơn xung quanh eo và vùng xoáy hơn là gần đầu vào và đầu ra. Bố cục đó tạo ra ít sự khác biệt, điều mà tôi sẽ quay lại ở cuối.
Những gì được đưa vào và những gì được giữ kín. Mạng thần kinh chỉ nhận được dải thứ ba, cộng với các phương trình và điều kiện thành và đầu vào. Mạng là một Mạng đa lớp truyền thẳng (MLP) đơn giản với 6 lớp gồm 32 đơn vị tanh, khoảng 5.500 trọng số. Nó sử dụng hàm tanh vì phương trình động lượng cần đạo hàm bậc hai của đầu ra, và đạo hàm bậc hai của hàm ReLU bằng 0 ở hầu hết mọi nơi. Các đầu vào được điều chỉnh lại về phạm vi -1 đến 1 bên trong mạng, do đó autograd vẫn phân biệt theo tọa độ vật lý.
**Viết phần dư Navier-Stokes trong PyTorch**
Một PINN ánh xạ tọa độ tới các đại lượng vật lý. Ở đây đó là (x, y) -> (u, v, p): hai thành phần vận tốc và áp suất. Hàm mất mát có một thành phần phù hợp với các phép đo, giống như bất kỳ hồi quy nào, và một thành phần được xây dựng từ phần dư của các phương trình: mức độ đầu ra của mạng vi phạm chúng. Bạn nhận được phần dư bằng cách lấy đạo hàm của mạng theo các đầu vào của nó, đó là mục đích của autograd. Đối với Navier-Stokes không nén được, có ba phương trình: liên tục và một phương trình động lượng cho mỗi thành phần vận tốc.
```python
def _grad(outputs, inputs): return torch.autograd.grad( outputs, inputs, grad_outputs=torch.ones_like(outputs), create_graph=True, retain_graph=True, allow_unused=True, materialize_grads=True, )[0]
def ns_residuals(model, x, y, nu):
x, y = x.clone().requires_grad_(True), y.clone().requires_grad_(True)
u, v, p = model(x, y)
u_x, u_y = _grad(u, x), _grad(u, y)
v_x, v_y = _grad(v, x), _grad(v, y)
p_x, p_y = _grad(p, x), _grad(p, y)
u_xx, u_yy = _grad(u_x, x), _grad(u_y, y)
v_xx, v_yy = _grad(v_x, x), _grad(v_y, y)
continuity = u_x + v_y
momentum_u = u * u_x + v * u_y + p_x - nu * (u_xx + u_yy)
momentum_v = u * v_x + v * v_y + p_y - nu * (v_xx + v_yy)
return continuity, momentum_u, momentum_v
```
Nếu ba giá trị này gần bằng 0 tại các điểm rải rác trên kênh, mạng lưới gần với một nghiệm của các phương trình, và các cảm biến sẽ chọn ra nghiệm phù hợp. Số hạng nhớt cần u_xx, một đạo hàm của đạo hàm, do đó autograd phải giữ lại đồ thị của đạo hàm bậc nhất. Đó là chức năng của tham số create_graph=True. Nếu bỏ qua tham số này, lệnh gọi thứ hai sẽ thất bại ngay trong epoch đầu tiên.
Hàm mất mát (loss) tổng hợp ba nhóm, mỗi nhóm có một trọng số:
- data, với trọng số 100, là sai số bình phương so với 40 giá trị đọc được.
- pde, với trọng số 10, là ba phần dư tại 2.500 điểm trải rộng khắp chất lỏng.
- bc, với trọng số 10, là điều kiện không trượt (no-slip) trên cả hai thành, biên dạng đầu vào (inlet profile) và điều kiện dòng chảy ra (outflow condition) (áp suất bằng 0).
Nguồn tin: Towards Data Science — Tác giả: Ferran Alia. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.