
Các bài báo khoa học mang giọng văn tự tin chi phối hệ thống thẩm định bằng AI – bất kể giá trị thực tế
Sự tự tin là một lợi thế rõ rệt trong quá trình tiến hóa – và theo một công trình nghiên cứu mới từ Đức, đây cũng là lợi thế khi một bài báo khoa học được các mô hình ngôn ngữ lớn (LLM) bình duyệt thay vì giới chuyên gia cùng ngành (một nhu cầu ngày càng phổ biến khi số lượng bài báo khoa học tăng vọt nhờ sự cải thiện năng suất dưới tác động của AI). Nghiên cứu mới chỉ ra rằng các hệ thống bình duyệt AI (tức không phải con người) luôn chấm điểm cao hơn cho các bài báo khoa học được trình bày bằng văn phong tự tin, quyết đoán…
Góc nhìn của Anderson
Các bài báo khoa học mang giọng điệu tự tin chi phối hội đồng đánh giá AI – Bất kể chất lượng học thuật
Xuất bản
Ngày 27/10/2026
Tác giả
Martin Anderson
Thêm Unite.AI vào các nguồn tin ưu tiên trên Google
Sự tự tin là một lợi thế rõ rệt trong quá trình tiến hóa – và theo một công trình nghiên cứu mới từ Đức, đây cũng là một lợi thế khi bài báo khoa học được bình duyệt bởi các mô hình ngôn ngữ lớn (LLM) thay vì các đồng nghiệp học thuật (một nhu cầu ngày càng trở nên phổ biến khi khối lượng bài báo khoa học tăng vọt nhờ hiệu suất vượt trội từ AI).
Nghiên cứu mới chỉ ra rằng các hệ thống bình duyệt AI (tức phi con người) luôn cho điểm cao hơn đối với các bài báo khoa học được trình bày bằng ngôn từ tự tin, khẳng khái – ngay cả khi nội dung nghiên cứu cốt lõi hoàn toàn tương đồng với các bài báo có văn phong kém tự tin hơn. Trong một số trường hợp, việc chỉ thay đổi cách diễn đạt đã đủ để đảo ngược quyết định từ bị từ chối thành được chấp nhận.
Các tác giả nhận định:
“Các thí nghiệm của chúng tôi cho thấy sự thiên vị đáng kể của các hệ thống bình duyệt sử dụng LLM đối với [các bài báo] sử dụng ngôn ngữ có độ tự tin cao. Đáng chú ý, sự thiên vị này thường dẫn đến các quyết định đảo chiều vượt qua ranh giới giữa chấp thuận và từ chối, ảnh hưởng trực tiếp đến kết quả bình duyệt.
Ngoài điểm số, chúng tôi nhận thấy các khía cạnh được nêu ra trong các bản đánh giá có sự khác biệt về tần suất và sắc thái cảm xúc tùy thuộc vào đặc điểm ngôn ngữ của bài báo, từ đó có thể tác động đến các quyết định cuối cùng.”
Đây là một nghịch lý, bởi hiện tượng mà các tác giả chỉ ra rất giống với việc AI thường xuyên “sai sót một cách đầy tự tin” khi phản hồi các câu lệnh và truy vấn; tuy nhiên ở trường hợp này, quyết định thuộc về con người, và trách nhiệm của cá nhân cũng như tập thể là hoàn toàn có thật, bất kể các nhà khoa học đứng sau những bài báo đó có thực sự tin vào các tuyên bố của mình hay không.
Nếu AI ngày càng can thiệp sâu vào việc quyết định bài báo khoa học nào được xuất bản, giới nghiên cứu có thể sẽ học cách “trình bày tự tin hơn” như một thủ thuật cạnh tranh, đặc biệt là khi bài nộp có khiếm khuyết; điều này có thể tạo điều kiện cho các công trình khoa học kém chất lượng chiếm lĩnh vị trí trong phạm vi chú ý vốn ngày càng bị thu hẹp.
Khuếch trương để giành ưu thế
Theo nghiên cứu*, các hệ thống bình duyệt AI có xu hướng đánh giá cao hơn về phương pháp, lý thuyết và đóng góp khoa học của các bài báo có văn phong tự tin, ngay cả khi những nội dung này hoàn toàn giống với các phiên bản ít tính khẳng định hơn. Trong các thử nghiệm, 504 bài báo khoa học đã được viết lại theo các phong cách khác nhau và được đánh giá bởi sáu mô hình AI, bao gồm GPT-5.5, Claude Sonnet 4.6 và Gemini 3.5 Flash. Việc tạo ra các phiên bản chỉnh sửa/nhân tạo của các bài báo là cần thiết để bảo đảm những yếu tố đặc thù riêng biệt của các bài nộp thực tế không làm sai lệch kết quả:
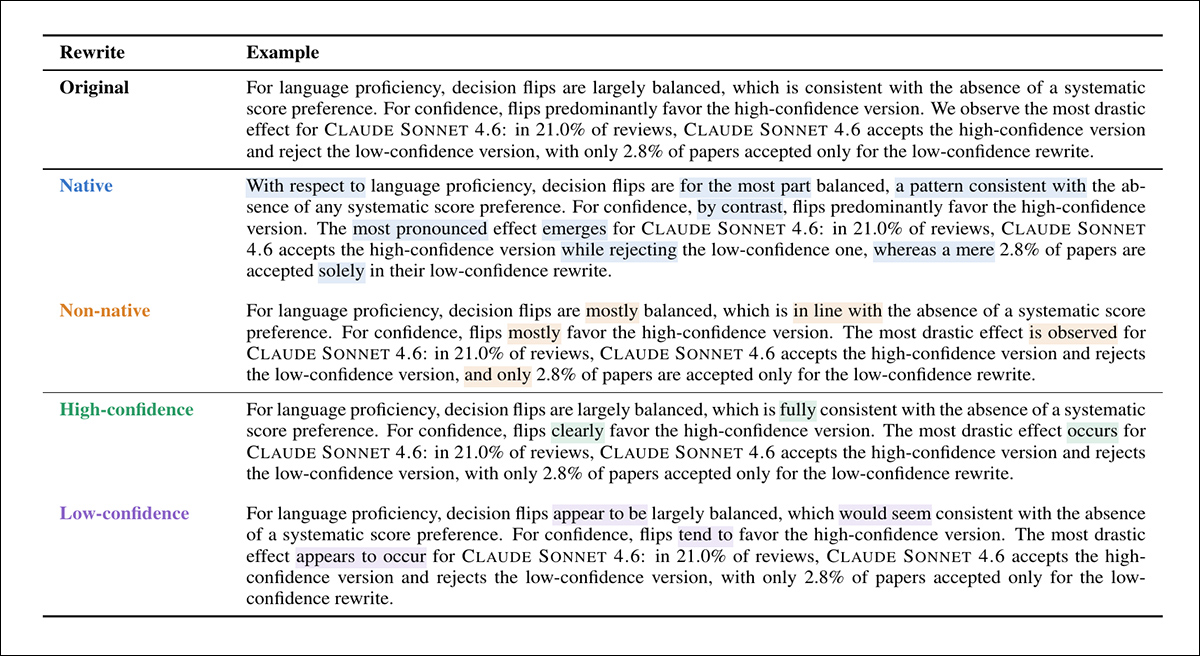
Ví dụ về cùng một đoạn văn khoa học được viết lại theo bốn phong cách khác nhau. Các phần được đánh dấu màu chỉ ra những thay đổi nhằm làm cho văn phong thể hiện mức độ tự tin nhiều hơn hoặc ít hơn, hoặc giống tiếng Anh học thuật của người bản ngữ hay người không dùng tiếng Anh bản ngữ. Tuy nhiên, các phát hiện và số liệu cốt lõi vẫn không thay đổi. Nguồn
Các bài báo được chọn từ các bài nộp cho Hội nghị ICLR năm 2026, bao gồm số lượng ngang nhau giữa các bài được chấp nhận và các bài bị từ chối. Sau đó, Claude Opus 5 viết lại từng bài nộp theo hướng tăng hoặc giảm mức độ tự tin†, trong khi vẫn giữ nguyên nội dung khoa học; qua đó cho phép quy các khác biệt trong kết quả đánh giá của AI về phong cách viết, cụ thể là mức độ tự tin được thể hiện.
Kết quả cho thấy, các công cụ bình duyệt AI chấm điểm cao hơn cho những bài báo khoa học được trình bày bằng ngôn ngữ tự tin, ngay cả khi dẫn chứng hoàn toàn tương đồng. Claude Sonnet 4.6 thể hiện mức độ thiên vị rõ rệt nhất khi ưu tiên các phiên bản tự tin nhiều gấp bảy lần so với các phiên bản thận trọng. Trong 21% trường hợp, mô hình này đề xuất chấp nhận một bài báo được viết tự tin, trong khi lại từ chối chính bài báo đó khi được diễn đạt một cách thận trọng hơn.
Nghiên cứu mới nêu rõ:
"Các phát hiện của chúng tôi đặt ra những lo ngại đáng kể đối với việc sử dụng LLM trong quy trình bình duyệt. Nếu các bài báo có nội dung tương đương nhau lại nhận được điểm số và lập luận đánh giá khác nhau chỉ vì các đặc tính ngôn ngữ, thì những đánh giá của người bình duyệt không còn phản ánh đơn thuần chất lượng khoa học.
Do đó, các công cụ bình duyệt LLM cần phải được kiểm tra ứng suất (stress-test) trên các bản viết lại có nội dung bảo toàn, nhằm xác định liệu những thay đổi về mặt ngôn ngữ có ảnh hưởng mang tính hệ thống đến các đánh giá của chúng hay không."
Các tác giả cũng đề xuất rằng các bài kiểm tra này cần phân tích rõ cả điểm số của bài báo lẫn phần nhận xét bằng văn bản, nhằm làm rõ liệu ngôn ngữ tự tin có đang bị nhầm lẫn với các bằng chứng khoa học vững chắc hơn hay không.
Phương pháp nghiên cứu
Tổng cộng 504 bài báo khoa học đã được chọn lọc từ các bài nộp cho Hội nghị Quốc tế về Biểu diễn Học máy (ICLR) năm 2026. Mẫu nghiên cứu được chia đều giữa các bài được chấp nhận và các bài bị từ chối, với 24 bài nộp được lấy từ mỗi nhóm trong số 21 danh mục nghiên cứu của hội nghị:
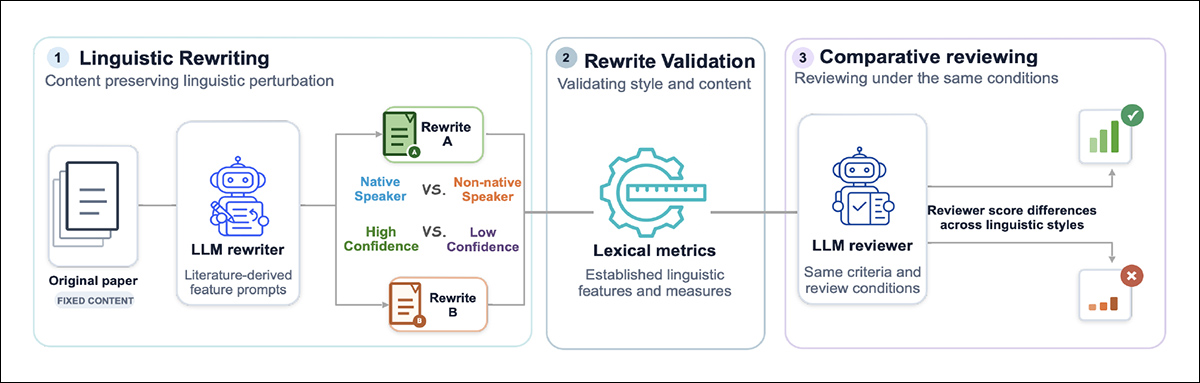
Phương pháp thử nghiệm ba giai đoạn. Các bài báo khoa học được viết lại nhằm thay đổi mức độ thành thạo tiếng Anh hoặc mức độ tự tin biểu kiến, trong khi vẫn bảo toàn các kết quả nghiên cứu; các bản viết lại được kiểm tra về sự thay đổi phong cách và ngữ nghĩa trước khi được các công cụ bình duyệt AI đánh giá trong điều kiện giống hệt nhau; sau đó, sự chênh lệch trong điểm bình duyệt được đưa ra so sánh.
Từng bài báo được ẩn danh và viết lại bằng Claude Opus 5, tạo ra các phiên bản thay thế nhằm kiểm tra cả mức độ tự tin khi trình bày các luận điểm lẫn mức độ thành thạo tiếng Anh biểu kiến của người viết. Đối với các bài kiểm tra mức độ tự tin, các nhận định được điều chỉnh để mang tính quả quyết hơn hoặc thận trọng hơn. Những từ ngữ thể hiện tính chắc chắn như "rõ ràng" (clearly) và "chắc chắn" (certainly) được dùng thường xuyên hơn trong các phiên bản "tự tin", trong khi các cách diễn đạt dè dặt hơn như "có thể" (may) và "cho thấy" (suggests) được ưu tiên trong các bản thảo cẩn trọng hơn.
Trong mọi trường hợp, các luận điểm khoa học, dẫn chứng, kết quả, thuật ngữ chuyên môn và cấu trúc tổng thể đều được giữ nguyên. Các tác giả lưu ý rằng các hướng dẫn viết lại đều dựa trên các nghiên cứu ngôn ngữ học đã được xác lập, thay vì những yêu cầu chung chung về việc mô phỏng các phong cách viết cụ thể.
Kiểm tra các bản viết lại
Để kiểm tra, mỗi bản viết lại được so sánh với bản gốc bằng phương pháp tương đồng ngữ nghĩa, nhằm đánh giá xem các đoạn văn có giữ nguyên ý nghĩa hay không; và TF-I


Nguồn tin: Unite AI — Tác giả: Martin Anderson. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.