Thông báo: Do đang trong quá trình di chuyển, phần thuyết minh sẽ được cập nhật muộn hơn dự kiến.
Tối ưu hóa theo thuật toán leo đồi (hill-climbing) là công việc không quá phức tạp, song việc xác định mục tiêu cần tối ưu hóa lại là bài toán nan giải. Việc nâng cao điểm số đòi hỏi chi phí lớn, nhưng các phương pháp thực hiện đã rõ ràng hơn nhiều so với việc xây dựng các bộ tiêu chuẩn đánh giá (benchmark) thực sự có ý nghĩa tại ranh giới công nghệ tiên tiến nhất của AI hiện nay.
Mức độ phức tạp của công tác đánh giá độc lập các mô hình ngôn ngữ vẫn chưa được nhìn nhận một cách đầy đủ. Các đơn vị đánh giá không chỉ đơn thuần tiếp nhận các mô hình hiện có và chứng nhận điểm số—dù đây vốn đã là một quy trình đòi hỏi chuyên môn kỹ thuật cao. Nhiệm vụ này chỉ dừng lại ở mức độ đó nếu tiến trình phát triển của AI diễn ra chậm. Khi tốc độ phát triển của AI nhanh như hiện nay, các chi tiết kỹ thuật của c
Thông báo kỹ thuật: Do tác giả đang trong quá trình di chuyển, phần đọc bản tin (voiceover) sẽ được cập nhật muộn hơn thường lệ.
Tối ưu hóa tham số (hill-climbing) là việc không khó, song xác định đúng mục tiêu cần tối ưu hóa mới là bài toán phức tạp. Việc gia tăng điểm số đòi hỏi chi phí lớn, nhưng quy trình thực hiện đã rõ ràng hơn nhiều so với việc xây dựng các bộ tiêu chuẩn đánh giá (benchmark) có ý nghĩa thực chất tại ranh giới công nghệ AI hiện nay.
Mức độ phức tạp của công tác đánh giá độc lập các mô hình ngôn ngữ vẫn chưa được nhìn nhận đúng mức. Các đơn vị đánh giá không đơn thuần kiểm định và xác nhận điểm số của các mô hình hiện hành—vốn đã là một quy trình kỹ thuật chuyên sâu. Nhiệm vụ đó chỉ phù hợp khi tốc độ phát triển của AI ở mức chậm. Trước tốc độ tiến bộ vượt bậc của AI hiện nay, các chi tiết kỹ thuật chỉ là phần việc thường nhật trong nỗ lực quy đổi chất lượng của một mô hình AI thành một con số định lượng duy nhất. Mục tiêu đặt ra là xác lập một chỉ số vừa mang tính đại diện cho các mô hình đương thời, vừa phản ánh đúng trải nghiệm thực tế, nhận định từ cộng đồng và các phân tích khoa học, đồng thời phải có tính định hướng để không bị lạc hậu chỉ sau 3 tháng.
Mọi đơn vị xây dựng chuẩn đánh giá đều đối mặt với một nghịch lý: tiêu chuẩn cần được cô đọng thành một con số duy nhất nhằm thuận tiện cho việc thảo luận, đưa vào báo cáo và so sánh giữa các mô hình; tuy nhiên, mọi phương pháp tổng hợp điểm số đều đòi hỏi những sự đánh đổi đáng kể. Đây là thách thức chung đối với cả những nhà khoa học hàng đầu. Vấn đề cốt lõi nằm ở việc thiết lập các chỉ số tổng hợp có độ công bằng cao nhất, dù biết rằng sự thiếu hoàn hảo là điều không thể tránh khỏi.
Với quy mô vốn khổng lồ trong hệ sinh thái AI hiện nay, vai trò của hoạt động đánh giá độc lập ngày càng nặng nề khi kết quả đánh giá có thể định đoạt vị thế cạnh tranh trong một thị trường nghìn tỷ USD. Các đơn vị này còn tác động trực tiếp đến quá trình phát triển của chính các mô hình, từ đó định hình xu hướng tiến bộ công nghệ. Điều này tạo ra áp lực rất lớn.
Cơ sở của bài viết này là bản cập nhật Chỉ số Trí tuệ phiên bản 5 (Intelligence Index v5) do Artificial Analysis công bố gần đây. Chỉ số của Artificial Analysis (AA) hiện là thước đo độc lập nổi bật nhất về năng lực của các mô hình tiên tiến hàng đầu, xếp sau đó với khoảng cách khá xa là Chỉ số Năng lực (Capabilities Index - ECI) của Epoch AI. Cho đến nay, các bộ chỉ số này đều đem lại giá trị lớn cho cộng đồng, song cũng bộc lộ không ít khiếm khuyết đáng kể.
Interconnects AI là ấn phẩm hoạt động nhờ sự ủng hộ của độc giả. Độc giả có thể cân nhắc đăng ký theo dõi ấn phẩm.
Các mô hình ngôn ngữ hiện có năng lực xử lý đa dạng và phạm vi này đang mở rộng nhanh chóng. Kỷ nguyên đánh giá trí tuệ nhân tạo bằng các chỉ số đơn lẻ cần sớm được khép lại, song tiến trình này sẽ đòi hỏi nhiều thời gian.
Dưới đây là tóm tắt về phiên bản AAv5 trích từ bài đăng của tổ chức này, được mô tả là “phản ánh sát thực tiễn sử dụng hiện nay”:
Trọng số của Chỉ số Trí tuệ phiên bản 5 (Intelligence Index v5):
➤ Lao động tri thức (Knowledge Work - 25%): AA-Briefcase (15%), AutomationBench-AA (5%) và GDP.pdf (5%)
➤ Lập trình (Coding - 25%): FrontierCode 2.0 (15%) và Terminal-Bench 4.0 (10%)
➤ Khoa học (Science - 25%): Terminal-Bench-Science (15%) và tập dữ liệu con mức độ khó CritPt v2 (10%)
➤ Năng lực tổng quát (General - 25%): AA-Omniscience v1.1 15% (độ chính xác 10%, không tạo thông tin sai lệch 5%) và HLE-Diamond (10%)
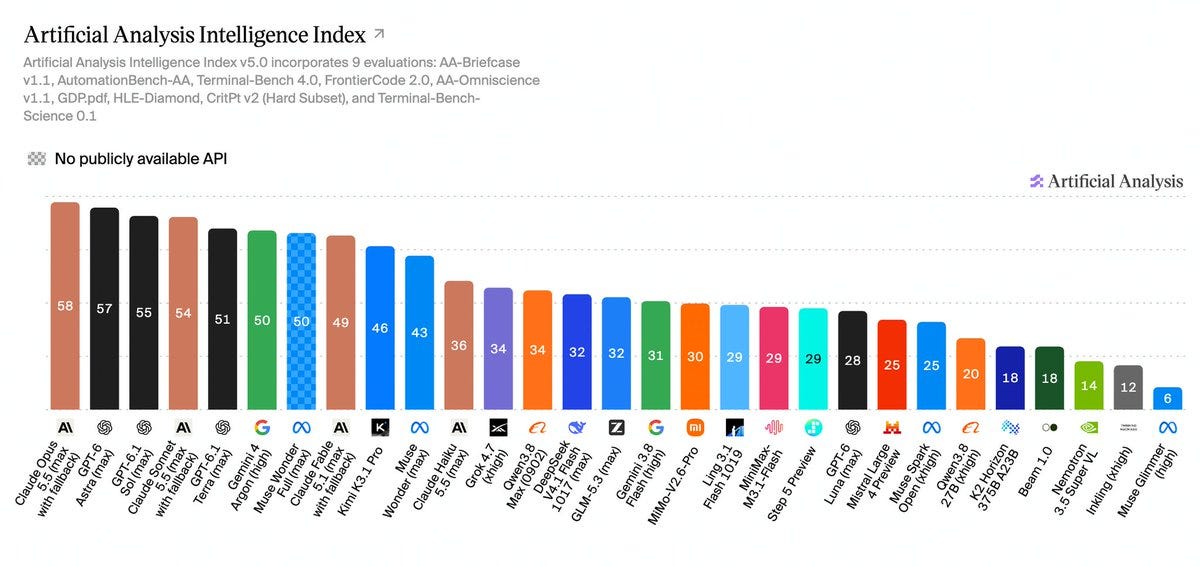
Dưới đây là bảng xếp hạng mới của các mô hình:
Khó khăn hiện nay trong việc đánh giá hiệu năng ứng dụng thực tế nằm ở tính thiếu đồng đều và phân mảnh cao, tương tự như bản chất của chính các mô hình. Trường hợp ứng dụng được kiểm chứng rõ ràng nhất là lập trình, nơi các mô hình mở thể hiện tính cạnh tranh vượt trội và có nhiều khả năng theo kịp đà phát triển. Đối với các công việc đòi hỏi xử lý tri thức chuyên sâu, năng lực của các mô hình mở vẫn chưa thực sự tạo được độ tin cậy cao.
Thoạt nhìn, xét trên phương diện tổng thể, kết quả này hoàn toàn hợp lý. Tuy nhiên, tương tự như mọi bộ tiêu chuẩn kiểm thử khác, kết quả vẫn bộc lộ những điểm gượng ép và thiếu nhất quán nhất định, điển hình là việc GPT 6.1 Terra vượt qua Claude Fable 5.1. Hiện nay, một số bộ tiêu chuẩn tập trung đo lường giới hạn năng lực tối tân nhất của mô hình trong các tác vụ mở thông qua những khung kiểm thử chuyên biệt, điều thường đòi hỏi một mô hình quy mô lớn. Một số bộ tiêu chuẩn khác lại đánh giá các kỹ năng cụ thể cần thiết cho mô hình trong các tác vụ đại lý mang tính lặp lại. Có thể nhận thấy bộ tiêu chuẩn AA đang được điều chỉnh thiên về hướng tiếp cận thứ nhất—hướng tới một đối tác cộng tác đại lý tổng quát—dù các nhóm hành vi này đều có sự chồng lấn nhất định.
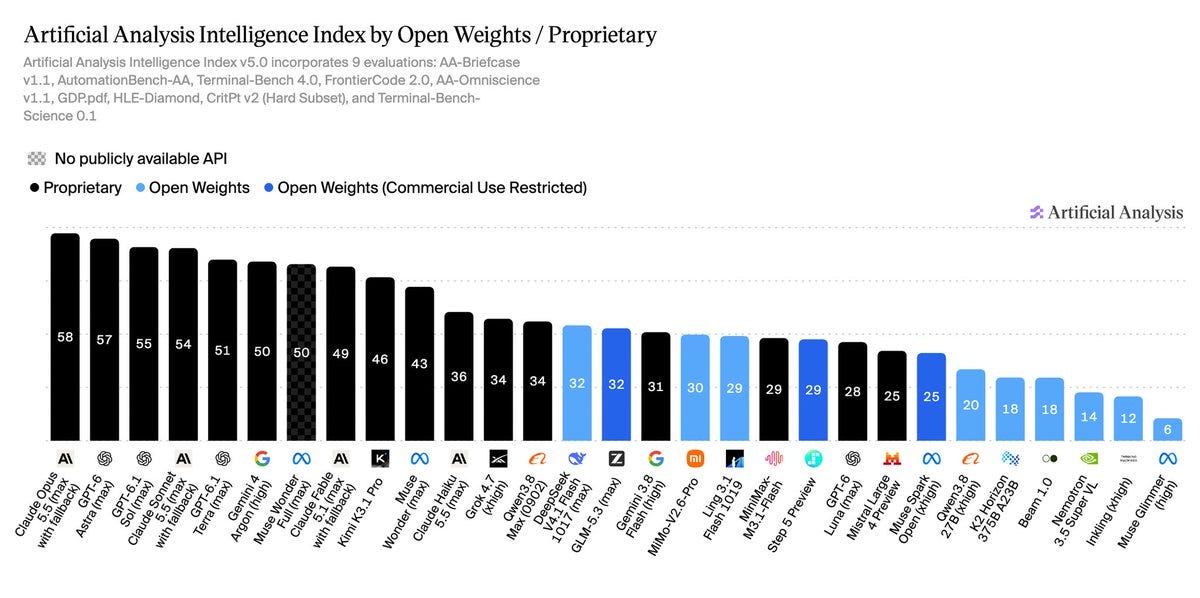
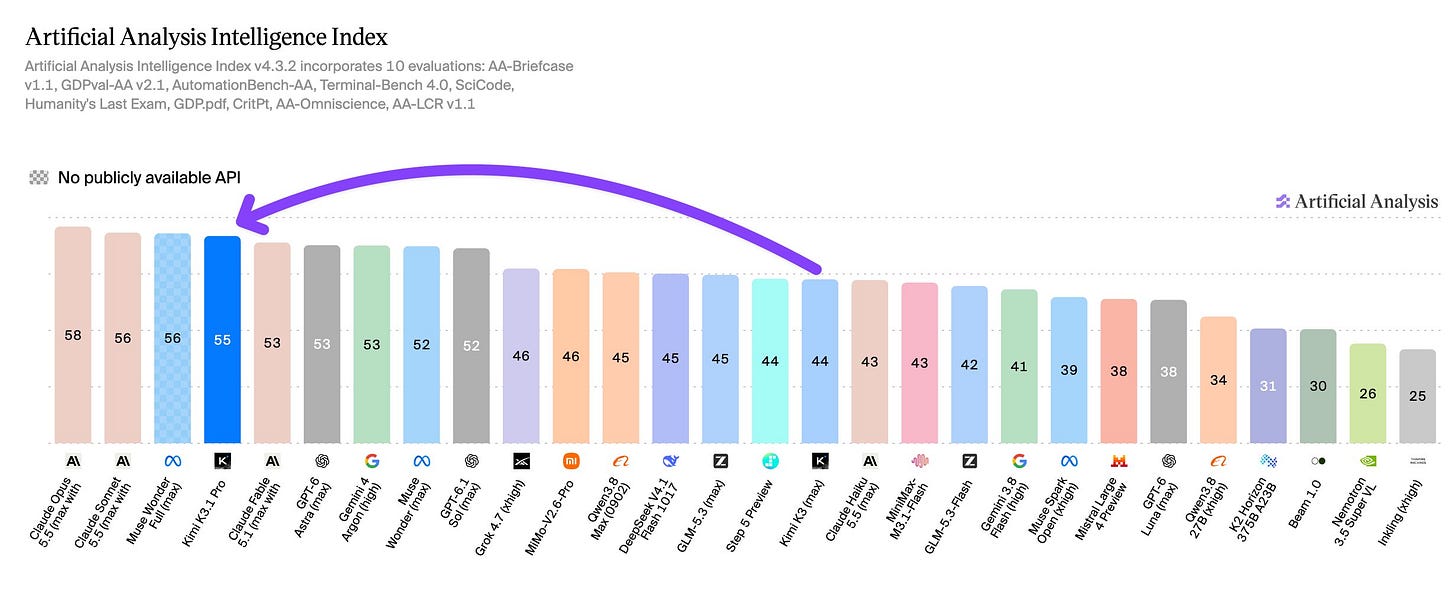
Điều này dẫn tới biểu đồ đang được lan truyền rộng rãi gần đây, phản ánh sự tương quan giữa các mô hình mở và mô hình đóng theo bộ tiêu chuẩn đánh giá mới. Biểu đồ chỉ ra rằng có tới 8 mô hình đóng vượt trội hơn mô hình trọng số mở (open-weight) triển vọng nhất là Kimi K3.1 Pro (không được đánh dấu màu xanh). Bộ tiêu chuẩn này dựa trên định hướng đo lường xu thế phát triển của các mô hình tiên phong, điều vô hình trung nới rộng khoảng cách đối với các mô hình mở. Đây là một định hướng có thể chấp nhận; song theo thời gian, khi các quy trình làm việc sử dụng mô hình mở trở thành nhân tố kinh tế trọng yếu, bộ tiêu chuẩn này có nguy cơ bỏ sót động lực kinh tế cốt lõi của toàn ngành.
Những nhận định về sự suy tàn của các mô hình mở dường như đang bị phóng đại quá mức, dù chỉ số đánh giá trước đây có phần đánh giá quá cao các mô hình trọng số mở. Nhìn vào biểu đồ công bố tại sự kiện ra mắt Kimi K3.1 Pro, dù các mô hình mở rất mạnh và hữu ích trong một số trường hợp, các mô hình hàng đầu của OpenAI và Anthropic vẫn thể hiện bước tiến vượt bậc về tính linh hoạt cũng như độ tin cậy.
Trong bộ tiêu chuẩn AAv5, một số bài kiểm tra mà các mô hình mở tụt lại xa nhất thuộc nhóm "khoa học", đơn cử như terminal-bench-science và CritPT v2. Dù còn khoảng cách, mục tiêu giá trị cốt lõi của mô hình mở chưa bao giờ là cạnh tranh trực tiếp ở đỉnh cao công nghệ biên. Nền kinh tế của mô hình mở sẽ tập trung vào:
Hạ giá thành suy luận (inference) ở các lĩnh vực có nhu cầu thị trường cao xuống mức giá cơ bản tương đương chi phí phần cứng.
Tạo điều kiện làm chủ năng lực trí tuệ, chuyên biệt hóa theo dữ liệu nội bộ và kiểm soát các tác tử nội bộ tại nhiều doanh nghiệp trong nền kinh tế.
Cả hai mục tiêu này đều đòi hỏi quá trình dài hạn và hiện chỉ mới được phản ánh một phần qua các bài đánh giá chuẩn. Nguồn cung tài nguyên tính toán (compute) hiện khan hiếm đến mức các nhà cung cấp mô hình mở vẫn đang ghi nhận biên lợi nhuận đáng kể; chỉ khi mức biên lợi nhuận này thu hẹp, hệ thống mới thực sự vận hành theo đúng quy luật thị trường. Tình trạng tương tự cũng xảy ra đối với mức độ phổ cập trong khối doanh nghiệp; hiện vẫn chưa thể xác định giới hạn trần do rào cản chuyên môn sâu về học máy (ML) cần thiết cho việc xây dựng khung đánh giá và xử lý sau đào tạo (post-training).
Chia sẻ
Ở chu kỳ phát triển mô hình lớn kế tiếp, ước tính trong 2–3 tháng tới với sự xuất hiện của GLM 6 hoặc Kimi 3.5, các phòng nghiên cứu mô hình mở hàng đầu được dự báo sẽ tạo ra những bước tiến đáng kể trên bảng chỉ số này, tiếp tục mang lại bất ngờ cho giới quan sát. Đây là chu kỳ vốn đã diễn ra liên tục trong nhiều năm qua.
Đã có nhiều phân tích chỉ rõ phương thức các mô hình mở bám đuổi ranh giới công nghệ tối tân, và mộ
Nguồn tin: Interconnects Newsletter — Tác giả: Nathan Lambert. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.