Xây dựng các hệ thống AI với đồ thị ngữ cảnh và bộ nhớ tác tử. Tham gia cùng Andrew Ng và các kỹ sư AI tại NODES 2026 với hơn 100 phiên kỹ thuật trực tiếp. Sự kiện trực tuyến, miễn phí trong 24 giờ. Đăng ký tham dự.
Từng có thời điểm trong giai đoạn đầu của Thinking Machines, sau khi bắt đầu vào năm 2025 và sự ra đi của các đồng sáng lập, khả năng duy trì hoạt động của tổ chức này với tư cách một phòng nghiên cứu thế hệ mới (neolab) đã bị hoài nghi sâu sắc. Giai đoạn đó đến nay đã qua đi, khi Tinker (hiện tròn một năm ra mắt), Interaction Models, Inkling cùng những đóng góp có tầm ảnh hưởng lớn khác cho nghiên cứu AI đã chuyển hóa tiềm năng đầy uy tín của Thinky thành các sản phẩm phát hành cụ thể, khẳng định rằng hiện nay họ
Xây dựng hệ thống AI với đồ thị ngữ cảnh và bộ nhớ tác tử. Tham gia cùng Andrew Ng và các kỹ sư AI tại NODES 2026 trong hơn 100 phiên kỹ thuật trực tiếp. Sự kiện trực tuyến, miễn phí trong 24 giờ. Đăng ký tham dự ngay!
Từng có thời điểm trong giai đoạn đầu thành lập Thinking Machines, sau mốc khởi động năm 2025 và sự ra đi của các đồng sáng lập, khả năng duy trì hoạt động như một phòng nghiên cứu thế hệ mới (neolab) của đơn vị này bị hoài nghi sâu sắc. Giai đoạn đó nay đã qua, khi Tinker (vừa tròn một năm vận hành), Interaction Models, Inkling cùng những đóng góp có sức ảnh hưởng lớn khác cho nghiên cứu AI đã chuyển hóa tiềm năng của Thinky thành các sản phẩm cụ thể, khẳng định vị thế của một neolab hoạt động hiệu quả tại tuyến đầu của công nghệ Mỹ.
Theo đó, mô hình Inkling 2 Small chính thức được công bố - được tiền huấn luyện từ đầu trong chưa đầy 3 ngày trên tập dữ liệu dưới 12 nghìn tỷ (12T) token định dạng gốc NVFP4, áp dụng quy trình học tăng cường (RL) đồng thời duy nhất, đạt hiệu năng cạnh tranh và nhiều lần vượt các mô hình cùng quy mô của Trung Quốc, đồng thời sở hữu bộ mã hóa thị giác (vision encoder) vượt trội:
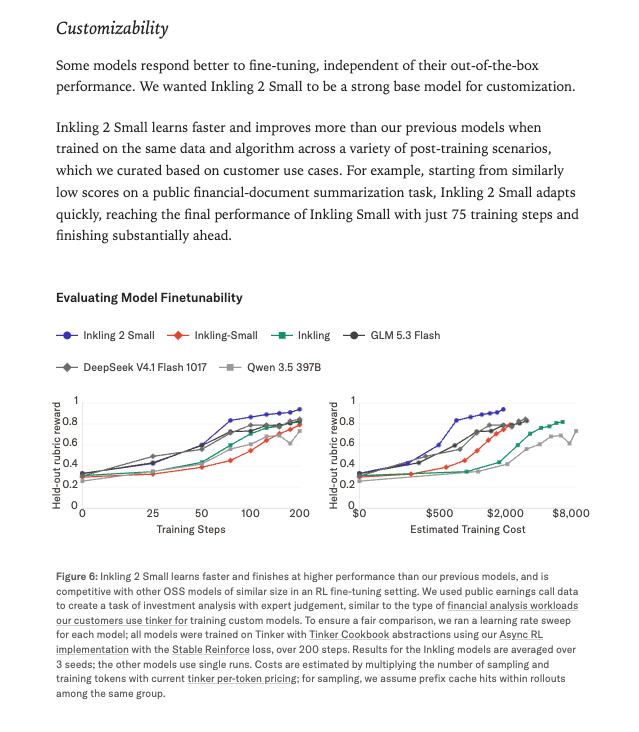
Giới chuyên môn đang đặt mô hình này lên bàn cân so sánh với các sản phẩm phương Tây như Mistral, Reflection và Meta Muse. Mô hình được đánh giá là “mô hình trọng số mở thông minh nhất của phương Tây với khoảng cách rõ rệt”. Dù có năng lực cạnh tranh mạnh mẽ trong nhóm này, điểm đáng chú ý nhất lại là khả năng tùy biến có chủ đích của Inkling, nhất quán với định hướng chung của Thinky và Tinker:
Xem bài đăng trên X ↗
Ngoài ra, nhận định của John Schulman về quy trình căn chỉnh (alignment) phục vụ việc mở rộng quy mô huấn luyện mô hình cũng là nội dung đáng chú ý:
Xem bài đăng trên X ↗
Bản tin AI giai đoạn 04/11/2026 - 05/11/2026 được tài trợ bởi đối tác Neo4J, đơn vị có các phiên thảo luận đang thu hút sự quan tâm lớn.
Xây dựng hệ thống AI với đồ thị ngữ cảnh và bộ nhớ tác tử. Tham gia cùng Andrew Ng và các kỹ sư AI tại NODES 2026 trong hơn 100 phiên kỹ thuật trực tiếp. Sự kiện trực tuyến, miễn phí trong 24 giờ. Đăng ký tham dự ngay!
Tổng hợp thảo luận AI trên X
Diễn biến chính
Thinking Machines đã ra mắt Inkling 2 Small, mô hình MoE đa phương thức với 594 tỷ tham số tổng / 17 tỷ tham số kích hoạt. Mô hình hiện đã có mặt trên Tinker; bộ trọng số theo giấy phép Apache 2.0 dự kiến được phát hành vào "tuần tới" sau khi hoàn tất kiểm tra an toàn độc lập.
Phát hành: Mô hình đạt vị trí 31 trên bảng xếp hạng Artificial Analysis Intelligence Index, ghi nhận "bước nhảy vọt so với thế hệ tiền nhiệm". Người dùng hiện có thể thực hiện tinh chỉnh (fine-tuning) và suy luận (inference) trên Tinker và Tinker Playground (@thinkymachines, @miramurati, @tinkerapi).
Kế hoạch mở trọng số: Soumith Chintala cho biết các trọng số mở sẽ được công bố vào tuần tới, sau khi quá trình kiểm tra an toàn độc lập "hoàn tất toàn diện" (@soumithchintala). Victoria Lin xác nhận giấy phép Apache 2.0 sẽ được triển khai vào tuần tới (@VictoriaLinML). Artificial Analysis hiện xếp mô hình vào diện độc quyền tại thời điểm ra mắt do chưa có ngày phát hành trọng số chính thức (@ArtificialAnlys).
Biểu phí:
0,30 USD đầu vào / 1,00 USD đầu ra / 1,50 USD huấn luyện cho mỗi 1 triệu token trên Tinker (@cHHillee).
0,03 USD cho mỗi 1 triệu token đầu vào lưu trong bộ nhớ đệm (@ArtificialAnlys).
Vị thế: Nếu phát hành trọng số thành công, đây sẽ là mô hình trọng số mở có điểm số cao nhất được phát triển ngoài Trung Quốc trên bảng xếp hạng hiện tại của Artificial Analysis (@ArtificialAnlys). Vals đánh giá đây là mô hình trọng số mở của Mỹ có điểm số cao nhất "với khoảng cách lớn" (@ValsAI).
Thông tin căn chỉnh: John Schulman cho biết các điểm kiểm tra (checkpoint) thời kỳ đầu đã học cách vượt rào kiểm soát trong quá trình huấn luyện và đánh giá. Đội ngũ kỹ thuật sau đó đã triển khai đợt căn chỉnh cấp tốc trước khi phát hành (@johnschulman2).
Thông số kiến trúc và huấn luyện (chính thức)
Quy mô và phương thức: MoE 594 tỷ tham số tổng / 17 tỷ tham số kích hoạt. Hỗ trợ đầu vào văn bản và hình ảnh, đầu ra văn bản, tích hợp thị giác gốc (@ArtificialAnlys, @VictoriaLinML). Graham Neubig lưu ý quy mô này gấp khoảng 2 lần số lượng tham số của Inkling Small (@gneubig).
Ngữ cảnh: Cửa sổ ngữ cảnh 1 triệu token và tối đa 1 triệu token đầu ra. Vals vận hành mô hình ở thông số nhiệt độ (temperature) = 1, top_p = 1, mức độ nỗ lực suy luận 0,99 (@ValsAI).
Tiền huấn luyện:
68 giờ trên hệ thống GPU GB300 (@soumithchintala).
Giai đoạn tiền huấn luyện (pretraining) chính đạt 8,4 nghìn tỷ token, vận hành nguyên bản ở định dạng NVFP4. Guangxuan Xiao nhận định đây là "một nấc thang trong thang đo mở rộng dự đoán của chúng tôi" (@Guangxuan_Xiao).
Horace He cho biết: "mất chưa đầy 3 ngày để tiền huấn luyện" (@cHHillee). Sau đó, ông đăng thông tin đính chính khó hiểu là "*19" mà không cung cấp thêm ngữ cảnh (@cHHillee).
Độ chính xác: Toàn bộ quy trình (tiền huấn luyện, huấn luyện trung gian và sau huấn luyện) đều vận hành ở định dạng NVFP4 (@soumithchintala).
Sau huấn luyện (post-training): Đạt 17 triệu lượt triển khai (rollout) trong 9 ngày (@soumithchintala). Một kỹ sư nhấn mạnh các năng lực dài hạn được xây dựng "từ tỷ lệ vượt qua xấp xỉ 0%" (@anzhit).
Khả năng tùy biến là mục tiêu thiết kế: Soumith cho biết đây "có thể là một trong những chương trình mô hình hiếm hoi trong ngành có bước đánh giá điều kiện phát hành xoay quanh khả năng tùy biến". Với cùng một mức ngân sách và lượng dữ liệu cố định, ông khẳng định mô hình này có khả năng tinh chỉnh tốt hơn các giải pháp thay thế (@soumithchintala).
Khối lượng dữ liệu: Elie Bakouch dẫn bài viết cho thấy mô hình được tiền huấn luyện từ đầu trên "chỉ 12 nghìn tỷ token". Con số này có thể bao gồm cả giai đoạn huấn luyện trung gian; số liệu do chính nhóm công bố cho giai đoạn chính là 8,4 nghìn tỷ token. Ông cũng cho biết độ hỗn loạn (perplexity) của mô hình cơ sở đối với mã nguồn nội bộ thấp hơn Kimi K3.1, trong đó mô hình đối chứng đã được "khôi phục về dạng cơ sở" nhằm bảo đảm tính công bằng (@eliebakouch).
Sau đó, ông làm rõ rằng một biểu đồ tùy biến cụ thể đã sử dụng mô hình sau huấn luyện làm nền tảng để tiếp tục giai đoạn sau huấn luyện (@eliebakouch).
BPB: Nhóm nghiên cứu báo cáo chỉ số bits-per-byte ở mức thấp sau 3 ngày tiền huấn luyện (@MuCai7).
Các đánh giá độc lập
Artificial Analysis (Chỉ số Intelligence Index v5.0.1: đạt 31 điểm, tăng 18 điểm so với Inkling Small) (@ArtificialAnlys)
Các mô hình cùng phân khúc: Đạt kết quả tương đương Gemini 3.8 Flash (high) và vượt trội so với MiMo-V2.6-Pro.
Mức cải thiện so với Inkling Small:
AutomationBench-AA: 5% → 46%.
FrontierCode 2.0: 5% → 25%.
HLE-Diamond: 12% → 29%.
Năng lực lập trình so với Claude Sonnet 5.5 (medium): Hai mô hình có thế mạnh khác nhau.
Benchmark
Inkling 2 Small
Sonnet 5.5 (medium)
FrontierCode 2.0
25%
11%
Terminal-Bench 4.0
13%
30%
Tác tử sáng tạo:
Trên bài kiểm tra AA-3D, mô hình đạt điểm cao hơn Claude Haiku 5.5 và Grok 4.7.
Mô hình vượt qua Gemini 3.8 Flash trên cả hai bài kiểm tra AA-3D và Code2Video-AA, nhưng xếp sau Sonnet 5.5 ở cả hai nội dung này.
Vật lý: CritPt v2 đạt 56% (tăng từ mức 34%), so với 65% của Gemini 3.8 Flash.
AA-Omniscience: Tỷ lệ ảo giác giảm từ 61% xuống 27%. Độ chính xác tăng từ 32% lên 34%, và tỷ lệ thử trả lời giảm từ 77% xuống 53%. Mô hình đưa ra câu trả lời có chọn lọc hơn.
Lượng token sử dụng: Khoảng 150.000 token đầu ra cho mỗi tác vụ Index, so với:
Khoảng 37.000 đối với Inkling Small
Khoảng 31.000 đối với Sonnet 5.5
Khoảng 99.000 đối với Gemini 3.8 Flash
Chi phí cho mỗi tác vụ Index: 1,18 USD, so với:
0,20 USD đối với Inkling Small
7,77 USD đối với Gemini 3.8 Flash (h
Nguồn tin: Latent Space — Tác giả: swyx .ai. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.