
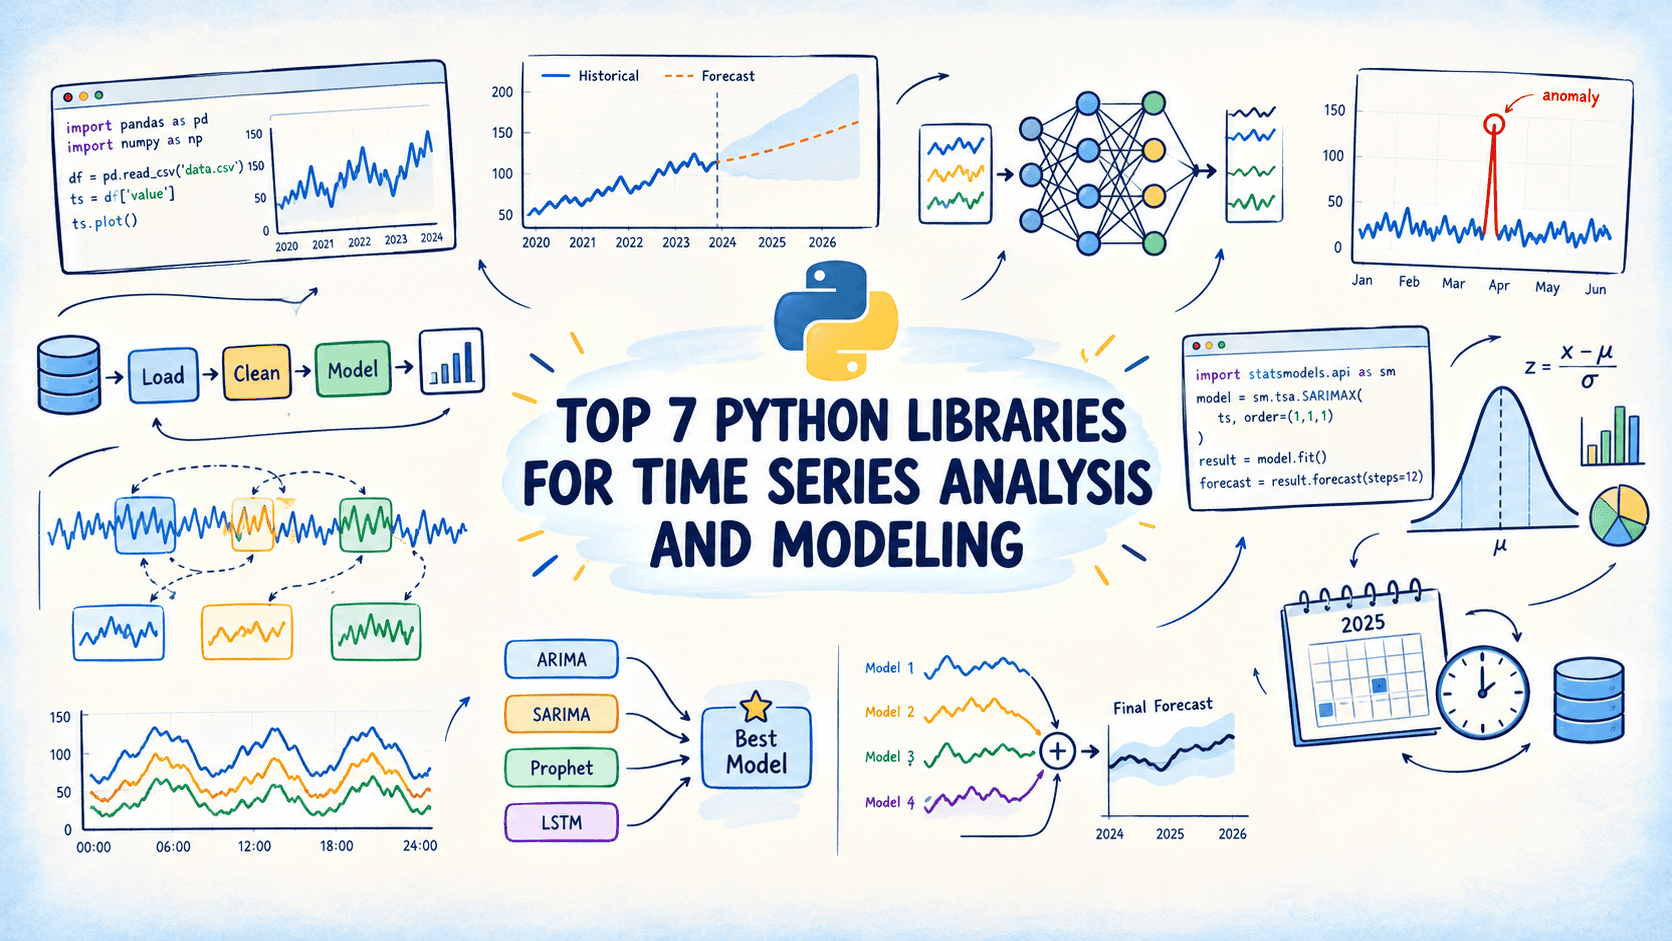
7 thư viện Python hàng đầu phục vụ phân tích và mô hình hóa chuỗi thời gian
Đối với công tác xử lý dữ liệu chuỗi thời gian, các thư viện Python này đáp ứng toàn diện các yêu cầu, từ những phương pháp dự báo truyền thống đến học sâu (deep learning) và phát hiện bất thường.
7 thư viện Python hàng đầu phục vụ phân tích và mô hình hóa chuỗi thời gian - KDnuggets
Blog
Bài viết nổi bật
Giới thiệu
Chủ đề
AI
Tư vấn nghề nghiệp
Thị giác máy tính
Kỹ thuật dữ liệu
Khoa học dữ liệu
Mô hình ngôn ngữ
Học máy
MLOps
NLP
Lập trình
Python
SQL
Tập dữ liệu
Sự kiện
Tài nguyên
Tài liệu tóm tắt
Đề xuất
Báo cáo kỹ thuật
Quảng cáo
Đăng ký nhận bản tin
7 thư viện Python hàng đầu phục vụ phân tích và mô hình hóa chuỗi thời gian
Đối với việc xử lý dữ liệu chuỗi thời gian, các thư viện Python sau đây cung cấp đầy đủ công cụ từ dự báo cổ điển đến học sâu và phát hiện bất thường.
Tác giả: Bala Priya C, Biên tập viên cộng tác và Chuyên viên nội dung kỹ thuật của KDnuggets, ngày 6/11/2026, chuyên mục Python
Mở đầu
Phân tích chuỗi thời gian sở hữu một trong những hệ sinh thái thư viện phân mảnh nhất trong Python. Tùy thuộc vào yêu cầu dự báo thống kê, xây dựng quy trình học máy (machine learning pipeline), các mô hình học sâu (deep learning) hay phát hiện bất thường, người dùng sẽ cần lựa chọn các công cụ khác nhau — mỗi công cụ có giao diện lập trình ứng dụng (API), định dạng dữ liệu và các giả định bài toán riêng biệt.
Bài viết giới thiệu 7 thư viện Python hữu ích, bao quát toàn diện các khía cạnh xử lý chuỗi thời gian, bao gồm:
Dự báo thống kê cổ điển và tự động hóa
Quy trình học máy có khả năng mở rộng quy mô và lựa chọn mô hình
Dự báo dựa trên học sâu và mô hình tổ hợp (ensemble)
Phát hiện bất thường, phân tích dữ liệu ngoại lai và phát hiện mẫu hình (motif)
Dưới đây là thông tin chi tiết.
1. Xây dựng mô hình dự báo thống kê với statsmodels
Khi khả năng diễn giải có tầm quan trọng tương đương độ chính xác của dự báo, statsmodels là lựa chọn hàng đầu. Đây là nền tảng của phân tích chuỗi thời gian cổ điển trong Python, ứng dụng các mô hình thống kê chủ lực trong các lĩnh vực kinh tế, tài chính và nghiên cứu vận hành suốt nhiều thập kỷ qua.
Những ưu điểm nổi bật của statsmodels:
Hỗ trợ toàn diện họ mô hình ARIMA, bao gồm ARIMA và SARIMAX cho dữ liệu có tính mùa vụ và các biến hồi quy ngoại sinh; kết quả đầu ra cung cấp khoảng tin cậy, chỉ số tiêu chuẩn thông tin Akaike (AIC), tiêu chuẩn thông tin Bayes (BIC) và các biểu đồ chẩn đoán
Cung cấp các mô hình làm mịn hàm mũ qua ETSModel, bao gồm các thành phần xu hướng và mùa vụ theo dạng cộng tính hoặc nhân tính
Tích hợp các kiểm định thống kê phục vụ chẩn đoán tiền mô hình: kiểm định Augmented Dickey-Fuller và kiểm định KPSS để đánh giá tính dừng, cùng kiểm định Ljung-Box nhằm phát hiện hiện tượng tự tương quan của phần dư
Tài liệu tham khảo: Tài liệu Phân tích chuỗi thời gian của statsmodels và các ví dụ minh họa statsmodels
2. Tự động hóa lựa chọn mô hình với pmdarima
Xác định bậc ARIMA phù hợp — gồm các tham số (p, d, q) — là một trong những công đoạn phức tạp và tốn thời gian nhất trong dự báo cổ điển. pmdarima giải quyết vấn đề này bằng cách đưa tính năng auto.arima của ngôn ngữ R sang Python, đóng gói statsmodels ở tầng dưới và tự động hóa quy trình lựa chọn mô hình.
Những tính năng then chốt của pmdarima:
auto_arima thực hiện tìm kiếm từng bước (stepwise) qua các bậc ARIMA tiềm năng, đánh giá dựa trên điểm AIC hoặc BIC mà không cần phân tích thủ công biểu đồ tự tương quan và tự tương quan riêng phần
Tuân thủ giao diện fit/predict chuẩn của scikit-learn, giúp dễ dàng tích hợp vào các quy trình scikit-learn hiện có
Tự động kiểm định tính mùa vụ trước khi bổ sung các tham số SARIMA, hạn chế rủi ro áp đặt cấu trúc mùa vụ khi dữ liệu thực tế không có đặc tính này
Lưu ý: pmdarima là công cụ phù hợp để thiết lập mô hình đối chứng thống kê nhanh chóng hoặc thực hiện dự báo tự động trên nhiều chuỗi dữ liệu. Kho lưu trữ GitHub của thư viện này cho thấy tiến độ phát triển đã chậm lại trong các phiên bản gần đây; do đó, người dùng cần kiểm tra nhật ký thay đổi trước khi đưa thư viện vào quy trình vận hành sản xuất mới.
Tài liệu tham khảo: tài liệu kỹ thuật pmdarima và tài liệu hướng dẫn người dùng pmdarima.
3. Xây dựng quy trình học máy thống nhất với sktime
sktime cung cấp một giao diện thống nhất cho các tác vụ học máy trên chuỗi thời gian — bao gồm dự báo, phân loại, hồi quy, phân cụm và chú thích dữ liệu — trải rộng từ các phương pháp thống kê cổ điển, học máy đến học sâu. Do đó, thư viện này giải quyết tình trạng phân mảnh trong hệ sinh thái xử lý chuỗi thời gian của Python như đã đề cập ở phần đầu bài viết.
Những ưu thế giúp sktime trở thành công cụ quan trọng trong xử lý chuỗi thời gian:
Giao diện nhất quán giữa các bộ ước lượng, giúp việc chuyển đổi giữa mô hình ARIMA, mô hình hồi quy tăng cường độ dốc (gradient boosting) và mạng nơ-ron chỉ đòi hỏi thay đổi lượng nhỏ mã nguồn.
Khả năng xây dựng mô hình kết hợp — bao gồm thiết lập quy trình liên hoàn (pipelining), học kết hợp (ensembling), tinh chỉnh và rút gọn — nhằm liên kết các khâu tiền xử lý và dự báo thành một quy trình duy nhất có thể tái lập.
Cơ chế kiểm định chéo chuyên biệt cho chuỗi thời gian tuân thủ trật tự thời gian, giúp ngăn chặn hiện tượng rò rỉ dữ liệu vốn thường xảy ra khi áp dụng các phương pháp kiểm định chéo thông thường cho dữ liệu tuần tự.
Giao diện kết nối trực tiếp với các thư viện liên quan, bao gồm scikit-learn, statsmodels, tsfresh và PyOD.
sktime là thư viện tối ưu khi quy trình làm việc đòi hỏi tính hệ thống, khả năng tái lập và sự thuận tiện trong việc so sánh giữa các nhóm mô hình khác nhau. Độc giả có thể tham khảo bài viết "Xây dựng các mô hình học máy chuỗi thời gian với sktime trong Python" (Building Time-Series Machine Learning Models with sktime in Python) để nắm bắt các nội dung thực hành cơ bản.
Tài liệu tham khảo: tài liệu kỹ thuật sktime và các ví dụ trên sktime Notebook.
4. Dự báo quy mô lớn với Darts
Darts tiếp cận theo hướng một bộ công cụ toàn diện hơn so với sktime. Thay vì thống nhất phương thức truy cập vào các thuật toán từ những thư viện khác, Darts trực tiếp triển khai các mô hình cổ điển, học máy và học sâu, đồng thời chú trọng vào việc dự báo xác suất và xử lý quy mô đa chuỗi.
Những đặc tính nổi bật của Darts:
Cung cấp dự báo xác suất trên hầu hết các mô hình, trả về các khoảng dự đoán thay vì ước tính điểm đơn lẻ.
Huấn luyện một mô hình tổng thể duy nhất trên các tập hợp lớn chuỗi dữ liệu liên quan trong cùng một thời điểm, thay vì phải áp dụng riêng từng mô hình cho mỗi chuỗi.
Tích hợp quy trình kiểm thử ngược (backtesting) nhằm mô phỏng các dự báo theo dữ liệu lịch sử trên nhiều khung thời gian.
Cung cấp mô-đun phát hiện điểm bất thường, cho phép chuyển đổi các mô hình dự báo hoặc mô hình lọc thành các bộ phát hiện, hoặc áp dụng trực tiếp các phương pháp chấm điểm theo chuẩn PyOD vào chuỗi thời gian.
Darts cũng sở hữu danh mục mô hình phong phú trong cùng một gói phần mềm, trải rộng từ phương pháp làm mịn hàm mũ (exponential smoothing), ARIMA, hồi quy tăng cường độ dốc đến nhiều kiến trúc học sâu


Nguồn tin: KDnuggets — Tác giả: Bala Priya C. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.