
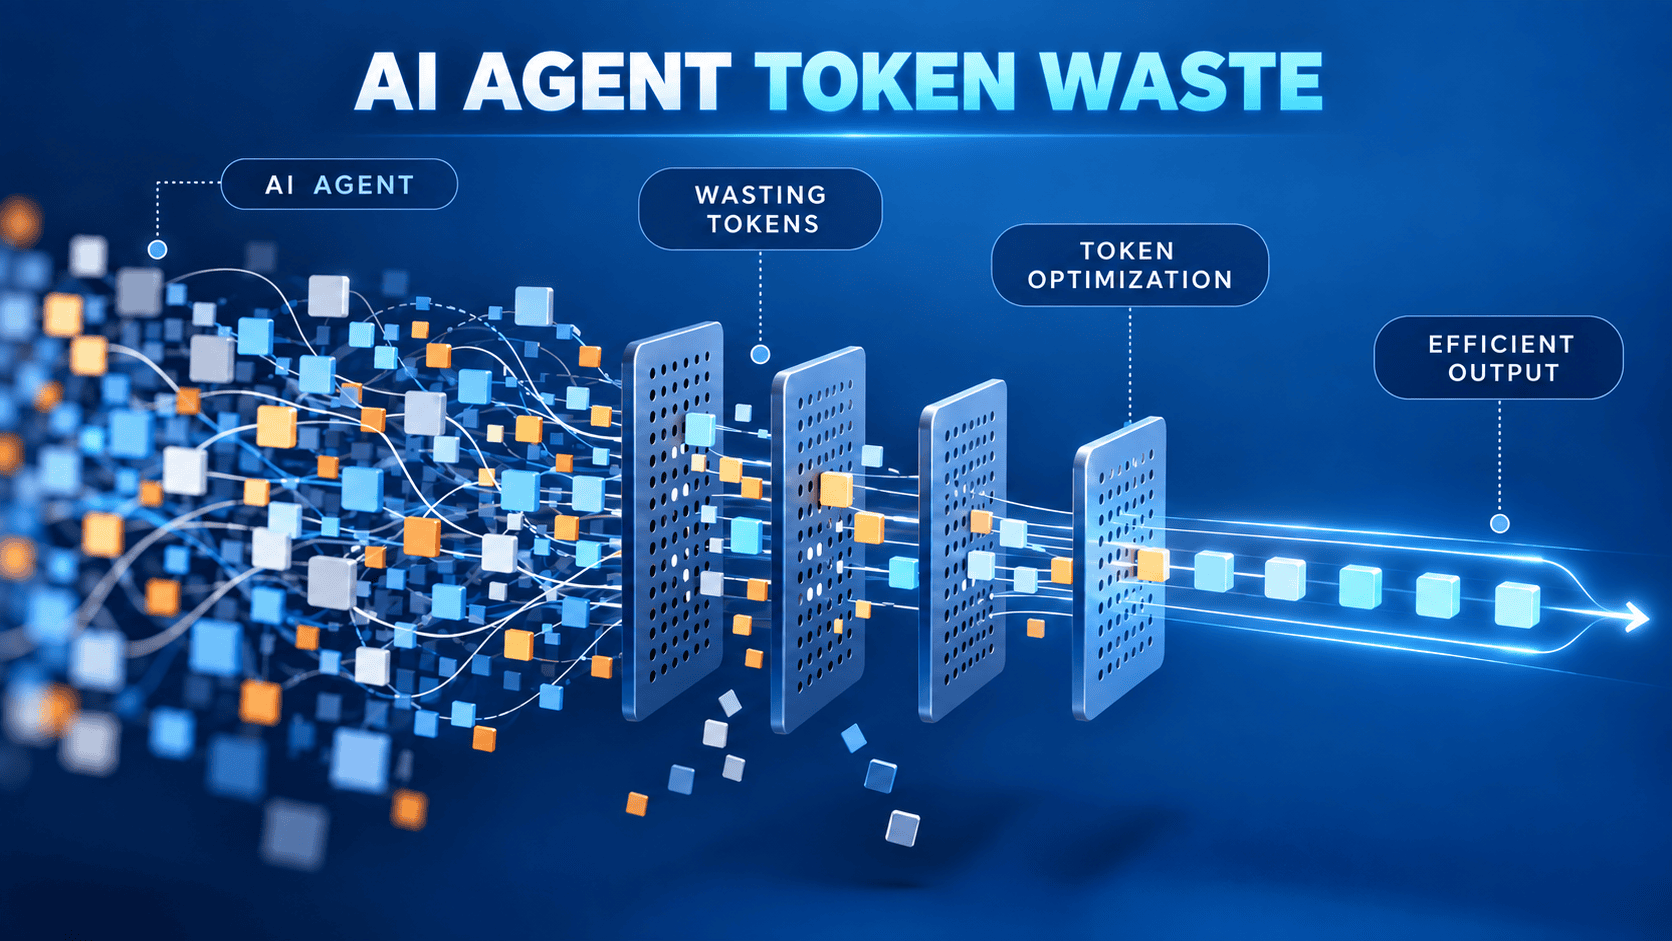
7 nguyên nhân khiến AI agent gây lãng phí token (và giải pháp thay thế)
Bài viết này phân tích bảy dạng lãng phí token phổ biến trong các hệ thống AI agent ở môi trường vận hành thực tế (production), cùng các giải pháp kiến trúc tương ứng nhằm khắc phục từng vấn đề. Các chủ đề được...
Bảy phương thức gây lãng phí token trong hệ thống AI agent và các giải pháp thay thế
Tác giả: Vinod Chugani, ngày 30/10/2026, chuyên mục Trí tuệ nhân tạo 0
Chia sẻ
Đăng bài
Chia sẻ
Bài viết phân tích bảy mô hình gây lãng phí token phổ biến trong các hệ thống AI agent đang vận hành thực tế, cùng các giải pháp kiến trúc nhằm khắc phục từng vấn đề.
Các nội dung trọng tâm bao gồm:
Tác động tiêu cực của việc xem cửa sổ ngữ cảnh (context window) như một hệ thống lưu trữ dữ liệu chính thức (system of record) đối với chi phí và độ trễ, cùng phương án xử lý bằng cơ chế cửa sổ trượt và tóm tắt ngữ nghĩa.
Thực trạng kết quả công cụ chưa qua nén, sự phình to của cấu trúc lược đồ (schema) tĩnh và các mô hình truy xuất giản đơn làm suy giảm ngân sách token.
Phương pháp ứng dụng cơ chế ngắt mạch (circuit breaker), tiền tố câu lệnh (prompt prefixing), định tuyến phân tầng (cascaded routing) và định dạng đầu ra có ràng buộc nhằm xây dựng kiến trúc agent ổn định về mặt chi phí.
Mở đầu
Việc xây dựng một mô hình agent thử nghiệm trong thời gian ngắn là bài toán không phức tạp. Tuy nhiên, việc kiểm soát chi phí API không tăng phi mã sau ba tháng vận hành lại là một thách thức lớn. Cách tiếp cận giản đơn trong thiết kế kiến trúc agent — liên tục nối thêm mọi tin nhắn của người dùng, dữ liệu quan sát và phản hồi nội bộ vào một mảng dữ liệu không ngừng mở rộng — sẽ làm tăng độ trễ suy luận theo hàm bậc hai và gia tăng chi phí token theo tuyến tính ở mỗi lượt gọi. Cốt lõi của hạn chế này bắt nguồn từ việc xem cửa sổ ngữ cảnh như một hệ thống lưu trữ dữ liệu.
Nhiều kỹ sư thường bỏ qua một ranh giới quan trọng: Ngữ cảnh là khối lượng token tạm thời được truyền tải qua mạng trong mỗi yêu cầu. Trong khi đó, trạng thái là cấu trúc đại diện lâu dài, đã được tuần tự hóa, phản ánh tiến trình hoạt động của agent. Việc đồng nhất hai khái niệm này đồng nghĩa với việc hệ thống phải chi trả chi phí truy xuất cơ sở dữ liệu trên từng lượt gọi suy luận.
Tài liệu này tổng hợp bảy mô hình gây lãng phí token phổ biến và tốn kém nhất trong các hệ thống agent thực tế, đồng thời cung cấp các giải pháp kiến trúc tương ứng.
1. Tích lũy cửa sổ ngữ cảnh (Bẫy chỉ ghi thêm)
Sai lầm phổ biến nhất trong thiết kế agent là xem mảng câu lệnh (prompt array) như một cơ sở dữ liệu. Mọi lượt trao đổi đều được ghi thêm — từ tin nhắn của người dùng, kết quả quan sát của công cụ, quá trình suy luận trung gian cho đến phản hồi của hệ thống. Đến lượt tương tác thứ 20, agent phải đọc lại toàn bộ lịch sử vận hành trong mỗi yêu cầu, khiến chi phí tính toán cơ chế chú ý (attention) tăng theo hàm bậc hai.
Giải pháp: Triển khai cửa sổ ngữ cảnh trượt kết hợp cơ chế tóm tắt ngữ nghĩa liên tục. Hệ thống chỉ giữ nguyên văn N lượt tương tác gần nhất. Các lượt hội thoại trước đó được nén thành một bản tóm tắt bối cảnh cô đọng, đồng thời chuyển trạng thái cấu trúc của agent sang một kho lưu trữ mang tính tất định như SQLite hoặc Redis, thay vì đưa ngược các giá trị này vào câu lệnh.
Hạn chế: Quá trình tóm tắt luôn tiềm ẩn rủi ro thất thoát thông tin. Trường hợp agent cần các mã định danh UUID chính xác, mã băm mật mã hoặc các đoạn mã nguồn ở đầu phiên làm việc, việc nén ngữ nghĩa có thể dẫn đến hiện tượng suy diễn sai lệch (hallucination). Cần kết hợp mô hình này với một công cụ tra cứu khóa-giá trị (key-value) chuẩn xác để truy xuất dữ liệu nguyên bản khi cần thiết.
Thời điểm áp dụng: Đây phải là kiến trúc mặc định cho mọi agent hội thoại dài hạn hoặc các vòng lặp suy luận dự kiến vượt quá năm đến mười lượt tương tác.
2. Tiếp nhận kết quả công cụ chưa qua nén
Khi một agent gọi API của bên thứ ba, hệ thống thường nhận về gói dữ liệu JSON lồng nhau phức tạp, vốn được thiết kế cho máy móc xử lý thay vì các mô hình ngôn ngữ. Việc chuyển trực tiếp phản hồi thô đó vào ngữ cảnh quan sát là một trong những nguyên nhân lãng phí token dễ khắc phục nhất. Một gói dữ liệu webhook từ Stripe hoặc phản hồi chi tiết từ API của AWS có thể tiêu tốn hàng nghìn token, trong đó phần lớn thông tin không phục vụ quá trình suy luận của agent.
Giải pháp: Bổ sung một lớp chuyển đổi trung gian (middleware transformation layer) giữa khâu thực thi công cụ và khâu đưa ngữ cảnh vào mô hình. Lớp này có nhiệm vụ loại bỏ các giá trị rỗng (null), lọc bỏ các trường không thiết yếu và chuyển đổi định dạng JSON đa tầng thành định dạng YAML cô đọng hoặc Markdown có cấu trúc. Đối với dữ liệu nhật ký (log), một quy trình tiền xử lý tất định có thể loại bỏ mốc thời gian, định danh luồng (thread ID) và các đoạn văn bản mẫu trước khi mô hình tiếp nhận dữ liệu.
Điểm hạn chế: Việc lọc dữ liệu quá mức đôi khi có thể xóa bỏ các siêu dữ liệu (metadata) cần thiết, ví dụ như con trỏ phân trang (pagination cursor). Nếu tác tử (agent) cần phân trang qua một danh sách kết quả, việc loại bỏ trường next_token nhằm tiết kiệm một lượng nhỏ token sẽ âm thầm làm gián đoạn toàn bộ chu trình truy xuất.
Thời điểm áp dụng: Áp dụng khi tích hợp các API của bên thứ ba như Stripe, Jira, AWS — vốn là những hệ thống trả về lượng dữ liệu lớn được tối ưu hóa cho máy móc xử lý thay vì cho khả năng suy luận của mô hình ngôn ngữ.
3. Xung đột truy xuất và hiện tượng “tìm kiếm rồi đổ dồn dữ liệu” (Grep-and-Dump)
Trong các tác tử lập trình và hệ thống phụ thuộc nhiều vào RAG, một phương thức phổ biến là sử dụng tính năng khớp văn bản đơn giản để tìm nội dung liên quan, sau đó đưa toàn bộ tệp vào cửa sổ ngữ cảnh. Khi tác tử chỉ cần một hàm duy nhất, bộ điều phối lại truy xuất toàn bộ tệp dài 4.000 dòng chứa hàm đó. Về mặt truy xuất, điều này tương đương với việc phải đọc cả một cuốn bách khoa toàn thư chỉ để trả lời một câu hỏi.
Giải pháp: Chuyển sang phương thức truy xuất phân đoạn có nhận thức về cây cú pháp trừu tượng (AST). Trong quá trình lập chỉ mục, mã nguồn được phân tích cú pháp thành một biểu đồ lệnh gọi (call graph) trực tiếp. Khi tác tử tìm kiếm một hàm, bộ điều phối sẽ truy vấn chỉ mục và chỉ trả về chính xác chữ ký hàm, chuỗi tài liệu (docstring) và các thành phần phụ thuộc cấu trúc trực tiếp. Cách tiếp cận này chỉ tiêu tốn 300 token thay vì toàn bộ tệp tin. Các thư viện như Tree-sitter hỗ trợ xây dựng các bộ phân tích cú pháp nhận biết ngôn ngữ để trích xuất chính xác các đơn vị cấu trúc này.
Điểm hạn chế: Truy xuất nhận thức đồ thị đòi hỏi các quy trình lập chỉ mục không đồng bộ và liên tục. Nếu chỉ mục vector chậm hơn nhánh chính (main branch) của kho lưu trữ, tác tử sẽ suy luận dựa trên trạng thái lỗi thời, cố gắng gọi các hàm không còn tồn tại và tiêu tốn token đầu ra để xử lý các lỗi phát sinh.
Thời điểm áp dụng: Áp dụng khi phát triển tác tử lập trình, bot hỗ trợ phụ thuộc nhiều vào RAG hoặc bất kỳ hệ thống nào tương tác với các cơ sở mã nguồn có cấu trúc chặt chẽ và thay đổi liên tục.
4. Sự phình to lược đồ công cụ tĩnh (Static Tool Schema Bloat)
Phần lớn các khung tác tử hiện nay định nghĩa các lược đồ công cụ (tool schema) một lần và đưa toàn bộ các định nghĩa này vào mỗi lần gọi LLM. Đối với một hệ thống ít công cụ, điều này không gây ảnh hưởng lớn. Tuy nhiên, với một tác tử có từ 30 đến 50 công cụ, mô hình sẽ phải đọc hàng nghìn token định nghĩa lược đồ trong mỗi yêu cầu — bao gồm cả những lược đồ hoàn toàn không liên quan đến giai đoạn thực hiện tác vụ hiện tại.
Giải pháp: Triển khai cơ chế tinh giản công cụ dựa trên ngữ cảnh, được điều phối bởi một máy trạng thái hữu hạn (finite state machine). Trạng thái vận hành hiện tại của tác tử sẽ quyết định các công cụ nào được đưa vào. Một tác tử ở trạng thái “khám phá” (discovery) sẽ nhận
Nguồn tin: Machine Learning Mastery — Tác giả: Vinod Chugani. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.