
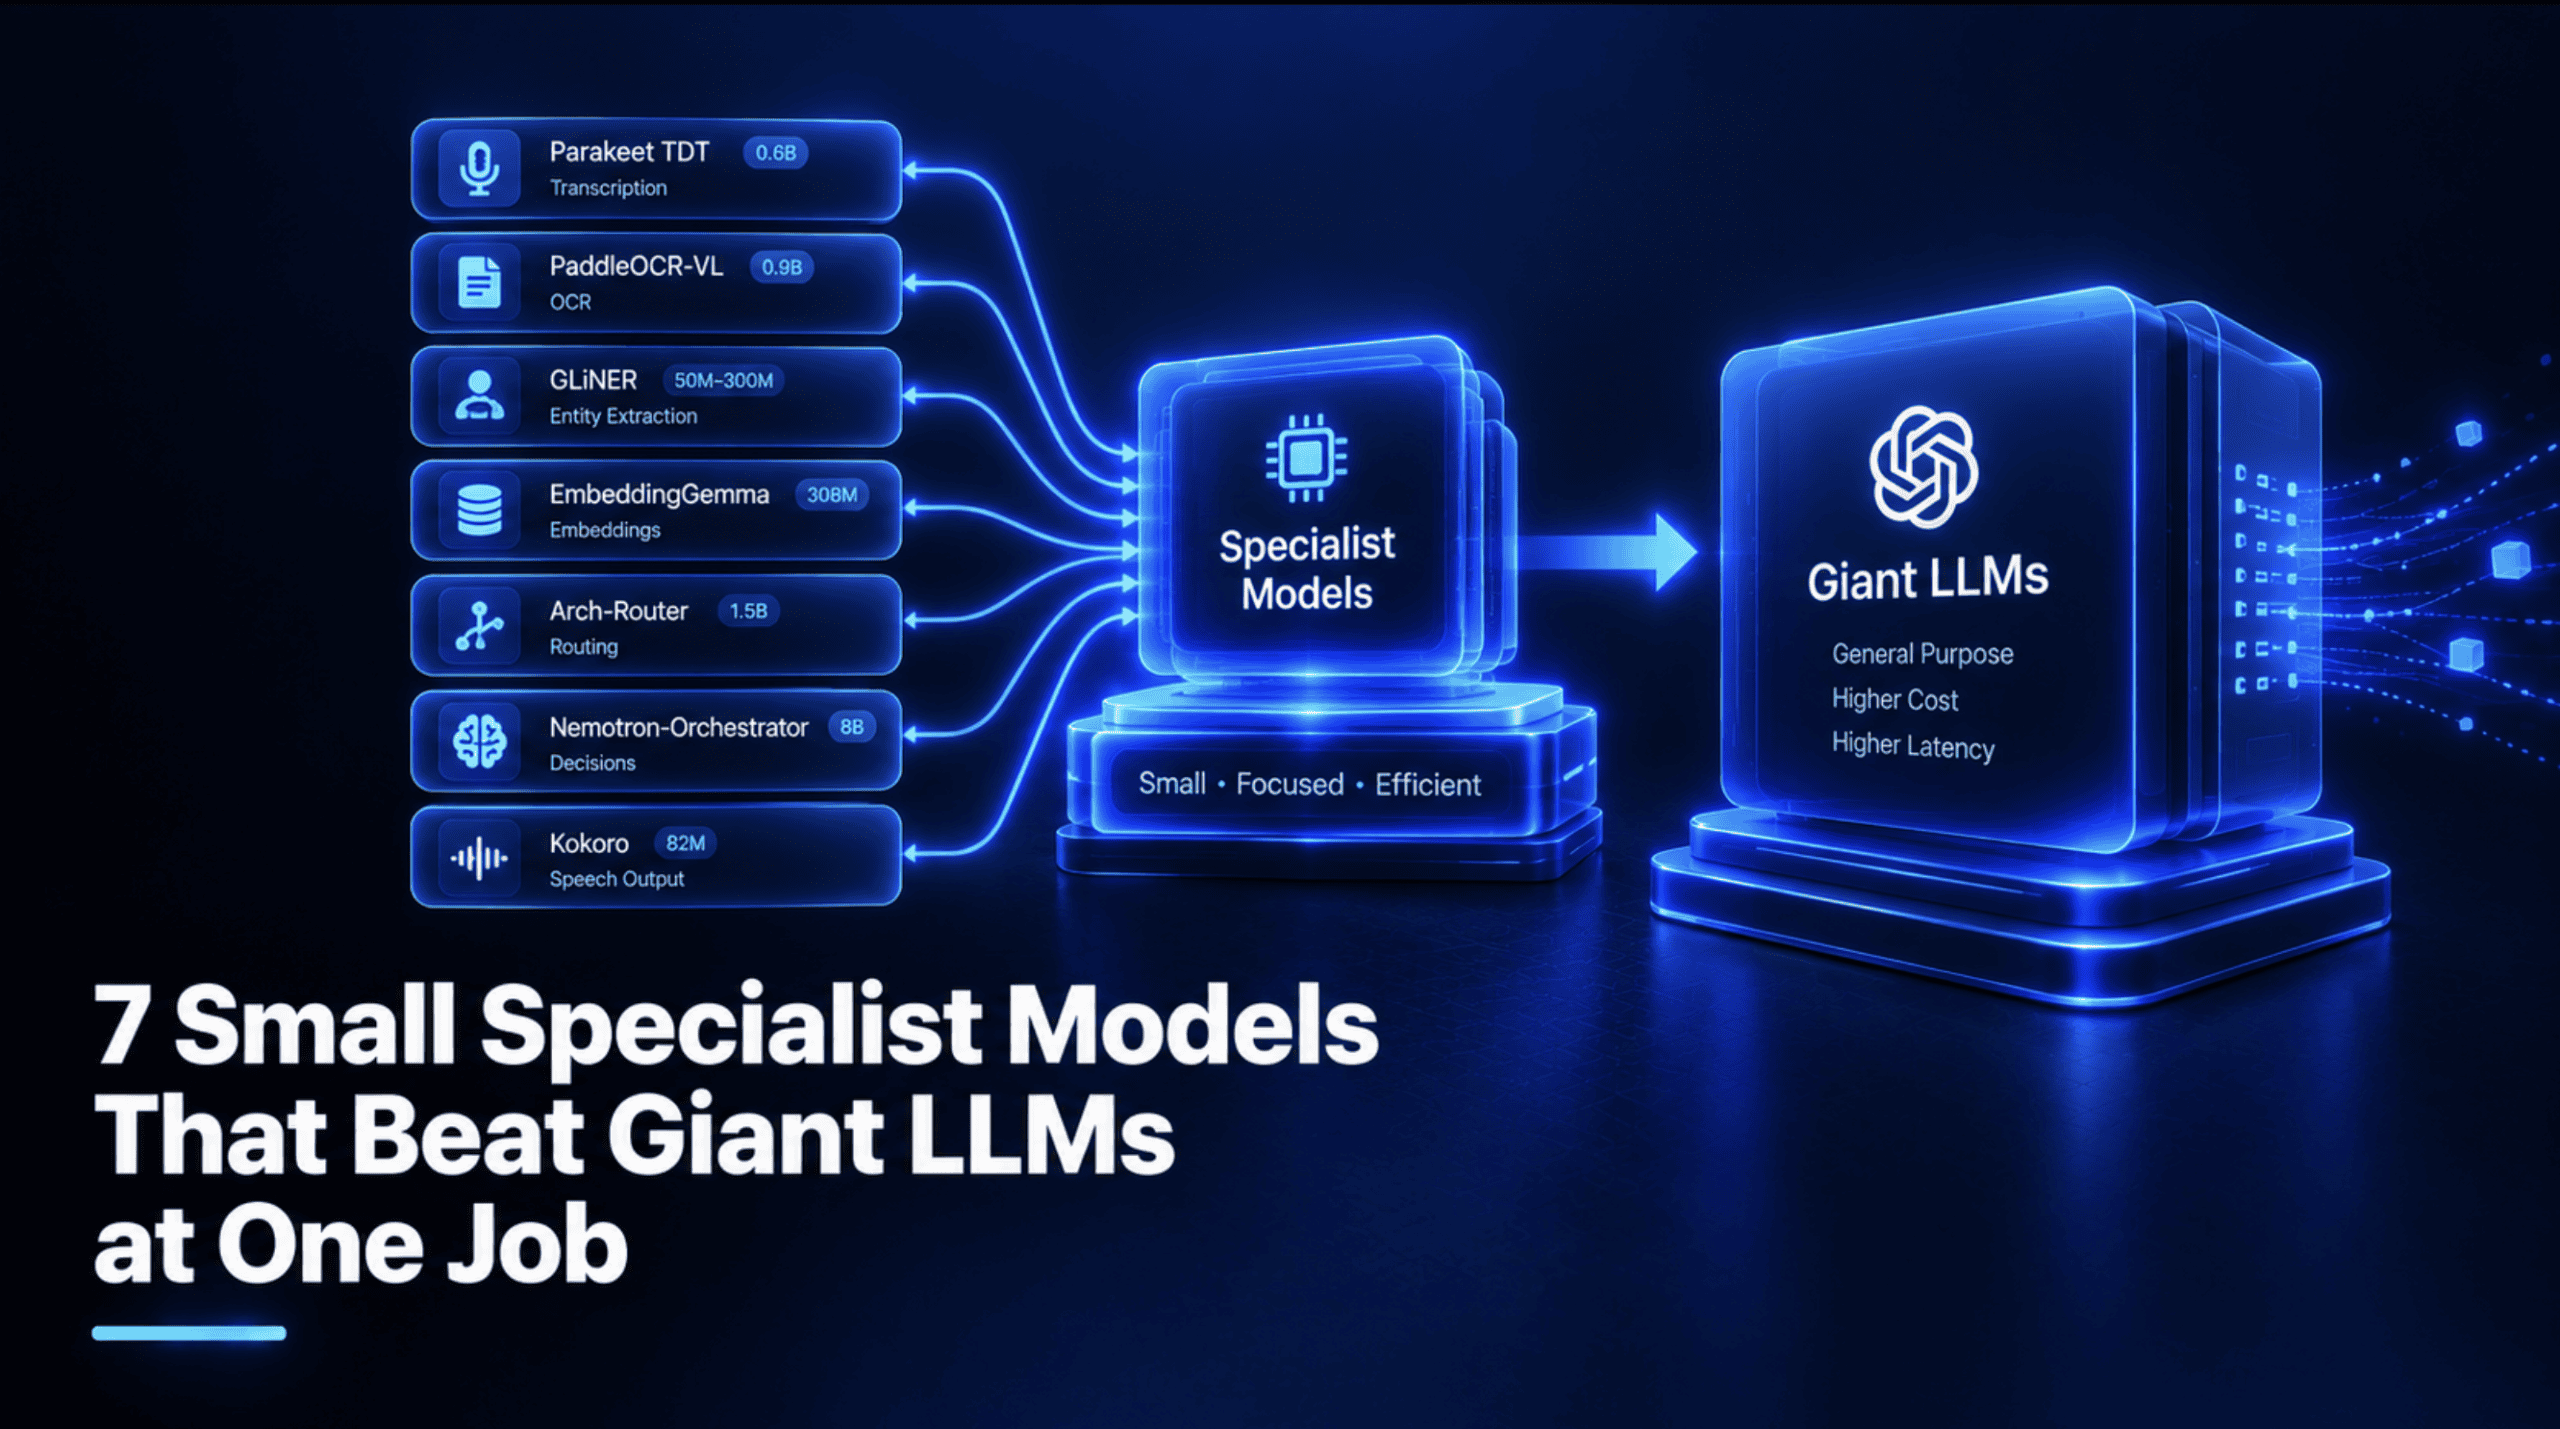
7 mô hình chuyên biệt quy mô nhỏ vượt trội các LLM khổng lồ ở một tác vụ cụ thể
Bảy mô hình chuyên biệt mã nguồn mở dưới 10 tỷ tham số có năng lực cạnh tranh tương đương các hệ thống quy mô lớn hơn ở từng tác vụ cụ thể, từ phiên âm và OCR đến định tuyến và xử lý tiếng nói.
7 mô hình chuyên biệt quy mô nhỏ vượt trội các LLM khổng lồ ở một tác vụ cụ thể - KDnuggets
Nhật ký điện tử (Blog)
Bài viết hàng đầu
Giới thiệu
Chủ đề
AI
Tư vấn nghề nghiệp
Thị giác máy tính
Kỹ thuật dữ liệu
Khoa học dữ liệu
Mô hình ngôn ngữ
Học máy
MLOps
Xử lý ngôn ngữ tự nhiên (NLP)
Lập trình
Python
SQL
Tập dữ liệu
Sự kiện
Tài nguyên
Tài liệu tóm tắt (Cheat Sheets)
Khuyến nghị
Báo cáo tóm tắt kỹ thuật
Quảng cáo
Đăng ký nhận bản tin
7 mô hình chuyên biệt quy mô nhỏ vượt trội các LLM khổng lồ ở một tác vụ cụ thể
Khám phá bảy mô hình chuyên biệt mã nguồn mở dưới 10 tỷ tham số có năng lực cạnh tranh với các hệ thống quy mô lớn hơn nhiều ở từng tác vụ riêng biệt, từ phiên âm, OCR đến điều hướng tác vụ và tạo tiếng nói.
Tác giả: Shittu Olumide, Chuyên viên Nội dung Kỹ thuật, ngày 04/11/2026, chuyên mục Mô hình ngôn ngữ
Xét một quy trình hỗ trợ khách hàng được xây dựng theo cách giản tiện nhất: một mô hình khổng lồ đảm nhiệm việc phiên âm cuộc gọi, đọc hóa đơn đính kèm, trích xuất tên cùng số tiền, chỉ định bộ phận xử lý phiếu yêu cầu và đọc lại câu trả lời cho khách hàng. Hệ thống vẫn vận hành hiệu quả, song mỗi giai đoạn đều bị tính phí theo mức giá của các mô hình tiên tiến hàng đầu (frontier models).
Hầu hết các giai đoạn này đều là các tác vụ đơn lẻ, và các mô hình chuyên biệt quy mô nhỏ được thiết kế chính xác cho mục tiêu đó. Bài viết này giới thiệu bảy mô hình mở với quy mô dưới 10 tỷ tham số, có khả năng cạnh tranh trực tiếp với các hệ thống lớn hơn nhiều trên một nhiệm vụ cụ thể. Mỗi mô hình được trình bày chi tiết về tác vụ chiếm ưu thế, kích thước, giấy phép sử dụng, bằng chứng thực nghiệm đã công bố và mã nguồn để vận hành cục bộ. Những mô hình chuyên biệt theo tác vụ này không thể thay thế hoàn toàn một mô hình ngôn ngữ lớn (LLM) đa năng khổng lồ; phần cuối bài viết sẽ làm rõ những hạn chế đó.
Tiêu chí lựa chọn bảy mô hình
Mỗi mô hình được chọn đều phải đáp ứng bốn tiêu chuẩn: trọng số mở, phục vụ một tác vụ rõ ràng, có bằng chứng thực nghiệm đã công bố chứng minh tính ưu việt trước các hệ thống lớn hơn, và kích thước đủ gọn để vận hành trên một máy đơn lẻ. Khái niệm "khổng lồ" không chỉ giới hạn ở "LLM đối thoại". Khi bằng chứng đối chiếu với một mô hình tổng quát lớn hơn, tác giả sẽ nêu rõ. Tương tự, nếu kết quả đối chiếu với một API đóng hoặc một mô hình chuyên biệt có kích thước lớn hơn, thông tin đó cũng được ghi nhận cụ thể.
Tổng quan về bảy mô hình
STT
Tác vụ
Mô hình
Quy mô
Giấy phép
Hệ thống bị vượt qua
1
Phiên âm
Parakeet TDT 0.6B v3
0,6 tỷ (0.6B)
CC-BY-4.0
Whisper large-v3, về độ chính xác và tốc độ
2
Nhận dạng ký tự quang học (OCR)
PaddleOCR-VL-1.6
0,9 tỷ (0.9B)
Apache 2.0
Gemini 3 Pro và GPT-5.2 trên tập đánh giá OmniDocBench v1.6
3
Trích xuất thực thể
GLiNER
50 triệu đến ~300 triệu (50M - ~300M)
Kiểm tra theo từng checkpoint
ChatGPT về nhận dạng thực thể có tên (NER) phương thức zero-shot
4
Nhúng (Embeddings)
EmbeddingGemma
308 triệu (308M)
Điều khoản Gemma
Các mô hình nhúng mở dưới 500 triệu tham số
5
Điều hướng (Routing)
Arch-Router
1,5 tỷ (1.5B)
Giấy phép Katanemo
GPT-4o và Claude-Sonnet-3.7 về khả năng điều hướng
6
Ra quyết định
Nemotron-Orchestrator-8B
8 tỷ (8B)
Giấy phép NVIDIA (chỉ dùng cho nghiên cứu)
GPT-5 trong bài kiểm tra Humanity's Last Exam
7
Tạo giọng nói
Kokoro-82M
82 triệu (82M)
Apache 2.0
Các mô hình chuyển văn bản thành giọng nói (TTS) mở quy mô lớn hơn trong các thử nghiệm nghe ẩn danh
Thiết lập môi trường
Mỗi mô hình cần được phân bổ một môi trường ảo riêng biệt. Do các ngăn xếp công nghệ sử dụng các phiên bản PyTorch và thư viện liên quan khác nhau, việc tích hợp đồng thời NeMo, Paddle và vLLM trong cùng một môi trường rất dễ dẫn đến xung đột phần mềm.
# Thiết lập một môi trường cho từng mô hình, ví dụ đối với mô hình đầu tiên
python -m venv parakeet-env
source parakeet-env/bin/activate # Trên Windows: parakeet-env\Scripts\activate
Có hai mô hình yêu cầu các thao tác bổ sung. EmbeddingGemma thuộc diện cấp quyền hạn chế (gated), do đó cần chấp thuận giấy phép trên trang thông tin của mô hình và thực hiện đăng nhập một lần:
from huggingface_hub import login
login() # dán mã truy cập (access token) của Hugging Face khi có yêu cầu
Kokoro yêu cầu gói hệ thống espeak-ng (sử dụng lệnh sudo apt-get install espeak-ng trên hệ điều hành Ubuntu hoặc brew install espeak-ng trên macOS), theo thông tin ghi nhận trên trang GitHub của dự án.
Lệnh gọi hàm login() thực hiện lưu trữ mã xác thực nhằm phục vụ việc tải các mô hình có điều kiện tiếp cận trong các lần tiếp theo mà không yêu cầu xác thực lại. Mỗi mô hình sẽ tải về tệp trọng số trong lần khởi chạy đầu tiên, do đó tiến trình này cần thời gian xử lý ban đầu.
Dưới đây là tổng quan về bảy mô hình được vận hành theo quy trình: đầu vào tiếng nói, đầu vào tài liệu, trích xuất dữ liệu, tìm kiếm, định tuyến, ra quyết định và đầu ra tiếng nói.
1. Parakeet TDT 0.6B v3: Chuyển đổi giọng nói thành văn bản (Transcription)
Quy mô và bản quyền: 600 triệu tham số, giấy phép CC-BY-4.0, hỗ trợ 25 ngôn ngữ châu Âu kèm tính năng tự động nhận diện ngôn ngữ, theo bảng thông tin mô hình.
Minh chứng thực nghiệm: Báo cáo từ bảng xếp hạng Open ASR Leaderboard ghi nhận Parakeet v3 đạt tỷ lệ lỗi từ (WER) trung bình 6,32% so với 7,44% của Whisper large-v3; tốc độ xử lý đạt 3.330 so với 146 (chỉ số RTFx, chỉ số càng cao tốc độ càng nhanh). Tốc độ này nhanh hơn khoảng 23 lần và ghi nhận ít lỗi hơn. Một báo cáo tổng hợp chỉ ra rằng kích thước của Parakeet chỉ bằng một phần tư so với Whisper large-v3. Cần lưu ý, kết quả vượt trội này được ghi nhận khi so sánh với một mô hình xử lý tiếng nói quy mô lớn hơn, không phải mô hình ngôn ngữ lớn (LLM) phục vụ hội thoại.
Triển khai thực thi:
pip install -U "nemo_toolkit[asr]"
import nemo.collections.asr as nemo_asr
# Tải mô hình trong lần chạy đầu tiên; tài liệu khuyến nghị dung lượng RAM khả dụng tối thiểu 2 GB
asr_model = nemo_asr.models.ASRModel.from_pretrained(
model_name="nvidia/parakeet-tdt-0.6b-v3"
)
# Cung cấp danh sách các tệp âm thanh; mô hình yêu cầu định dạng âm thanh đơn kênh (mono) tần số 16 kHz
output = asr_model.transcribe(["meeting.wav"])
print(output[0].text)
# Thêm tham số timestamps=True để nhận thông tin mốc thời gian chi tiết theo từng từ
# output = asr_model.transcribe(["meeting.wav"], timestamps=True)
Hàm from_pretrained tiến hành tải điểm kiểm tra (checkpoint) từ Hugging Face và khởi tạo mô hình. Hàm transcribe tiếp nhận đầu vào dạng danh sách, cho phép xử lý đồng thời nhiều tệp tin trong một lần gọi lệnh; mỗi kết quả trả về chứa trường .text lưu trữ nội dung văn bản. Dòng lệnh được đặt trong dấu ghi chú thể hiện tùy chọn mốc thời gian theo tài liệu hướng dẫn của mô hình.
Hạn chế: Whisper hiện hỗ trợ 99 ngôn ngữ, vượt trội so với 25 ngôn ngữ của Parakeet. Dữ liệu bảng xếp hạng ghi nhận vào tháng 10/2026 cho thấy Parakeet dẫn trước ở tiếng Anh (tỷ lệ lỗi 5,66% so với 6,5%), song xếp sau Whisper ở 5 trên 6 ngôn ngữ châu Âu khác được theo dõi.
2. PaddleOCR-VL-1.6: Nhận dạng ký tự quang học (OCR)
Quy mô và bản quyền: 0,9 tỷ tham số, phát hành ngày 28/5/2026 theo bảng thông tin mô hình, và được phân loại theo giấy phép Apache 2.0 trong một tổng hợp về công nghệ OCR vào tháng 9/2026.
Minh chứng thực nghiệm: Theo công bố khoa học về PaddleOCR-VL-1.6, điểm đánh giá tổng thể của mô hình trên bộ dữ liệu OmniDocBench v1.6 đạt 96,33 điểm, vượt qua mức 92,91 điểm của Gemini 3 Pro và 86,59 điểm của GPT-5.2. Một mô hình quy mô 0,9 tỷ tham số đã ghi nhận kết quả cao hơn hai hệ thống hàng đầu về tác vụ phân tích tài liệu.
Triển khai thực thi:
# Bản cài đặt cho GPU hỗ trợ CUDA 12.6 theo hướng dẫn của mô hình (sử dụng bản CPU từ tài liệu cài đặt Paddle nếu không có GPU)
python -m pip install paddlepaddle-gpu=


Nguồn tin: KDnuggets — Tác giả: Shittu Olumide. Bản dịch tiếng Việt do AI thực hiện, có thể có sai sót.